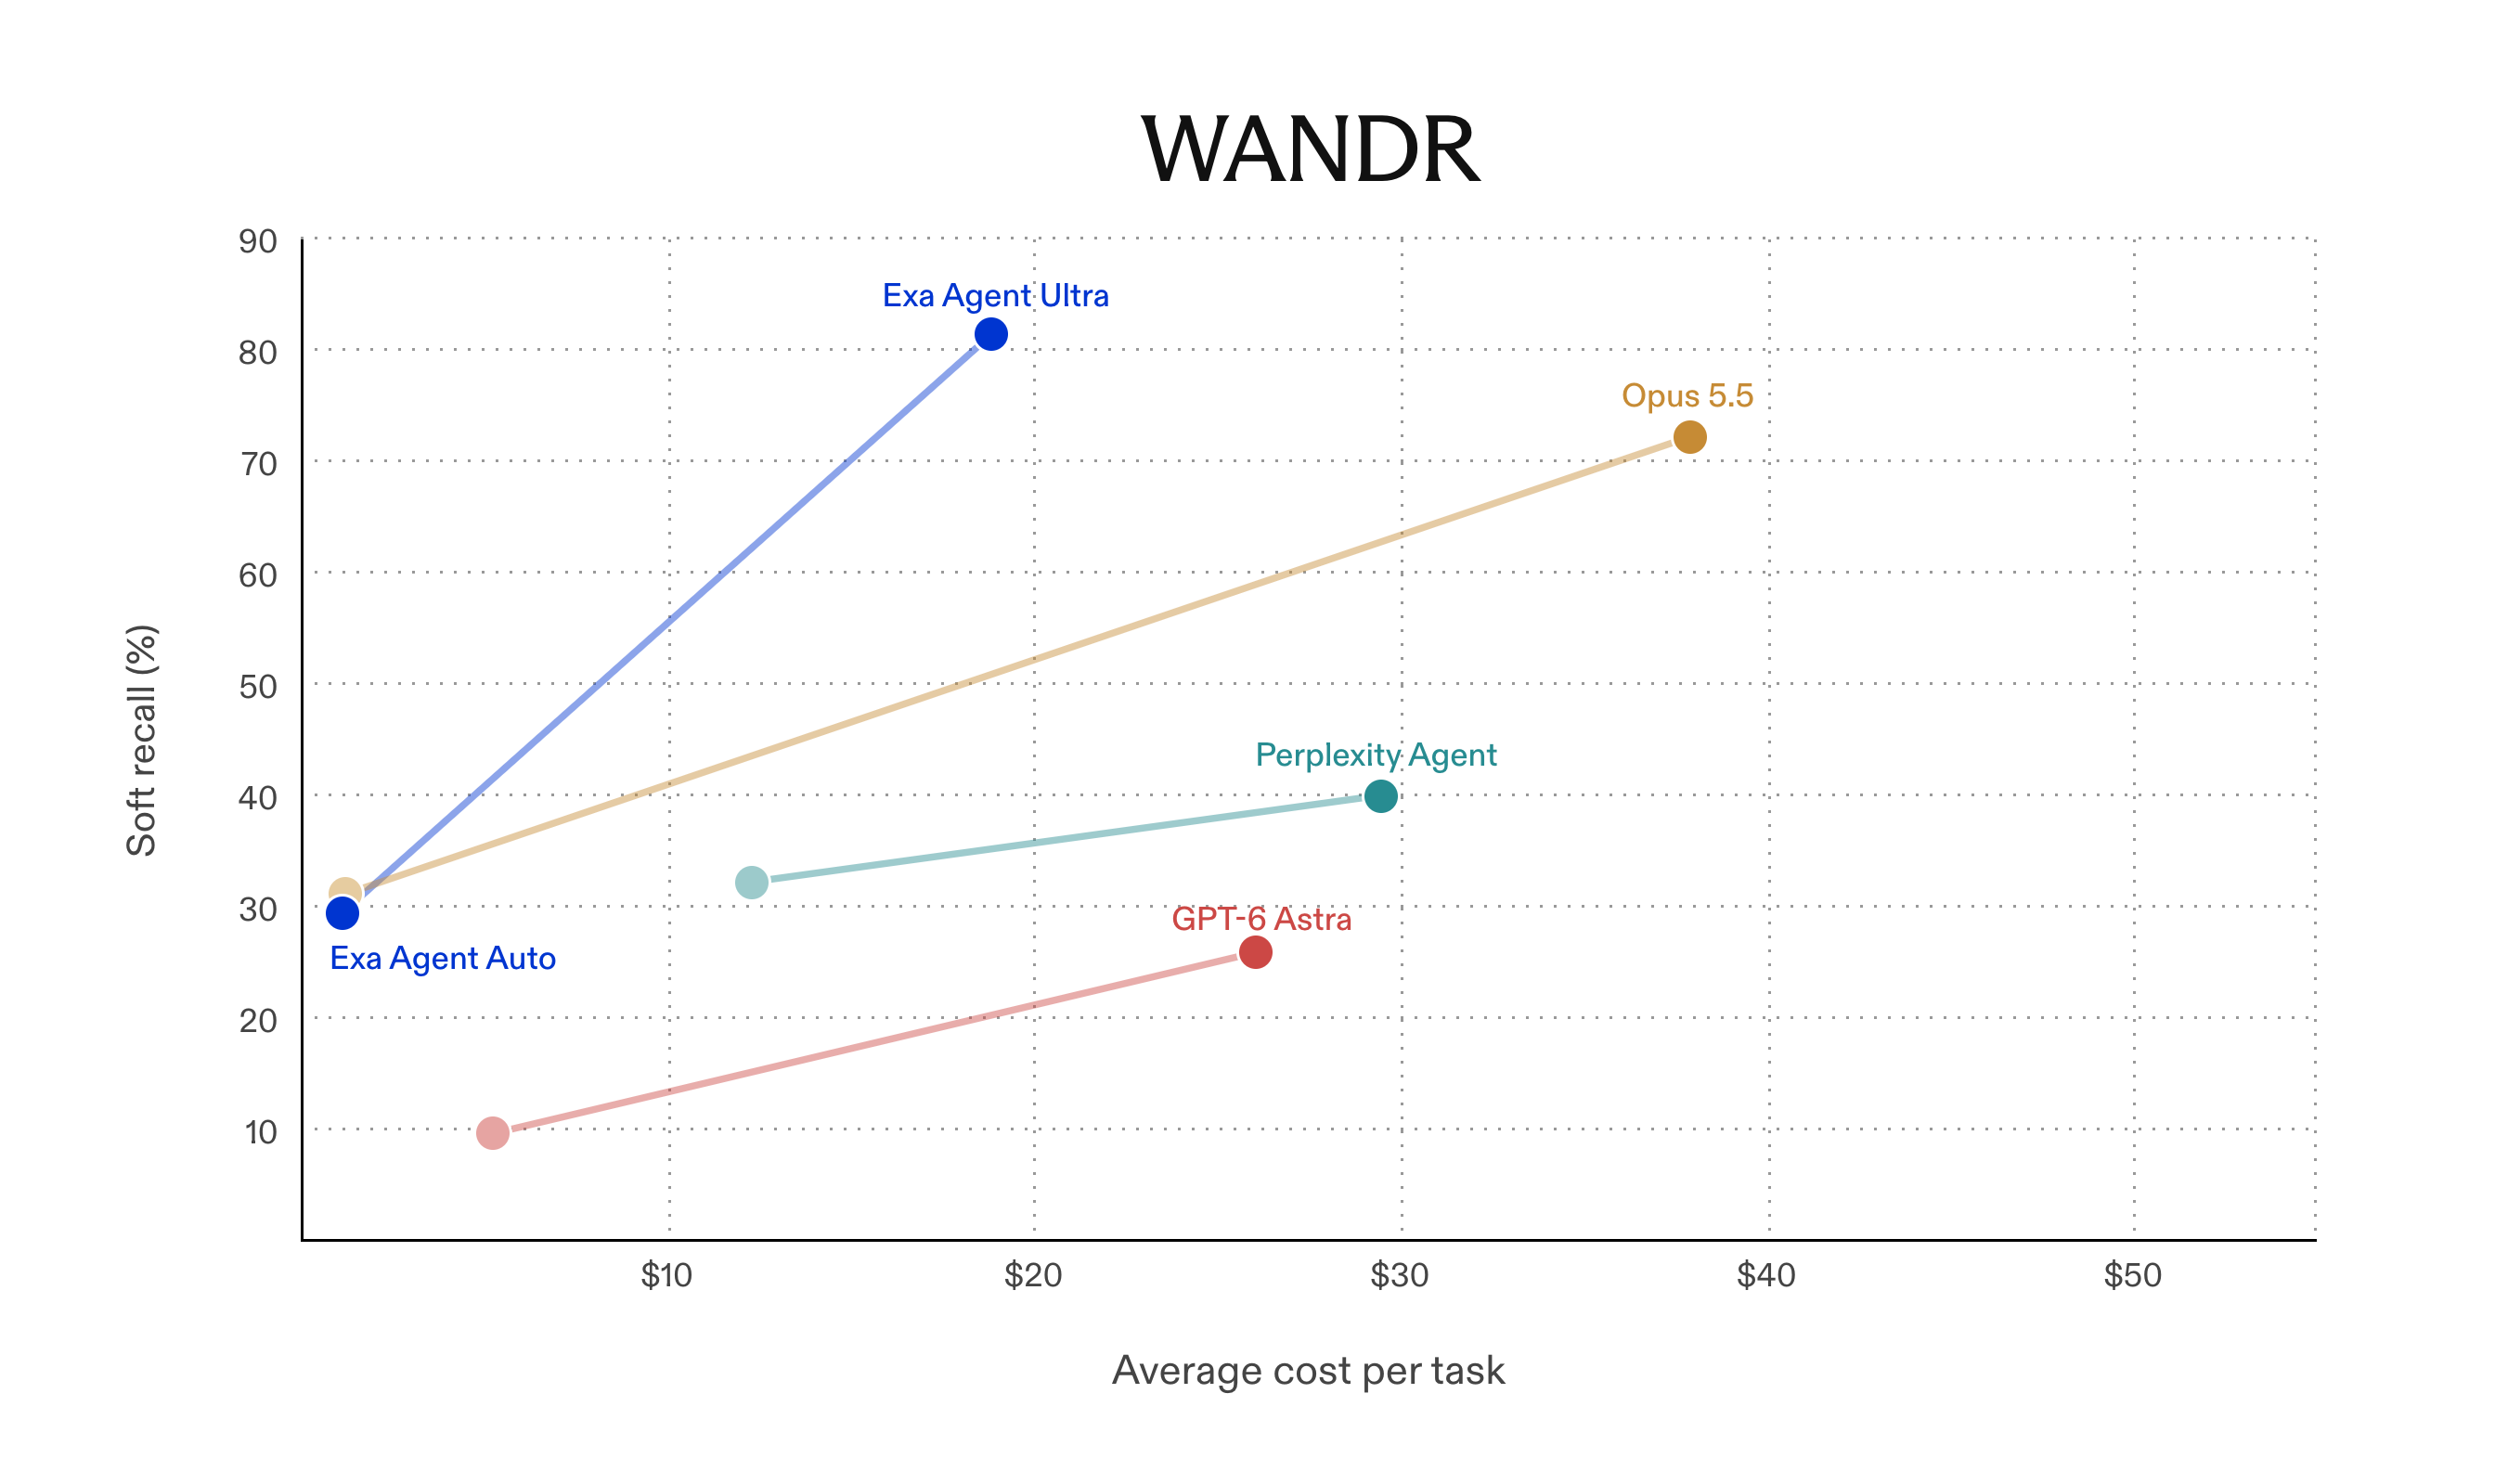





이 조합의 모델 비용은 GPT-6 Astra의 컴퓨터 제어 방식보다 약 112배, 스크린샷 기반 방식보다 약 245배 낮았습니다.
Jev만 브라우저를 직접 조작했을 때는 49개 중 25개만 성공했지만, WebMCP를 붙이자 49개 모두 성공했습니다.
화면을 보고 버튼 위치를 찾아 하나씩 클릭하는 대신, 웹사이트가 ‘상품 검색’, ‘예약’ 같은 기능을 AI에게 도구로 직접 제공하는 방식입니다.
에이전트 경쟁에서 모델 성능만큼 웹사이트와 연결하는 방식이 중요해질 것 같습니다.
Choi
웹사이트가 기능을 도구로 내주면 화면을 찍어 읽고 클릭 위치를 찾는 과정이 빠집니다. 같은 Jev가 브라우저 직접 조작으로는 25개, WebMCP로는 49개를 풀었습니다.
지시를 얼마나 잘 따르는지, 긴 프로젝트를 얼마나 안정적으로 수행하는지를 더 많이 보도록 바뀌면서 모든 모델 점수가 내려갔습니다.
Fable 5.1이 가장 높은 성능을 보였고, Muse Spark 1.3은 GPT-5.6 Sol과 비슷한 성능을 내면서 비용은 40% 이하라는 평가를 받았습니다.
Grok 4.6은 이전보다 낮아졌고 GPT-6 Astra는 이번 평가에 포함되지 않았습니다.
Choi
지시 준수와 긴 프로젝트 수행을 더 많이 보자 모든 모델의 점수가 내려가, 이전 판이 이 두 능력을 충분히 재지 못했다는 것이 드러났습니다.
샤오미의 차세대 모델 MiMo-V3-Pro의 벤치마크로 추정되는 자료가 유출됐는데, 코딩 벤치마크 SWE-Bench Pro에서 72.8을 기록해 GLM 5.3과 Kimi K3를 제치고, 오퍼스 5(74.6)와 GPT-5.6 솔 맥스(75.4)를 몇 점 차이로 따라붙었습니다.
어제 오픈라우터에 무료로 풀린 익명 모델 Ox Alpha의 정체가 샤오미라는 관측도 나옵니다.
추론 흔적과 생성하는 UI가 MiMo와 닮았고, 토크나이저 버그까지 MiMo 2.5와 일치한다는 분석입니다.
실제로 샤오미는 지난 V2-Pro 때도 익명으로 먼저 풀어 검증한 뒤 공개했습니다.
스마트폰과 가전을 팔던 회사가 프런티어 모델과 몇 점 차이까지 왔습니다.
샤오미는 지난봄 API 가격을 99% 내리며 물량으로 밀었습니다.
Choi
유출 자료대로라면 MiMo-V3-Pro는 SWE-Bench Pro에서 오퍼스 5(74.6)에 몇 점 뒤진 72.8을 냈고, 샤오미는 지난봄 API 가격을 99% 내린 회사입니다.
‘우리 회사 업무에 맞는 AI 모델’을 직접 시험하는 플랫폼입니다.
계약서 검토와 금융 에이전트, 코딩처럼 정답이 하나로 정해지지 않는 업무의 데이터와 실행 기록을 넣으면, Optima가 실제 업무를 반영한 테스트 과제와 채점 기준을 만듭니다.
이후 최신 모델들을 같은 조건에서 돌려 성능에 더해 작업당 비용과 완료 시간까지 함께 비교합니다.
목적은 리더보드 1위 대신, 우리 업무의 기준을 넘는 모델 가운데 가장 비용 효율적인 모델을 찾고 새 모델이 나올 때마다 같은 평가를 반복해 교체 여부까지 판단하는 데 있습니다.
Choi
모델 교체를 감 대신 같은 과제와 채점 기준으로 반복해서 판단할 수 있습니다. 평가 과제를 누가 만드느냐가 결과를 좌우합니다.
기존 공개 벤치마크는 모델의 전체 성능을 비교하는 데 초점이 맞춰져 있지만, Vals-Smith는 병합된 Pull Request(PR)를 실제 개발 작업으로 변환해 해당 코드베이스에서 어떤 모델이 더 잘 해결하는지 측정합니다.
공개·비공개 저장소 모두 사용할 수 있으며, 모델별 성공률과 작업별 결과를 비교할 수 있습니다.
공개된 예시에서는 저장소마다 상위 모델이 달라지는 모습도 확인할 수 있습니다.
저는 예전부터 기업들의 벤치를 과도하게 믿지 말고 자기 프로덕션에 맞는 벤치마크를 따로 만들라고 말해 왔는데, 그 구조가 도구로 나왔습니다.
Choi
공개 예시에서 저장소마다 상위 모델이 달라, 공개 벤치 순위가 내 코드베이스의 순위와 다를 수 있습니다. 병합된 PR을 그대로 과제로 써서 맞춤 벤치마크를 만드는 비용이 줄었습니다.
버셀의 오픈소스 보안 하네스 DeepSec로 돌린 자체 벤치마크에서 GPT-5.6 Sol은 분석 깊이가 가장 뛰어났지만, 2위 모델보다 비용이 7배 높았습니다.
그래서 그는 Sol로 한 번 베이스라인을 만든 뒤, 이후에는 가성비가 좋은 워크호스인 Kimi K3를 상시 운용하는 구성을 권장했습니다.
Fable 5의 거부율은 100%였습니다.
성능이 부족해서라고 하기는 어렵습니다.
6월부터 적용된 분류기가 이중용도 요청을 응답 전에 차단하면서 취약점 탐색 자체를 막기 때문입니다.
앤트로픽의 사이버 검증 프로그램 인증 없이 API를 사용하면 모든 요청이 거부로 처리되지만, 분류기가 적용되지 않은 Opus 4.8은 같은 앤트로픽 모델임에도 정상적으로 동작합니다.
Choi
Fable 5의 분류기는 이중용도 요청을 응답 전에 막아 방어용 취약점 탐색도 거부합니다. 인증 없이 API를 쓰면 모든 요청이 거부되고, 분류기가 없는 Opus 4.8은 같은 요청을 처리합니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.