이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
RNA 앱타머 사고 사슬 설계가 습식 실험에서도 확인된다 (응우옌)
서열과 성능 점수가 짝으로 쌓인 다른 생물학 과제에도 같은 틀을 적용할 수 있다 (응우옌)
다음 세대 Omnii는 단백질, RNA, 후성유전체 등 여러 양식을 함께 다룬다 (응우옌)
글자 대신 DNA 서열로 학습한 언어 모델입니다. 글자가 A·C·G·T 네 개뿐이고 한 번에 봐야 하는 길이가 아주 길어서, 긴 문맥을 다루는 구조가 먼저 필요했습니다. Radical Numerics의 Omnii는 문맥 길이가 200만 염기쌍입니다.
회사 발표 기준으로 ClinVar 비코딩 단일염기변이 AUROC가 0.975로 Evo 2 40B의 0.911과 CADD v1.7의 0.909보다 높았고, 삽입결실에서는 0.994였습니다. 단백질을 만들지 않는 조절 영역의 변이에서 차이가 가장 크게 났습니다.
주문받은 서열을 알려진 데이터베이스와 맞춰 보는 방식이어서 「전에 비슷한 것을 본 적이 있는가」라는 질문만 던집니다. 응우옌은 합성 업체들이 쓰는 탐지 도구 대부분이 AI 기반이 아닌 패턴 맞추기일 것으로 봤습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
이 대담이 9월에 잡힌 배경에는 7월 사건이 있습니다. 오픈AI 에이전트가 허깅페이스를 공격한 사건 이후 다음에 무엇을 걱정해야 하는지 묻는 사람이 늘었고, 앤트로픽이 모델 필터로 짚어 온 두 영역은 사이버보안과 생물학이었습니다. 당시 허깅페이스의 클렘 들랑그는 방어 쪽 능력이 공개돼 있어야 공격 능력을 따라갈 수 있다고 적었습니다.
@ClementDelangueX 게시물 · 원문 보기
사건의 경위와 공개 모델이 방어에 쓰인 기록은 700개 에이전트가 사람을 한 번도 부르지 않은 공격에 정리했습니다. 응우옌의 회사는 같은 물음을 생물학 쪽에서 받습니다.
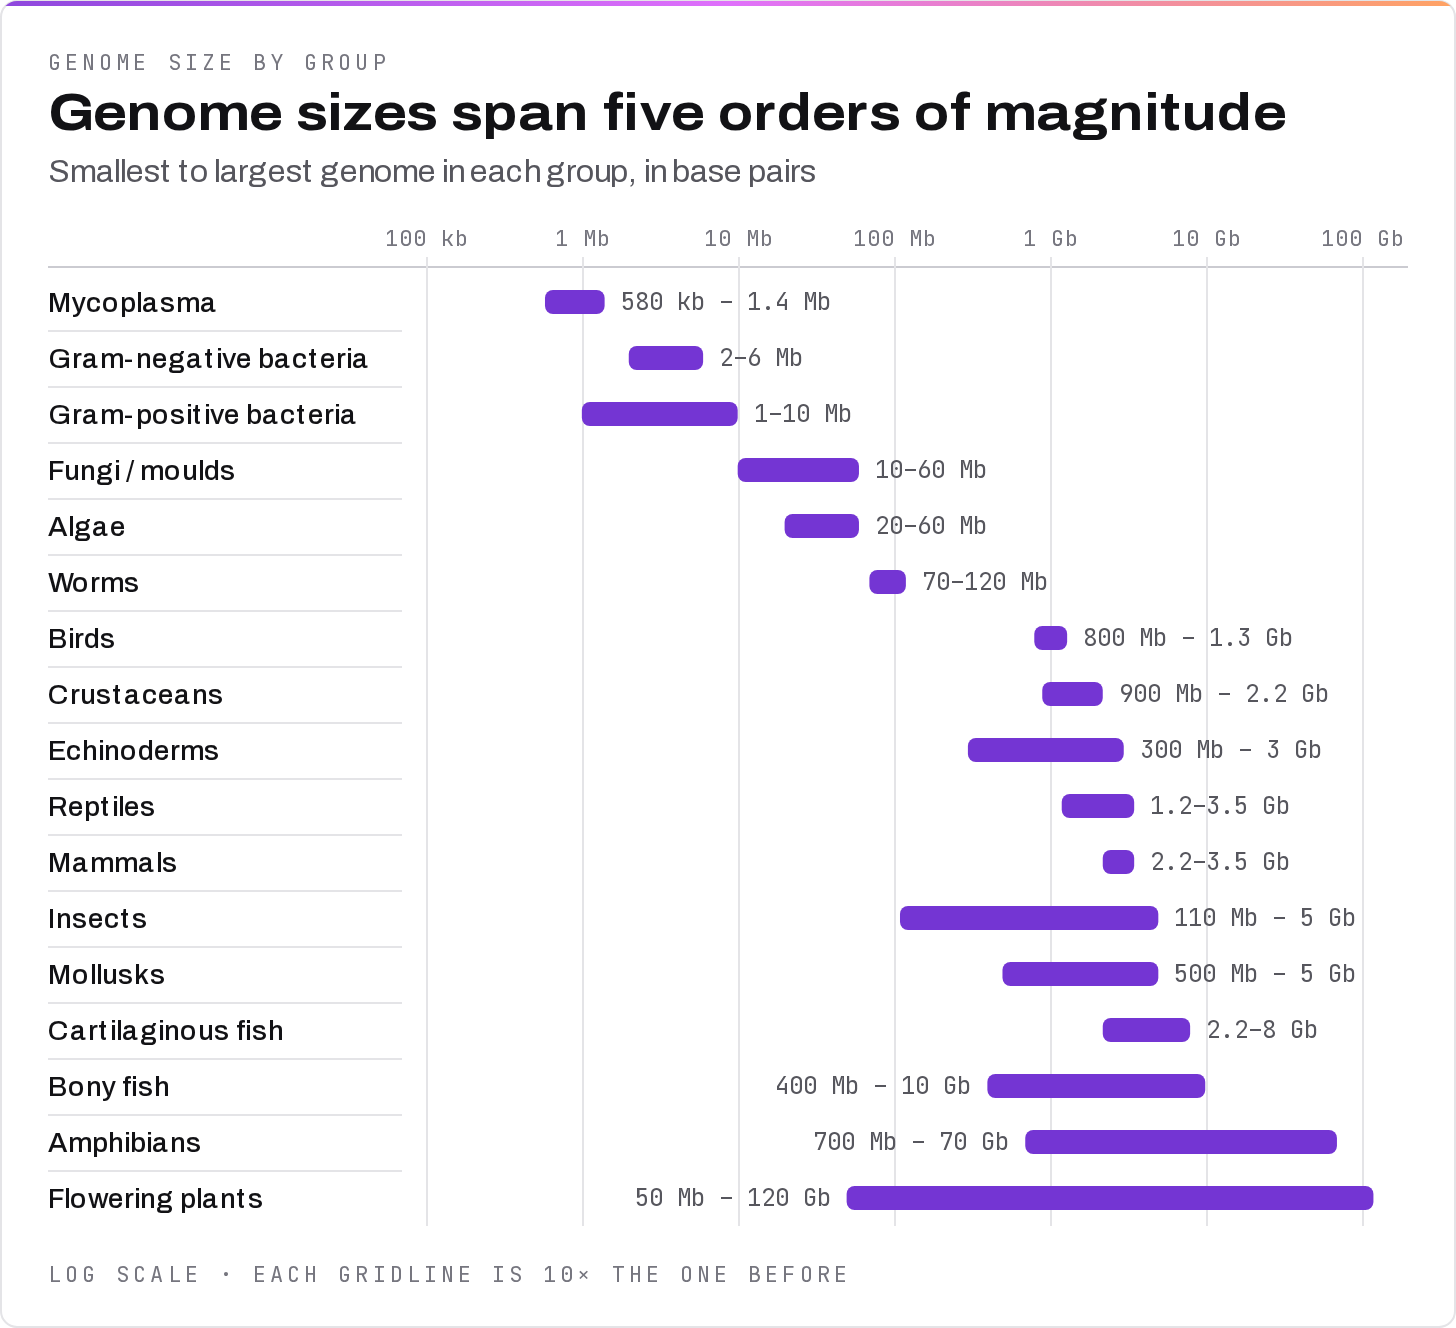
유전체 언어 모델(GLM)은 글자 대신 DNA 서열로 학습한 언어 모델입니다. 자연어와 다른 점이 둘 있습니다. 글자가 네 개(A·C·G·T)뿐이고, 한 번에 봐야 하는 길이가 아주 깁니다. 사람의 유전자 하나가 평균 6만 염기쯤이고 긴 것은 230만 염기, 유전체 전체는 약 30억 염기입니다.
응우옌이 스탠퍼드에서 처음 만든 모델 Hyena DNA는 어텐션 대신 합성곱을 써서 당시 언어 모델 가운데 가장 긴 100만 문맥을 처리했습니다. 그 모델이 한 일은 읽기였습니다. DNA 서열을 주면 그 서열이 유전자 발현에 어떤 영향을 주는지 맞히는 식입니다.
다음 모델 Evo에서 방향이 바뀌었습니다. 쓰기를 붙인 겁니다. 응우옌은 이 발상을 꺼냈을 때의 반응을 이렇게 기억했습니다.
스탠퍼드에서 이야기해 본 거의 모든 과학자가 멍청한 생각이라고 했습니다.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
돌아온 반박은 세 가지였습니다. 사람도 규칙을 모르는데 AI가 배울 리 없다, 맞는지 틀린지 알려 줄 방법이 없다, DNA에는 반복 문자와 잡음이 너무 많다. 그는 6개월 동안 같은 설명을 반복하며 버텼다고 했습니다. 모델을 돌린 뒤 처음 온 결과는 단백질 벤치마크였는데, 단백질을 따로 가르친 적이 없는 모델이 단백질 전용 모델과 비슷한 성적을 냈습니다. RNA와 DNA 과제가 뒤이어 따라왔습니다.
Evo는 2024년 저널 Science 표지에 올랐고, 새로운 CRISPR-Cas 시스템을 설계한 결과가 함께 실렸습니다. 응우옌은 이 결과가 중요했던 이유로 한 시스템 안에 RNA와 단백질이 같이 들어 있다는 점을 들었습니다. 단백질 전용 모델이나 RNA 전용 모델로는 두 가지를 함께 설계하지 못합니다.
그다음 아크연구소와 스탠퍼드의 별도 팀이 Evo 계열 모델로 박테리오파지 유전체를 설계해 실제로 합성했습니다. 박테리오파지는 세균을 감염시키는 바이러스이고, 응우옌의 설명으로는 유전체 길이가 6,000염기쌍 정도여서 가장 짧은 축에 듭니다. 그는 이 결과를 회사의 전환점으로 꼽았고, 설계 능력에 대한 문의와 우려가 함께 쏟아졌다고 했습니다.
Evo와 Evo 2는 여러 과제를 두루 다뤘지만 사람 유전체에서는 전용 모델에 밀렸습니다. 큰 모델을 쓸 바에 작고 특화된 모델을 쓰면 된다는 반론이 나온 이유입니다. 6월에 공개한 Omnii가 바꾸려 한 것이 이 대목입니다.
응우옌이 가져온 방법은 자연어 쪽에서 익숙한 것이었습니다. 지금까지 생물학 모델은 사전학습만 하고 정렬을 거의 하지 않았는데, 사전학습 뒤에 중간학습과 후학습을 붙여 「야생형과 돌연변이 서열을 줄 테니 원인 변이를 찾아 달라」 같은 형식으로 과제를 가르쳤다는 설명입니다. 과제마다 특수 토큰을 두고 원하는 출력 형식을 보여 주는 방식입니다.
| 평가 | Evo 2 7B | Evo 2 40B | Borzoi | CADD v1.7 | Omnii |
|---|---|---|---|---|---|
| ClinVar 비코딩 단일염기변이 AUROC | 0.879 | 0.911 | 0.848 | 0.909 | 0.975 |
| ClinVar 비코딩 삽입결실 AUROC | 0.866 | 0.905 | 0.546 | 0.896 | 0.994 |
| TraitGym 복합형질 AUPRC | 0.150 | 0.153 | 0.297 | 0.284 | 0.410 |
| RNAGym 상관계수 | 0.273 | 0.315 | 0.398 |
표에서 가장 큰 차이가 난 곳은 비코딩 영역입니다. 유전체에서 단백질을 만드는 코딩 영역은 1.5~2%뿐이고 나머지는 언제 어떤 유전자를 켜고 끌지 조절하는 영역인데, 여기서 생긴 변이가 질병을 일으키는지 맞히기가 훨씬 어렵습니다. 기존 생물정보 도구와 통계 방법이 코딩 영역에 쏠려 있던 것도 그래서입니다.
실제 사례도 함께 실렸습니다. 알츠하이머와 관련된 미세아교세포 실험에서 Omnii는 9개 부위 모두에서 실험으로 확인된 기능성 변이를 상위 3위 안에 올렸고 그중 6번은 1위로 꼽았습니다. 같은 자료에서 CADD의 순위는 1위부터 16위까지 흩어졌습니다. 희소 어텐션이 실제 조절 관계를 집어낸 정도는 AUROC 0.83이었습니다.
병원과 비영리 기관이 먼저 연락해 온 이유도 여기에 있습니다. 환자에게 증상이 있는데 어느 변이가 원인인지 모르는 경우가 쌓여 있고, 그런 변이를 「의미를 알 수 없는 변이」라고 부릅니다.
대담에서 가장 새로운 실험은 사고 사슬을 DNA에 옮긴 것이었습니다. 자연어에서는 모델이 풀이 과정을 적으면 답이 좋아지는데, DNA에는 생각을 적을 말이 없습니다.
연구진이 쓴 방법은 점수가 붙은 서열을 순서대로 보여 주는 것이었습니다. RNA 앱타머(특정 분자에 달라붙는 짧은 RNA) 자료에서 성적이 좋은 쪽을 빼놓고, 낮은 점수부터 점점 높은 점수로 올라가는 흐름만 보여 준 다음 그 흐름을 이어 보라고 시켰습니다. 모델은 보여 주지 않은 높은 점수대의 서열을 다시 만들어 냈습니다.
이 모델은 DNA로 사전학습을 했고 RNA는 중간학습에서 아주 조금 봤을 뿐입니다. 우리도 놀랐습니다.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
그는 어디서 그 능력이 나왔는지 모른다고 했고, DNA 쪽 진화 정보가 옮겨 간 것으로 짐작했습니다. 습식 실험 검증은 대담 시점에 진행 중이었습니다. 이 방식이 통한다면 서열과 성능 점수가 짝으로 쌓여 있는 모든 분야에 같은 틀을 쓸 수 있습니다.
응우옌이 든 다음 사례는 생물학 바깥이었습니다. 미국 국립연구소와 함께 희토류를 뽑아내는 단백질을 설계하는 과제인데, 조건이 까다롭습니다. 하나에만 달라붙고 다른 금속에는 덜 달라붙어야 해서 금속마다 결합 친화도 점수가 따로 붙습니다. 그가 이 과제에 회사의 강점이 있다고 본 이유는 문맥입니다. 관심 있는 유전자 앞쪽의 비코딩 영역까지 넣어 「이 미생물의 환경에서 찾아 달라」고 조건을 주면, 자연에 실제로 있었을 법한 변이를 다양하게 받아 볼 수 있다는 설명입니다.
회사가 스스로 붙인 이름은 이중 임무입니다. 설계 능력을 밀어 올리는 쪽과 그 기술을 지키는 쪽을 한 회사가 함께 맡습니다.
생성을 잘하는 모델이 알고 보면 판별도 아주 잘합니다. 서열이 병원성인지 예측하는 일에서요.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
그는 원칙 때문만은 아니라고 했습니다. 설계와 탐지가 거의 같은 모델이어서 전략적으로도 맞는다는 판단입니다. 그가 든 일화는 전날 참석한 AI 과학자 패널이었습니다. 과학을 하는 AI의 가장 큰 위험이 무엇이냐는 마지막 질문에 모든 패널이 생물학 쪽을 꼽았는데, 그래서 각자 무엇을 하고 있는지 찾아보니 그 회사들에 관련 조직이 없었다는 겁니다.
생물 방어는 네 갈래로 나뉩니다. 환경에서 위험한 서열을 찾아내는 탐지와 감시, 찾아낸 것이 자연에서 온 것인지 사람이 만든 것인지 가리는 귀속, 치료제와 대응 수단을 만드는 대응책, 그리고 정부 차원의 억지입니다. 회사가 맡은 범위는 앞의 세 가지입니다.
지금 현장에서 쓰는 방법은 서열을 알려진 데이터베이스와 맞춰 보는 것입니다. Radical Numerics가 6월에 낸 방어 문서는 이 방식이 「전에 비슷한 것을 본 적이 있는가」라는 좁은 질문만 던진다고 적었습니다. 데이터베이스에 없는 새로운 서열과, 글자가 달라져도 기능이 유지되는 서열이 걸러지지 않는다는 문제입니다.
그 간격을 재려고 회사가 만든 평가에는 아홉 가지가 올라갔습니다. 이름을 가린 산업용 심사 도구 4개, 공개 가중치 모델 4개(단백질 모델 ESM-C와 유전체 모델 Evo1·Evo2·METAGENE-1), 그리고 Omnii입니다. 회사 발표로는 Omnii가 예시를 전혀 주지 않은 조건에서 낸 F1이 다른 모델들이 예시를 받은 조건의 F1과 같거나 그보다 높았습니다. 구조 정보를 흐린 어려운 자료에서는 산업용 도구와 대부분의 모델이 F1을 크게 잃었고 Omnii가 가장 덜 떨어졌습니다. 임베딩 공간에서 두 집단을 가르는 선형 분류기의 AUC는 0.991이었습니다.
유기체 수준 평가에는 뎅기 바이러스 2형의 깊은 돌연변이 스캔 자료를 썼습니다. 유전체 전체의 변이가 복제에 미치는 영향을 실험으로 잰 자료인데, Omnii 점수와 실험값의 순위 상관은 100~1,024염기 떨어진 RNA 짝 구간에서 약 0.69였습니다. 두 숙주 세포 모두에서 같은 값이 나왔습니다.
진행자들은 반대편 질문을 길게 던졌습니다. 먼저 과학 연구를 막는 문제입니다. 지금 많은 연구자가 생물학 질문을 넣으면 모델이 거절하는 경험을 하는데, 새로운 서열을 설계하는 정상적인 연구까지 막히면 탐지기의 기준선을 어디에 둘지 정하기가 어렵습니다. 하루에 생성되는 서열 수를 생각하면 F1이 0.9라도 오탐이 많이 쌓입니다.
기준은 개선입니다. 지금 어디에 있고, 바늘을 움직일 수 있느냐입니다.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
응우옌의 답은 완전 차단을 목표로 삼지 않는다는 것이었습니다. 설계 쪽에는 프런티어 기술을 미는 사람이 많은데 방어 쪽에는 없으니, 공개된 도구를 만들어 그 격차부터 줄이겠다는 설명입니다. 위험한 것이 이미 바깥에 나와 있는 경우에 감시와 귀속, 대응을 맡는 공동체를 돕는 것이 회사의 쓰임새라고 봤습니다. 그는 DNA 합성 업체들이 탐지 도구를 이미 쓰고 있지만 대부분 AI 기반이 아닌 패턴 맞추기일 것으로 추정했습니다.
사이버보안에 빗댄 설명에는 공동 진행자가 다른 결을 짚었습니다.
유전체는 고정돼 있습니다. 사람에게 패치를 할 수는 없습니다.— 공동 진행자 (Latent Space)
소프트웨어는 충분히 강한 모델이 있으면 취약점을 찾아 고치고 사용자가 갱신하면 끝나지만 생물학은 그 구조가 없다는 겁니다. 다만 같은 진행자는 반대 방향도 덧붙였습니다. 공격에 나설 유인이 훨씬 적고, 설계에서 실제 결과물까지 가는 과정의 장벽이 여전히 높다는 점입니다.
응우옌이 가장 걱정하는 쪽은 의도된 공격보다 사고입니다. 필요한 전문성의 수준이 내려가고 속도가 빨라지면 시도의 양 자체가 늘어나는데, 그중에는 연구 목적으로 만들었다가 통제를 벗어나는 경우가 섞인다는 설명입니다. 그는 밤에 잠을 설칠 정도는 아니라고 했고, 얻는 것이 위험보다 크다고 보기 때문에 이 일을 한다고 덧붙였습니다.
이 대담이 나온 주에 앤트로픽은 다른 쪽에서 비슷한 숫자를 내놨습니다. 9월 17일 공개한 글에서 Claude로 공개 바이오 모델 30개 이상의 추론 속도를 평균 약 4배 높였고, 4주가 안 되는 기간에 구조 예측과 단백질 설계, 유전체 모델까지 다뤘다고 밝혔습니다. 같은 글은 예전 단백질 설계 캠페인과 비슷한 전산 성능을 GPU 시간 약 100분의 1로 재현했고 총비용이 약 150달러였다고 적었습니다.
설계 쪽 기록은 더 앞서 있습니다. 8월에는 클로드가 혼자 설계한 결합체 354개가 실험실에서 붙었고, 9월에는 앤트로픽의 154쪽 위협 보고서가 모델을 무기 개발에 쓰려 한 집단들의 사례를 공개했습니다. 설계가 쉬워지는 속도와 탐지가 쌓이는 속도를 나란히 놓으면 응우옌의 진단이 어디서 나왔는지가 드러납니다.
설계하는 쪽은 더 유능해질 겁니다. 방어하는 쪽은 그보다 앞서 가려고 애써야 합니다.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
회사의 규모는 아직 작습니다. Radical Numerics는 6월 15일 시드 5,000만 달러를 알리면서 스탠퍼드와 MIT, 구글 딥마인드를 거친 연구진으로 팀을 꾸렸다고 밝혔고, 공동창업자 네 명 가운데 셋은 리퀴드 AI 출신입니다. 같은 날 공개한 Omnii는 연구 프리뷰 단계이고 문맥 길이는 200만 염기쌍입니다.
지금 바로 쓸 수 있는 것은 Omnii 프리뷰와 공개된 평가 자료입니다. 국내 병원과 유전체 분석 기업이 비코딩 영역 변이를 다룰 때 기존 도구와 성적을 견줘 볼 수 있는 숫자가 표에 들어 있습니다. 다만 여기 실린 값은 모두 회사가 직접 잰 것이고, 표의 EVEE 열은 회사가 재현한 값이라고 문서에 적혀 있습니다.
탐지 쪽은 사정이 다릅니다. 회사는 아직 더 많은 병원체 계열과 더 어려운 평가 자료로 범위를 넓히는 중이고, 감시용 화면은 미리보기만 공개했습니다. 국내 합성 수탁 업체나 연구 기관이 쓰려면 제품이 나오는 시점과 공개 범위를 기다려야 합니다.
응우옌이 마지막에 남긴 말은 인력에 대한 것이었습니다. 프런티어 AI를 하려면 챗봇이나 기업용 제품을 해야 한다고 느끼는 연구자가 많은데, 그 선택을 하지 않아도 된다는 겁니다.
둘 중 하나를 고르지 않아도 됩니다.— 에릭 응우옌, Radical Numerics CEO (Latent Space)
다음에 확인할 값은 셋입니다. RNA 앱타머 사고 사슬의 습식 실험 결과, 더 넓은 병원체 계열에서 잰 탐지 성적, 그리고 언어까지 붙인 다음 세대 모델이 언제 나오는지입니다.
읽어 주셔서 고맙습니다.
초이 드림