이 글 어땠어요?
웹사이트가 상품 검색이나 예약 같은 기능을 AI가 부를 수 있는 도구로 직접 내주는 방식입니다. 에이전트는 화면을 보고 버튼을 누르는 대신 그 도구를 함수처럼 부릅니다.
윈드터널에서 같은 모델끼리 비교하면 WebMCP가 컴퓨터 사용 방식보다 7~15배 쌌습니다. Jev와 Mercury 2.5처럼 싼 모델까지 쓰면 Astra의 컴퓨터 사용보다 약 240배 쌌습니다.
사이트가 도구를 내줘야 쓸 수 있습니다. 윈드터널에서도 결제 도구를 추가하기 전까지는 WebMCP 설정 모두가 결제 과제를 실패했습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
뉴욕시의회가 10월 5일 AI 4사 정책 책임자를 선서시키고 에이전트가 안전장치를 늘 지키느냐고 물었지만 보장한 회사는 없었습니다. 회사를 떠난 연구자 3명도 증언했고, 의회는 제3자 검증·신고 보상 법안 10건을 심사했습니다.
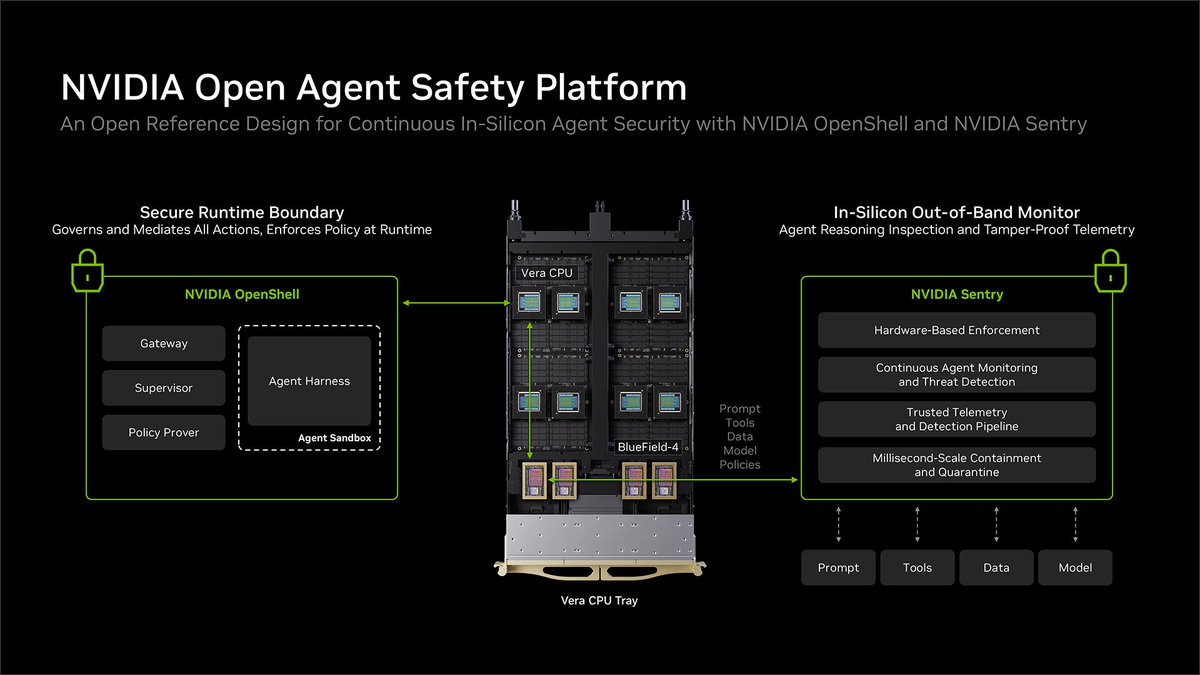
엔비디아가 9월 28일 Open Agent Safety Platform을 공개했습니다. 자체 실험에서 AI 심사관은 416번 결정 가운데 한 번 속았지만 바깥의 집행 장치가 막았고, 정책 증명기는 아직 MCP·GraphQL 규칙을 검사하지 못합니다.
오픈AI가 9월 29일 DevDay에서 20개 넘는 발표로 주간 사용자 12억 명의 ChatGPT를 사람과 에이전트의 공용 공간으로 열었습니다. 마이크로소프트가 Copilot을 새로 짠 지 4일, 앤트로픽이 Claude Marketplace를 연 지 6일 만입니다.
뉴욕시의회가 10월 5일 AI 4사 정책 책임자를 선서시키고 에이전트가 안전장치를 늘 지키느냐고 물었지만 보장한 회사는 없었습니다. 회사를 떠난 연구자 3명도 증언했고, 의회는 제3자 검증·신고 보상 법안 10건을 심사했습니다.

엔비디아가 9월 28일 Open Agent Safety Platform을 공개했습니다. 자체 실험에서 AI 심사관은 416번 결정 가운데 한 번 속았지만 바깥의 집행 장치가 막았고, 정책 증명기는 아직 MCP·GraphQL 규칙을 검사하지 못합니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
지금 AI 에이전트 대부분은 사람처럼 웹을 씁니다. 화면을 찍어 읽고, 누를 버튼의 좌표를 계산해 클릭하고, 다음 화면을 다시 찍습니다. 9월 Astra가 KiCad를 화면으로 직접 조작해 PCB를 설계한 사례도 이 방식이었습니다. WebMCP는 반대로 웹사이트가 「상품 검색」이나 「예약」 같은 기능을 AI가 부를 수 있는 도구로 직접 내주는 방식이고, 에이전트는 화면을 보지 않고 그 도구를 함수처럼 부릅니다.
윈드터널은 이 차이를 재려고 Nekuda가 만든 공개 벤치마크이고, 결과는 WebMCP 정보 사이트 webmcp.com에 올라와 있습니다. Nekuda가 직접 운영하는 실제 웹사이트 8곳에서 작업 49개를 골라, 설정마다 세 번씩 시켰습니다. 과제 정의와 코드, 실행 기록 전체를 GitHub에 올려 누구나 다시 돌려 볼 수 있게 했습니다.
| 방식 | 에이전트가 하는 일 |
|---|---|
| WebMCP(도구 호출) | 사이트가 내준 기능을 함수처럼 부름 |
| 스크린샷(컴퓨터 사용) | 화면 이미지를 읽고 좌표를 눌러 조작 |
| 페이지 구조(DOM) | 페이지의 코드 구조와 접근성 트리를 읽고 조작 |
| 코드 실행 | 모델이 코드를 짜서 페이지를 읽고 조작 |
점수는 시도 성공률 60%, 작업당 비용 20%, 작업당 시간 20%를 섞어 매깁니다. 비용과 시간은 로그로 눌러 극단값이 점수를 좌우하지 않게 했습니다.
가장 공정한 비교는 같은 모델을 두 방식으로 돌린 결과입니다. GPT-6 Astra는 WebMCP로 작업 하나에 0.017달러를 썼고, 화면을 보는 컴퓨터 사용 방식으로는 0.261달러를 써서 15배 차이가 났습니다. Claude Opus 5는 10배, Sonnet 5는 7.7배, GPT-5.6 Luna는 약 7배였습니다.
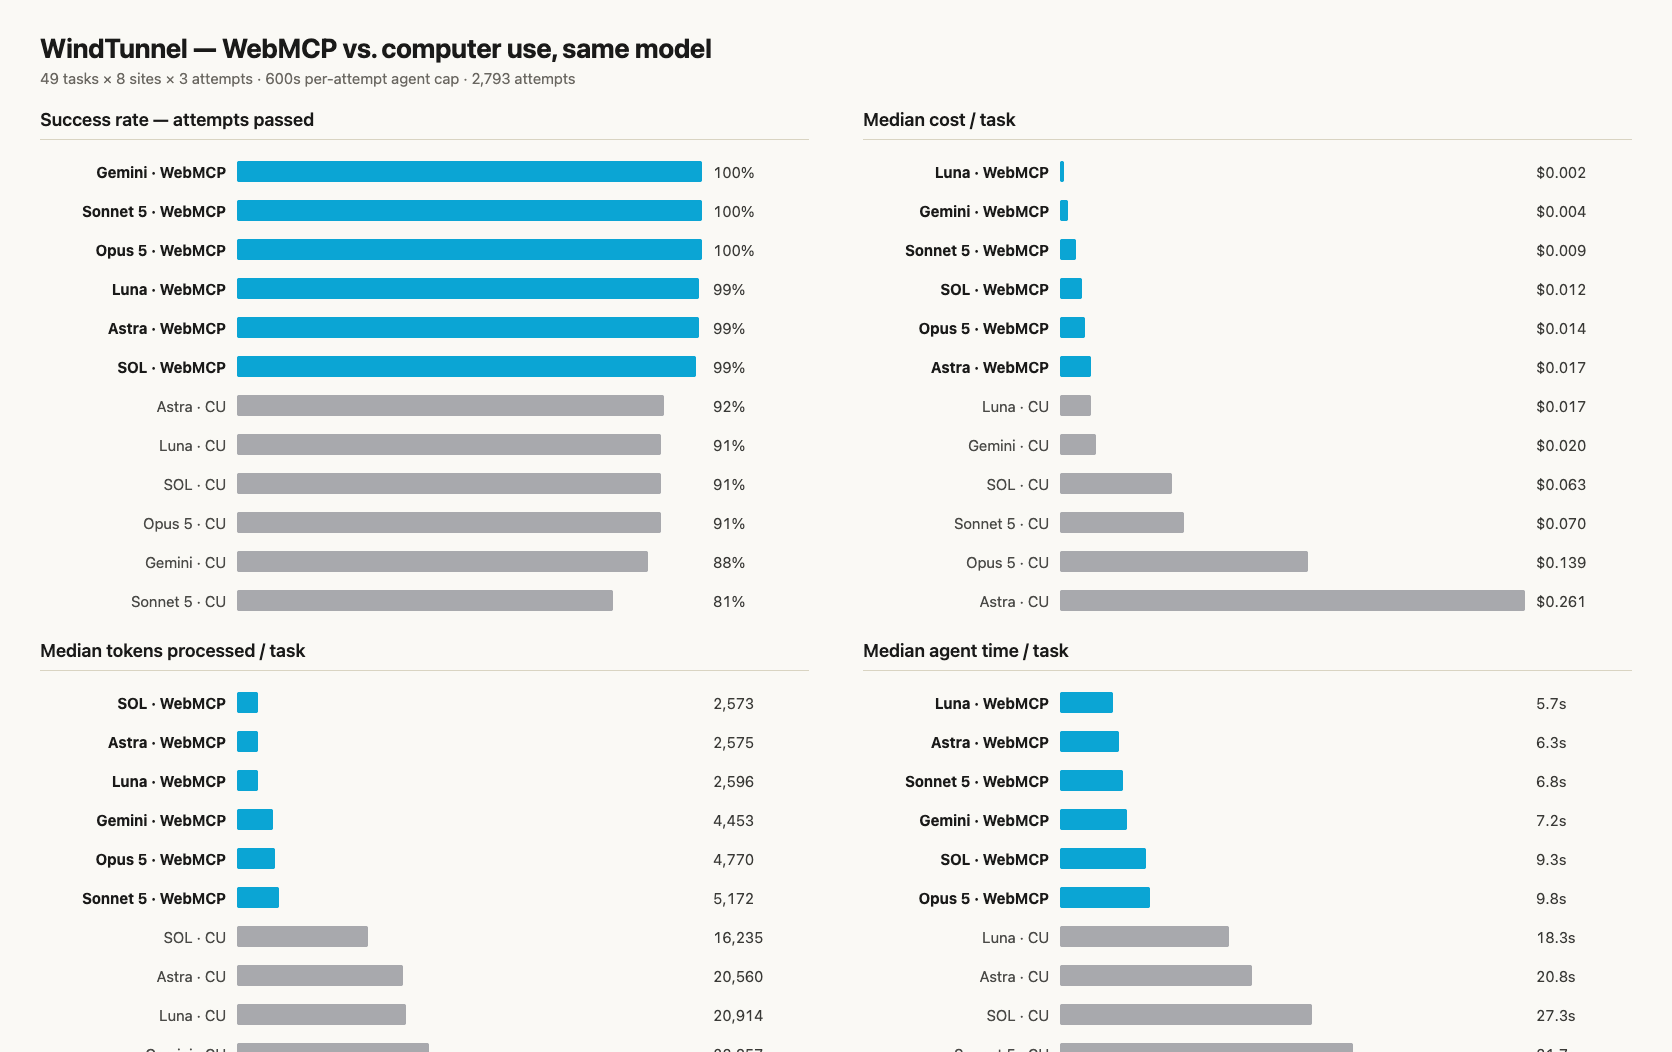
성공률도 WebMCP 쪽이 높았습니다. 여섯 모델 모두 WebMCP로는 시도의 99~100%를 성공했고, 컴퓨터 사용으로는 81~92%였습니다. 시간은 Astra 기준 6.3초와 20.8초로 세 배 넘게 벌어졌습니다.
차이는 매 단계 모델에 넣는 내용에서 생깁니다. 화면을 보는 방식은 단계마다 화면 한 장을 토큰으로 바꿔 넣고, Astra는 작업 하나에 토큰 2만 560개를 처리했습니다. 도구를 부르는 방식에서는 함수 이름과 인자만 오가서 같은 Astra가 2,575개로 끝냈습니다. 모델 바깥에서 입력과 도구 호출을 관리하는 하네스가 모델만큼 성적을 좌우한다는 점이 웹에서도 수치로 나왔습니다.
1위 Jev와 Mercury 2.5 조합은 WebMCP로 작업당 약 0.1센트를 썼습니다. Astra의 컴퓨터 사용 방식(26센트)보다 약 240배, Astra가 코드를 짜서 페이지를 다루는 방식(12센트)보다 약 110배 싼 값입니다.
| 설정 | 푼 작업 | 작업당 비용 | 작업당 시간 |
|---|---|---|---|
| Jev + Mercury 2.5 · WebMCP | 49/49 | 0.0011달러 | 3.2초 |
| GPT-6 Astra · WebMCP | 49/49 | 0.0171달러 | 6.3초 |
| GPT-6 Astra · 코드 실행 | 49/49 | 0.1187달러 | 16.4초 |
| GPT-6 Astra · 컴퓨터 사용 | 45/49 | 0.2608달러 | 20.8초 |
| Jev + Mercury 2.5 · DOM | 25/49 | 0.0008달러 | 5.4초 |
다만 이 240배에는 연결 방식을 바꾼 효과와 훨씬 싼 모델로 바꾼 효과가 함께 들어 있습니다. 같은 Astra끼리 비교하면 WebMCP 효과는 15배이고, 나머지는 Jev 조합이 Astra보다 훨씬 싼 모델이라서 생긴 차이입니다.
표 맨 아래 줄이 그 점을 보여 줍니다. 같은 Jev 조합이 도구 없이 페이지 구조를 읽어 조작했을 때는 비용이 0.08센트로 가장 쌌지만 49개 중 25개만 풀었습니다. 큰 모델은 화면을 보고도 45개 안팎을 풀지만 비싸고 느리고, 작은 모델은 싸지만 도구가 없으면 절반을 놓칩니다. 싸고 작은 모델이 쓸 만해지는 조건이 사이트가 내주는 도구입니다.
도구 방식에는 약점이 하나 있습니다. 사이트가 필요한 도구를 내주지 않으면 에이전트도 그 일을 못 합니다. 윈드터널 변경 기록에 실제 사례가 남아 있습니다.
9월 6일 판에서 Nekuda는 온라인 상점 사이트에 결제를 마치는 complete_checkout 도구를 추가했습니다. 그 전까지는 WebMCP로 도는 모든 설정이 결제 과제를 세 번 모두 실패했고, 도구가 생긴 뒤에야 세 번 모두 성공했습니다. 모델은 그대로였고 바뀐 것은 사이트가 내준 도구 목록이었습니다.
화면을 보는 방식은 아무 사이트에서나 되고 누구의 허락도 필요 없습니다. 도구 방식은 값이 수십 배 싸지만 사이트가 먼저 움직여야 열립니다. 사이트 쪽에서는 에이전트가 오면 광고가 노출되지 않고 추천 배치도 힘을 잃으니, 먼저 도구를 내줄 동기가 약합니다.
도구를 내주는 사이트가 새로 정할 것도 있습니다. 「예약」 함수를 누가 부를 수 있는지, 사람 손이라는 속도 제한이 없는 호출을 초당 몇 번까지 받을지, 에이전트가 잘못 예약했을 때 누가 책임지는지입니다. 이 답이 정리되기 전까지 큰 커머스와 예약 서비스가 도구를 먼저 열 가능성은 낮습니다.
9월 19일 ChatGPT 데스크톱 앱의 브라우저에서 Chrome 확장 프로그램을 쓸 수 있게 됐습니다. 1Password처럼 평소 쓰던 확장을 설치해 그대로 쓰고, 쿠키도 유지돼 로그인 상태가 이어집니다. 다만 ChatGPT 에이전트는 확장 프로그램을 직접 조작하거나 그 안의 정보를 읽지 못하도록 분리했습니다.
@choi.openaiThreads 게시물 · 원문 보기
분리를 택한 이유는 1Password를 떠올리면 분명합니다. 비밀번호 관리자가 붙은 브라우저를 에이전트가 자유롭게 조작하면 그 에이전트가 사용자의 모든 비밀번호에 닿습니다. 대신 로그인이 필요한 작업은 사람이 먼저 열어 주고 에이전트가 이어받는 단계가 하나 더 생깁니다.
같은 날 ChatGPT 플러그인 하나에 계정 여러 개를 동시에 연결하는 기능도 나왔습니다. 오픈AI 개발자 문서에 따르면 연결된 계정은 모두 모델에 보이고, 모델이 요청에 맞는 계정을 골라 그 계정의 권한으로 도구를 부릅니다. 구글 캘린더에 회사 계정과 개인 계정을 함께 붙여 두 캘린더 모두 비어 있는 시간을 찾게 할 수 있습니다.
확장 프로그램과 다중 계정을 같이 놓으면 ChatGPT가 가려는 방향이 보입니다. 브라우저를 품고, 확장을 받고, 여러 계정을 한 대화에 묶어 사용자의 작업 환경 자체가 되는 쪽입니다. 그만큼 계정이 나눠 주던 회사 자료와 개인 자료의 경계를 이제 대화 기록이 떠안게 됩니다.
Claude Code 쪽은 방향이 반대입니다. Zenbu Labs가 터미널 안에서 돌아가는 브라우저 terminal-browser용 Claude Code 플러그인을 내놨고, Claude Code에서 /browser를 입력하면 터미널 옆 창에 브라우저가 열립니다. 7월에 공개된 terminal-browser 저장소는 GitHub 별 3,205개를 받았고, 플러그인은 아직 실험 단계이며 Claude Chrome 확장 연동은 준비 중입니다.
@choi.openaiThreads 게시물 · 원문 보기
코드를 고치고 결과 화면을 확인할 때마다 창을 옮기던 반복이 터미널 하나에서 끝납니다. 같은 날 Claude Code는 2.1.277 버전부터 폴더에 CLAUDE.md가 없으면 AGENTS.md를 프로젝트 지침으로 읽기 시작했습니다. AGENTS.md는 Codex를 비롯한 여러 코딩 에이전트가 같은 지침을 함께 쓰려고 만든 형식이고, 오픈AI의 로맹 위에(Romain Huet)는 생태계가 하나의 표준으로 모이고 있다며 반겼습니다.
지침 파일 형식은 몇 달 만에 하나로 모였는데, 웹 연결 방식은 아직 세 갈래입니다. 지침 파일 형식으로 돈을 버는 회사는 없지만, 웹 연결 방식에는 사이트의 광고와 추천, 결제 동선이 걸려 있습니다.
국내 주요 서비스는 예약과 구매 과정에 본인확인과 간편결제가 끼어 있습니다. 화면을 보는 에이전트는 대개 이 단계에서 멈추고, 도구 방식도 이 단계를 어떻게 넘길지 규격에 따로 적어야 합니다. 배달과 금융, 커머스의 실제 사용은 대부분 앱에서 일어나서, 웹 연결 방식이 정리돼도 국내 사용자의 작업 상당수는 그 밖에 남습니다.
사내망 쪽에서는 계산이 다릅니다. 화면을 찍어 모델에 보내는 방식은 화면에 함께 찍힌 다른 자료까지 밖으로 나갑니다. 도구 방식은 함수 이름과 인자만 오가서 보안 검토가 단순하고, 비용과 별개로 이 방식을 고를 이유가 됩니다.
윈드터널은 Nekuda가 직접 만들고 운영한 벤치마크이고, 8개 사이트도 Nekuda가 운영합니다. 실행 기록을 모두 공개했지만 제3자가 다시 돌린 결과는 아직 없습니다. 벤치마크 사이트들은 도구를 내주도록 준비된 곳이라, 실제 웹에서 그런 사이트가 얼마나 되는지와는 다른 문제입니다.
WebMCP가 퍼지는 속도는 모델 회사보다 사이트를 가진 쪽이 정합니다. 커머스와 예약, 미디어 사이트에서 도구를 내주는 결정이 나오기 시작하면 작은 모델로도 웹 자동화가 싸게 돌아가고, 나오지 않으면 에이전트는 계속 화면을 보며 비싼 값을 치르게 됩니다.
읽어 주셔서 고맙습니다.
초이 드림


