이 글 어땠어요?
두 회사는 기존 이용자에게 달라지는 것이 없다고 밝혔습니다. Turso의 데이터베이스와 API, 작업 흐름은 그대로 돌아가고 Turso 데이터베이스도 오픈소스로 남으며, 앞으로 몇 달 안에 Supabase와의 연동을 늘린다고 했습니다.
10월 3일 기준 문서로는 네이티브 실행이 리눅스(amd64·arm64)와 macOS 14 이상의 애플 실리콘 맥에서만 됩니다. 윈도와 인텔 맥에서는 Docker로 돌리고, 기능 자체도 기본으로 꺼 둔 알파입니다.
대기자 명단을 받는 비공개 알파입니다. 신청서 동의문은 내부 평가용이라 실제 서비스나 고객 대상 작업에 쓰지 말라고 적었고, 요금 수준은 공개되지 않았습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
일론 머스크가 10월 7일 오후 3시 46분(한국 시각) Grok Bot에 Claude Opus 5.5와 미드저니, 수노 같은 외부 모델도 쓰겠다고 밝혔습니다. AA 지능 지수로는 Opus 5.5가 58점, Grok 4.7이 46.4점입니다.
메타와 시에라가 10월 6일(미국 시각) 개인 AI 에이전트가 기업과 거래하는 방식을 정하는 공개 표준 Personal Agent Protocol을 발표했습니다. OAuth로 세션을 열고 소비자가 읽기·쓰기 권한을 고르며, 규격 초안 v0.1은 10월 안에 나옵니다.
마이크로소프트가 10월 7일(미국 시각) 윈도 행사에서 에이전트 격리 장치 MXC를 정식 출시하고 메타 Muse의 윈도 앱을 예고했습니다. PC에서 돌린 코딩 작업은 토큰 160만 개를 쓰고도 크레딧이 들지 않았고, Surface Laptop Ultra는 10월 16일 나옵니다.

일론 머스크가 10월 7일 오후 3시 46분(한국 시각) Grok Bot에 Claude Opus 5.5와 미드저니, 수노 같은 외부 모델도 쓰겠다고 밝혔습니다. AA 지능 지수로는 Opus 5.5가 58점, Grok 4.7이 46.4점입니다.
메타와 시에라가 10월 6일(미국 시각) 개인 AI 에이전트가 기업과 거래하는 방식을 정하는 공개 표준 Personal Agent Protocol을 발표했습니다. OAuth로 세션을 열고 소비자가 읽기·쓰기 권한을 고르며, 규격 초안 v0.1은 10월 안에 나옵니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
행사는 Supabase가 2020년 창업 직후 거친 Y Combinator(YC)의 샌프란시스코 사무실에서 신청자만 받아 하루 동안 열렸고, 참가비는 256달러였습니다. 작년에 이어 두 번째로 열린 Select 무대에는 애플 공동창업자 스티브 워즈니악과 앤드루 응, YC 대표 개리 탄, 리플릿의 암자드 마사드, 앤트로픽과 오픈AI의 제품 책임자들이 올랐습니다. 개막을 맡은 앤트 윌슨 CTO는 Supabase로 백엔드를 돌리는 개발자가 1,300만 명을 넘었고, YC 기업 1,700곳 이상과 가장 최근 배치의 60%가 Supabase를 쓴다고 말했습니다.
윌슨은 오픈AI가 9월 말 DevDay에서 넓힌 Sign in with ChatGPT도 소개했습니다. ChatGPT 계정으로 Supabase에 로그인하면 에이전트가 ChatGPT 화면을 떠나지 않고 프로젝트를 만들고 데이터를 넣을 수 있다는 설명이었고, 이어 Supabase가 6년 동안 공들인 대시보드 이야기를 꺼냈습니다.
처음 5년 동안 정말 좋은 대시보드를 만드는 데 마음을 다 쏟았습니다. 그런데 이제 에이전트는 대시보드에 관심이 없고, 그냥 ChatGPT로 연결하고 싶어 합니다.— 앤트 윌슨, Supabase 공동창업자·CTO(Select 개막 연설)
폴 코플스톤 CEO의 기조연설도 같은 이야기에서 출발했습니다. 2020년 YC에 들어갔을 때 그는 직원 한 명에게 100일 안에 에어테이블만큼 쉬운 Postgres 대시보드를 만들라고 했고, Supabase는 그렇게 대시보드부터 만든 회사였습니다. 코플스톤은 이제 그런 대시보드는 2분이면 만들 수 있고, 대시보드가 더는 최고의 개발 경험도 못 된다고 말했습니다. 올해 초 그가 팀에 보낸 메모는 방향을 이렇게 적었습니다.
Supabase 전체를 코드로 관리할 수 있어야 합니다. supabase 폴더가 기준이 되고, 사용자가 git 원격 저장소에 푸시하면 모든 것이 갱신돼야 합니다. 대시보드와 API, CLI, Git이 함께 움직여서 어디서 바꾸든 모든 곳에 반영돼야 합니다.— 폴 코플스톤, Supabase CEO(올해 초 사내 메모, Select 기조연설에서 낭독)
에이전트는 화면을 누르는 대신 저장소 안의 파일을 고치고 명령을 실행합니다. 대시보드에서 테이블을 만들고 접근 정책을 바꾼 뒤 CLI로 마이그레이션 파일을 끌어오던 흐름은 사람에게 맞춘 순서였습니다. 이날 발표는 그 순서를 저장소 안으로 옮기는 도구들과, 데이터베이스를 훨씬 많이 훨씬 싸게 띄우는 기술 두 갈래였고, Turso 인수는 두 번째 갈래에 들어갑니다.
Supabase의 데이터베이스가 에이전트 손에서 불어나기 시작한 것은 2024년 가을입니다. 투자사 펠리시스가 9월 28일(미국 시각) 낸 창업자 인터뷰를 보면, 대시보드 지표가 갑자기 치솟자 팀은 처음에 공격을 받는 줄 알았습니다. 확인해 보니 바이브 코딩 서비스 러버블(Lovable)이 이용자들을 Supabase로 곧장 보내고 있었고, 그 이용자 대부분은 자기 앱 뒤에 데이터베이스가 있다는 사실도 몰랐습니다.
처음엔 디도스 공격을 받는 줄 알았습니다.— 폴 코플스톤, Supabase CEO(펠리시스 인터뷰)
러버블을 지원할지를 두고 회사 안에서 의견이 갈렸고, Supabase는 2025년 3월 스페인에서 연 전사 워크숍에서 러버블과 경쟁하는 제품을 만드는 대신 그런 도구들이 가져다 쓰는 인프라로 남기로 했습니다. 그 결정에서 나온 상품이 Supabase for Platforms입니다. 러버블과 볼트(Bolt), 버셀(Vercel)이 최종 이용자에게 Supabase라는 이름을 드러내지 않고 데이터베이스를 붙여 쓰는 화이트라벨 상품으로, 회사는 지난 1년 동안 가장 빨리 큰 제품이라고 밝혔습니다. 숫자는 그 뒤로 이렇게 움직였습니다.
| 시점 | Supabase가 밝힌 숫자 |
|---|---|
| 2020년 봄 | 「오픈소스 파이어베이스 대안」 문구를 단 뒤 며칠 만에 데이터베이스 800개 |
| 2026년 6월 4일 | 시리즈 F 5억 달러(투자 전 기업가치 100억 달러), 1년 새 데이터베이스 생성 600% 증가, 새 데이터베이스의 60% 이상을 AI 도구가 생성, 개발자 약 1,000만 명 |
| 2026년 10월 2일 | 추가 투자 1억 5,000만 달러, 매달 이용자 100만 명·데이터베이스 400만 개 증가, 새 데이터베이스의 70%를 에이전트·AI 도구가 생성, 개발자 1,300만 명 |
10월 투자에는 GIC와 함께 알파벳의 성장 투자 펀드 캐피털G, 아이언아크, 스퀘어페그가 들어왔습니다. 보도자료는 이번 자금을 에이전트용 데이터베이스 개발과 직원 보유 지분의 현금화에 쓴다고 적었고, 새 기업가치는 밝히지 않았습니다. 펠리시스 창업자 에이딘 센컷은 인터뷰를 공유하며 Supabase를 에이전트 코딩 붐을 떠받치는 인프라라고 불렀습니다.
@asenkutX 게시물 · 원문 보기
코플스톤은 기조연설 끝에서 숫자를 하나 더 꺼냈습니다. 몇 년 안에 Supabase가 데이터베이스를 수십억 개 띄우게 될 것이 확실하다는 것입니다. Supabase 프로젝트는 지금 하나하나가 전용 Postgres를 받는데, 코플스톤은 수십억 개로 늘리려면 완전히 다른 구조가 필요하다며 이용자마다, 에이전트마다, 아이디어 하나마다 데이터베이스를 주는 새 인스턴스 종류 Supabase Spark를 소개했습니다. 설계 원칙으로는 데이터베이스를 기계 대신 파일로 다룰 것, 처음부터 여러 이용자가 서버를 나눠 쓰게 만들 것, 내구성 99.999999999%의 객체 저장소 위에 올릴 것 세 가지를 들었습니다. 그리고 Spark를 Turso 기술로 만들고, Turso의 구조를 Supabase의 Postgres에 맞춰 옮기겠다며 인수를 발표했습니다.
SQLite는 서버 프로그램 없이 파일 하나로 돌아가는 데이터베이스로, 스마트폰이나 웨어러블 같은 작은 기기에서도 돌릴 수 있습니다. Turso는 이 SQLite를 러스트로 처음부터 다시 쓰고, 서버 한 대가 데이터베이스 수백만 개를 맡아 필요할 때 불러오고 쓰지 않을 때 멈춰 두는 클라우드를 만든 회사입니다. SQLite가 약했던 동시 쓰기를 풀었고 고객사 클라우드 안에 설치하는 방식도 지원하며, 슈퍼휴먼과 사우나AI, CTO.new, 마스트라가 에이전트마다 데이터베이스를 따로 주는 데 Turso를 씁니다. Supabase는 이미 일주일에 데이터베이스를 100만 개 넘게 띄우고 있다고 밝혔습니다.
Turso 창업자 글라우버 코스타는 같은 날 오후 다른 무대에서 15분 동안 이 구조를 설명했습니다. Turso 클라우드의 한 고객은 혼자서 데이터베이스 1,000만 개를 쓰는데, 그중 대부분은 거의 내내 쓰이지 않고 쉬고 있습니다. 데이터베이스마다 가상 머신이나 컨테이너를 하나씩 붙이면 노는 데이터베이스에도 CPU와 메모리를 계속 잡아 둬야 하고, 코스타는 그 비용 구조로는 앞으로 올 규모를 감당할 수 없다고 했습니다.
에이전트는 오늘 이미 데이터베이스를 수백만 개 만들고 있습니다. 현재형으로 하는 말입니다.— 글라우버 코스타, Turso 창업자(Select 빌드 무대 발표)
코스타는 Turso 서버를 데이터베이스보다 웹 서버에 가깝다고 설명했습니다. 주소마다 SQLite 파일이 하나씩 붙어 있고 요청이 오면 그 파일로 SQL을 보내는 식이라, 데이터베이스마다 프로세스를 따로 띄우지 않습니다. 데이터 원본은 모두 아마존 S3에 두고 서버 디스크는 캐시로만 쓰며, 쓰기 응답이 한 자릿수 밀리초인 S3 Express One Zone 덕분에 쓰기 한 번에 5~6밀리초가 걸린다고 밝혔습니다. 한 데이터베이스가 자원을 너무 많이 쓰면 그것만 전용 서버로 옮기고, 그보다 커지면 Supabase의 Postgres로 넘기는 것이 두 회사가 그린 경로입니다.
Turso는 인수 전부터 Postgres 쪽으로 움직이고 있었습니다. 7월 16일 글에서 러스트로 만든 엔진 하나에 여러 SQL 문법을 얹겠다며 SQLite 다음으로 Postgres 호환 문법을 만들기 시작했다고 밝혔고, 오픈소스 기여자가 260명을 넘는다고 적었습니다. 7월 20일 글에서는 에이전트마다 데이터베이스를 주는 설계를 설명하며, 만드는 데는 API 호출 한 번이 들고 노는 데이터베이스는 저장 공간 값만 들며 지우면 에이전트의 흔적이 한 번에 사라진다고 정리했습니다.
Supabase가 2020년 봄 처음 이름을 알린 문구는 「오픈소스 파이어베이스 대안」이었습니다. 파이어베이스는 실시간 데이터베이스로 출발한 앱 백엔드 서비스로, 2014년 10월 21일 구글에 합류했습니다. 당시 공동창업자 제임스 탬플린은 3년 만에 개발자 11만 명이 쓰는 제품이 됐다고 적으며 기존 개발자에게 이렇게 약속했습니다.
파이어베이스 위에 앱을 만든 개발자에게는 아무것도 달라지지 않습니다.— 제임스 탬플린, 파이어베이스 공동창업자(2014년 10월 구글 합류 공지)
12년 뒤 Supabase가 Turso 인수 공지에 쓴 문장도 같습니다. 기존 이용자에게는 아무것도 달라지지 않고, Supabase는 Postgres를, Turso는 SQLite를 계속 만든다는 내용입니다. Turso는 데이터베이스와 API, 작업 흐름이 지금처럼 돌아가고 Turso 데이터베이스도 오픈소스로 남는다고 따로 적었고, 코스타는 Supabase에서 에이전트 서비스 책임자를 맡습니다. 코스타는 무대에서 변호사들이 서류 작업을 마치면 「거의 공식적으로」 Supabase 가족이 된다고 말해 인수 절차가 아직 끝나지 않았다는 사실도 밝혔고, 인수 금액은 공개되지 않았습니다.
해커뉴스에 올라온 인수 글에는 한국 시각 10월 3일 새벽부터 댓글이 이어졌습니다. 먼저 나온 걱정은 Turso가 인수 뒤에도 살아남느냐였습니다. 한 이용자는 Turso가 또 하나의 「놀라운 여정」으로 끝나지 않기를 바란다고 썼는데, 인수된 스타트업이 서비스를 닫으며 올리는 감사 공지에 자주 쓰이는 표현입니다. 코스타는 직접 답글을 달아 그런 일이 자주 일어난다는 걸 안다며, 이제 Turso 개발을 몰아붙일 자원이 생겼다고 답했습니다.
다른 반론은 SQLite를 왜 다시 쓰느냐였습니다. SQLite는 가장 잘 짜이고 가장 많이 시험된 소프트웨어로 꼽히는데 굳이 새로 쓸 이유가 있느냐는 물음에, 다른 개발자들은 동시 쓰기와 비동기 처리, 외부 기여를 받는 개발 방식을 들었습니다. Turso 쪽 설명으로는 SQLite는 외부 기여를 받지 않고 시험 묶음도 공개하지 않습니다. 분석용 성능 시험 ClickBench에 Turso를 넣으려다 데이터 적재 단계에서 번번이 막혔다는 지적도 나왔고, Turso 개발진은 문제를 알고 있지만 지금 가장 급한 일로 두고 있지는 않다고 답했습니다.
저는 10월 4일 0시 스레드에서 이날 발표 가운데 Docker 없는 로컬 실행과 Compute, OrioleDB를 먼저 골라 정리했습니다. 지금까지 로컬에서 Supabase를 돌리려면 Docker 컨테이너 여러 개를 한꺼번에 띄워야 했고, Docker 데몬이 없는 Claude Code 샌드박스나 CI 실행기에서는 쓸 수 없었습니다. 새 CLI는 서비스를 컨테이너 대신 컴퓨터의 일반 프로세스로 띄우는 네이티브 실행을 지원하고, Postgres만 바로 켠 뒤 나머지 서비스는 첫 요청이 올 때 켰다가 60초 동안 쓰지 않으면 끕니다. 코플스톤은 새 CLI의 콜드 스타트가 9배 빨라지고, 놀 때 메모리를 90% 가까이 덜 쓰며, 처음 내려받는 크기가 5분의 1로 줄었다고 말했습니다.
디렉터리마다 로컬 스택을 따로 띄우는 기능도 함께 나왔습니다. 같은 저장소를 git 워크트리 여러 개로 나눠 에이전트 여러 개에게 맡기면 예전에는 두 번째 로컬 Supabase부터 포트가 겹쳤는데, 이제는 워크트리마다 포트와 데이터가 따로 잡혀 에이전트 둘이 서로 다른 스키마 변경을 동시에 시험하고 잘 되는 쪽만 남길 수 있습니다. 두 기능 모두 기본으로 꺼 둔 알파이고, 설정 파일에서 실험 옵션을 켜야 동작합니다. 10월 3일 문서 기준으로 네이티브 실행은 리눅스(amd64·arm64)와 macOS 14 이상의 애플 실리콘 맥에서만 되고, 윈도와 인텔 맥은 Docker로 돌립니다. 문서는 한 컴퓨터에서 로컬 프로젝트를 여러 개 돌릴 때는 Docker를 권하는데, 네이티브 프로세스끼리는 호스트의 프로세스 목록과 파일 잠금을 같이 쓰기 때문입니다.
스키마 쪽에서는 Declarative Schemas 2.0이 나왔습니다. 코플스톤은 지금 에이전트가 데이터베이스 구조를 알려면 마이그레이션 파일의 긴 이력을 읽거나 Postgres를 직접 띄워 들여다봐야 하는데, 앞의 방법은 문맥을 잡아먹고 환각을 부르며 뒤의 방법은 느리다고 설명했습니다. 새 방식에서는 원하는 스키마를 SQL 파일로 적어 두면 자체 비교 도구 pg-delta가 차이를 계산해 마이그레이션을 만들고, 대시보드에서 바꾼 설정은 supabase config pull 한 번으로 설정 파일에 돌아옵니다. 새로 만드는 프로젝트는 pg-delta가 기본이고, pg-delta는 다른 Postgres에도 쓸 수 있는 오픈소스로 공개됐습니다.
오래 도는 작업은 Supabase Compute가 맡습니다. 개리 탄 YC 대표는 올해 에이전트용 공유 메모리 서비스 GBrain을 Supabase로 만들다가, 긴 문서를 잘게 나눠 임베딩(문장을 숫자 벡터로 바꾼 값)을 만드는 작업에서 막혔습니다. 코플스톤이 기조연설에서 읽은 탄의 이메일은 이랬습니다.
Supabase Edge Functions가 당연한 선택이지만 2초 제한이 큰 단점이라, 다른 곳에 서버를 따로 둬야 할지도 모르겠습니다.— 개리 탄, YC 대표(코플스톤이 기조연설에서 읽은 이메일)
Compute는 어떤 언어로 짠 서비스든 실행 시간 제한 없이 데이터베이스 옆에서 돌립니다. 제품 페이지를 보면 서비스마다 전용 CPU와 메모리를 받는 마이크로VM에서 완전한 리눅스 환경을 쓰고, Postgres와 같은 네트워크에 있어 조회가 한 자릿수 밀리초에 끝납니다. 쓰지 않을 때는 멈췄다가 1초 안에 다시 깨어나고, 멈춘 동안에는 요금이 붙지 않습니다. 공개 HTTP 주소를 단 서비스와 주소 없이 작업 대기열만 처리하는 백그라운드 작업을 모두 지원하며, 코플스톤은 에이전트가 이미 클라우드로 옮겨 가 더 오래, 여러 개가 동시에 돌고 노트북을 닫은 뒤에도 일을 이어 간다고 말했습니다. 3일 전 오픈AI가 노트북을 닫아도 도는 코덱스를 내놓으며 내건 문구도 노트북을 닫아도 에이전트는 계속 일한다는 것이었습니다. 다만 Compute는 대기자를 받는 비공개 알파이고, 신청서 동의문은 내부 평가용이라 실제 서비스나 고객 대상 작업에는 쓰지 말라고 적었으며 요금 수준은 공개하지 않았습니다.
앱 이용자를 위한 MCP(에이전트가 외부 앱의 기능을 도구로 불러 쓰는 표준) 서버도 나왔습니다. Claude나 ChatGPT, Cursor를 쓰는 이용자가 자기 에이전트에게 어떤 앱 안의 일을 시키면, 그 앱의 MCP 서버가 Supabase 프로젝트 안에서 Edge Function으로 돌며 앱의 기존 로그인으로 이용자를 확인하고 행 단위 접근 정책(RLS)이 허락한 데이터만 건넵니다. 개발자가 프로젝트를 관리할 때 쓰는 공식 Supabase MCP 서버와는 따로 돌아가는 서버입니다.
운영 쪽 발표는 에이전트가 프로덕션 문제를 찾아 고칠 거리를 제안하게 하는 데 맞춰졌습니다. 공식 MCP 서버에는 프로젝트 로그를 SQL로 직접 조회하는 query_logs 도구가 붙었고, 점검 기능 Advisor는 보안과 성능에 더해 Data API·Auth·Storage·Edge Functions의 오류율이 평소보다 높아지면 경고합니다. 어느 세션이 연결을 붙잡고 있고 어떤 쿼리가 막혔는지 보여 주고 바로 취소할 수 있는 화면도 모든 프로젝트에 켜졌고, 조회와 메모를 묶어 다시 돌릴 수 있는 노트북은 SQL 편집기를 대신할 Explorer에 담겨 10월 12일까지 차례로 배포됩니다.
권한 장치도 함께 나왔습니다. 개인 접근 토큰은 조직과 프로젝트, 권한 범위를 골라 묶을 수 있게 됐고 대시보드에서 새로 만드는 토큰의 기본값이 됐습니다. 공식 MCP 서버는 MCP의 되묻기(elicitation) 기능으로, 에이전트가 유료 프로젝트나 브랜치를 만들거나 데이터를 지울 수 있는 SQL을 실행하기 전에 사람에게 자원과 요금, 결제 주기를 확인받습니다. Supabase는 이 확인이 원치 않는 요금과 데이터 손실을 막는 데 도움이 되지만 보장은 하지 못하고, 에이전트 클라이언트가 이 기능을 지원해야 창이 뜬다고 적었습니다. 정리 글은 에이전트가 문제를 찾아 보고하고, 무엇을 고쳐 병합할지는 사람이 정한다고 썼습니다.
| 발표 | 단계 | 조건 |
|---|---|---|
| Docker 없는 로컬 실행, 디렉터리별 로컬 스택 | 알파, 기본 꺼짐 | 설정에서 실험 옵션 켜기 |
| Declarative Schemas 2.0(pg-delta) | 공개 | 새 프로젝트 기본값 |
| Supabase Compute | 비공개 알파 | 대기자 명단, 내부 평가용 |
| 앱용 MCP 서버 | 공개 | Supabase 라이브러리의 블록으로 추가 |
| 범위 지정 토큰, MCP 기업 인증 | 정식 | MCP 기업 인증은 SSO를 쓰는 Team·Enterprise |
| Pipelines(분석용 실시간 복제) | 공개 알파 | Pro·Team·Enterprise |
| OrioleDB | 공개 베타 | 새 프로젝트를 만들 때만 선택 |
| Multigres | 비공개 알파 | 초대받은 고객 |
| Supabase Spark | 발표만 | 일정 미정 |
확장 쪽 발표의 중심은 OrioleDB입니다. Postgres의 기본 저장 방식인 heap은 행을 고칠 때마다 새 버전을 쓰고 옛 버전을 죽은 행으로 남겨 두는데, 이를 치우는 VACUUM 작업이 쿼리와 자원을 다툽니다. OrioleDB는 옛 버전을 undo 로그로 돌려 VACUUM이 필요 없게 하고, 트랜잭션 ID를 64비트로 늘려 랩어라운드(32비트 ID 약 40억 개를 다 써 버려 데이터베이스가 읽기 전용으로 멈추는 사고)를 없앱니다. 코플스톤은 초당 1만 5,000건을 쓰는 데이터베이스라면 32비트 ID는 3일이면 바닥나지만 64비트로는 약 3,000만 년이 걸린다고 설명했고, 2015년 센트리와 2019년 메일침프가 이 사고를 겪었다고 했습니다.
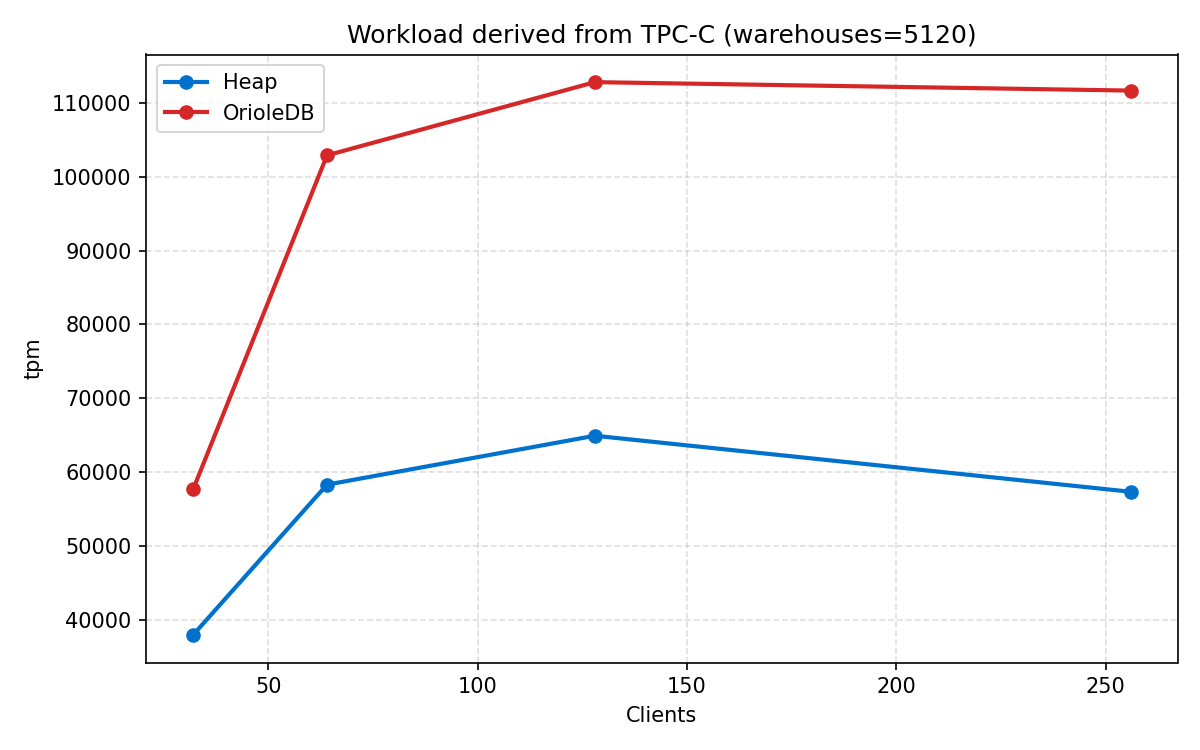
코플스톤은 무대에서 OrioleDB가 heap보다 두 배 빠르다고 말했지만, 10월 1일 공개 베타 공지의 숫자는 약 1.8배입니다. 32 vCPU·메모리 128GiB의 8XL 인스턴스에서 메모리보다 큰 데이터로, 요청 사이 대기 시간 없이 TPC-C에서 파생한 부하를 걸어 잰 값이고, 공지는 이 부하가 TPC-C 규격을 다 따르지 않아 공인 결과와 견줄 수 없으며 결과는 부하에 따라 다르니 직접 재 보라고 적었습니다. 측정 결과를 올린 dbarena도 Supabase가 이번에 연 비교 사이트로, 측정 코드와 원자료를 공개하고 Supabase와 아마존 RDS, 구글 클라우드 SQL을 같은 비용 기준으로 견줍니다.
OrioleDB는 유료 요금제로 넓어졌고 요금도 일반 Postgres 프로젝트와 같지만, 공지는 공개 베타가 시험용이며 아직 프로덕션에는 권하지 않고 SLA도 없다고 적었습니다. 특정 시점 복구(PITR)와 백업을 새 프로젝트로 복원하는 기능이 빠졌고, 프로젝트를 만들 때만 고를 수 있어 기존 프로젝트에 붙이거나 나중에 뗄 수 없습니다. 벡터 검색에 쓰는 pgvector의 HNSW 인덱스는 실험 단계의 연결 장치를 거쳐 돌아갑니다. Vitess를 만든 팀이 짓는 고가용성 도구 Multigres는 가용 영역 세 곳에 Postgres 노드를 두고 장애가 나면 커밋된 쓰기를 잃지 않고 몇 초 안에 복제본을 승격합니다. 코플스톤은 사내 시험에서 장애 전환 1,000번을 연달아 일으켜도 데이터를 잃지 않았다고 말했지만, Multigres 역시 초대받은 고객만 쓰는 비공개 알파입니다.
윈도에서 개발하는 팀에는 이번 네이티브 실행이 해당하지 않고, 애플 실리콘 맥이나 리눅스 CI, Claude Code 같은 에이전트 샌드박스에서 Docker 없이 로컬 Supabase를 띄우는 쪽이 바로 시험해 볼 수 있는 부분입니다. 문서는 네이티브 실행이 root 권한으로는 돌지 않고, 처음 시작할 때 GitHub 릴리스나 Supabase의 S3 저장소에서 서비스 묶음을 내려받으므로 허용 목록이 있는 샌드박스라면 그 주소를 열어 두라고 안내했습니다. 스키마 파일과 pg-delta, 범위 지정 토큰, 되묻기 확인처럼 정식으로 나온 기능은 지금 프로젝트에 그대로 붙일 수 있습니다.
Turso를 쓰던 팀에게 당장 달라지는 것은 없고, 두 회사는 앞으로 몇 달 안에 연동을 늘리겠다고만 밝혔습니다. 데이터베이스를 파일처럼 띄우는 Supabase Spark는 이름과 설계 원칙만 나왔고 출시 일정은 없습니다. Supabase는 Turso 인수가 언제 끝나는지도 밝히지 않았습니다. Explorer 배포가 끝나는 10월 12일 이후의 화면과 Spark 일정이 나오면 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림