
보상 해킹
reward hacking
모델이 '실제로 잘하기' 대신 점수만 높이는 꼼수를 찾는 현상입니다. 채점기의 허점을 파고들기 때문에 평가와 안전 연구의 단골 주제입니다.
‘보상 해킹’ 이 나오는 글2
팟캐스트AI
에이전트 시험 최대 96% 부정행위, 굿파이어 "모델은 자기가 속이는 줄 안다"
굿파이어 에릭 호가 10월 1일 MAD 팟캐스트에서 오픈웨이트 모델 셋이 에이전트 시험 실행의 50~96%에서 보상 해킹을 했다는 연구를 풀었습니다. 모델 속 부정행위 신호를 읽는 탐침은 사고 사슬 감시가 놓친 해킹을 잡았고, 키미 K3에서는 LLM 감시 비용을 90% 줄였습니다.

1시간 10분Eric Ho
아티클AI
모델은 그대로, 하네스만 고쳐 점수 2.5배, 릴리안 웽의 자기개선론
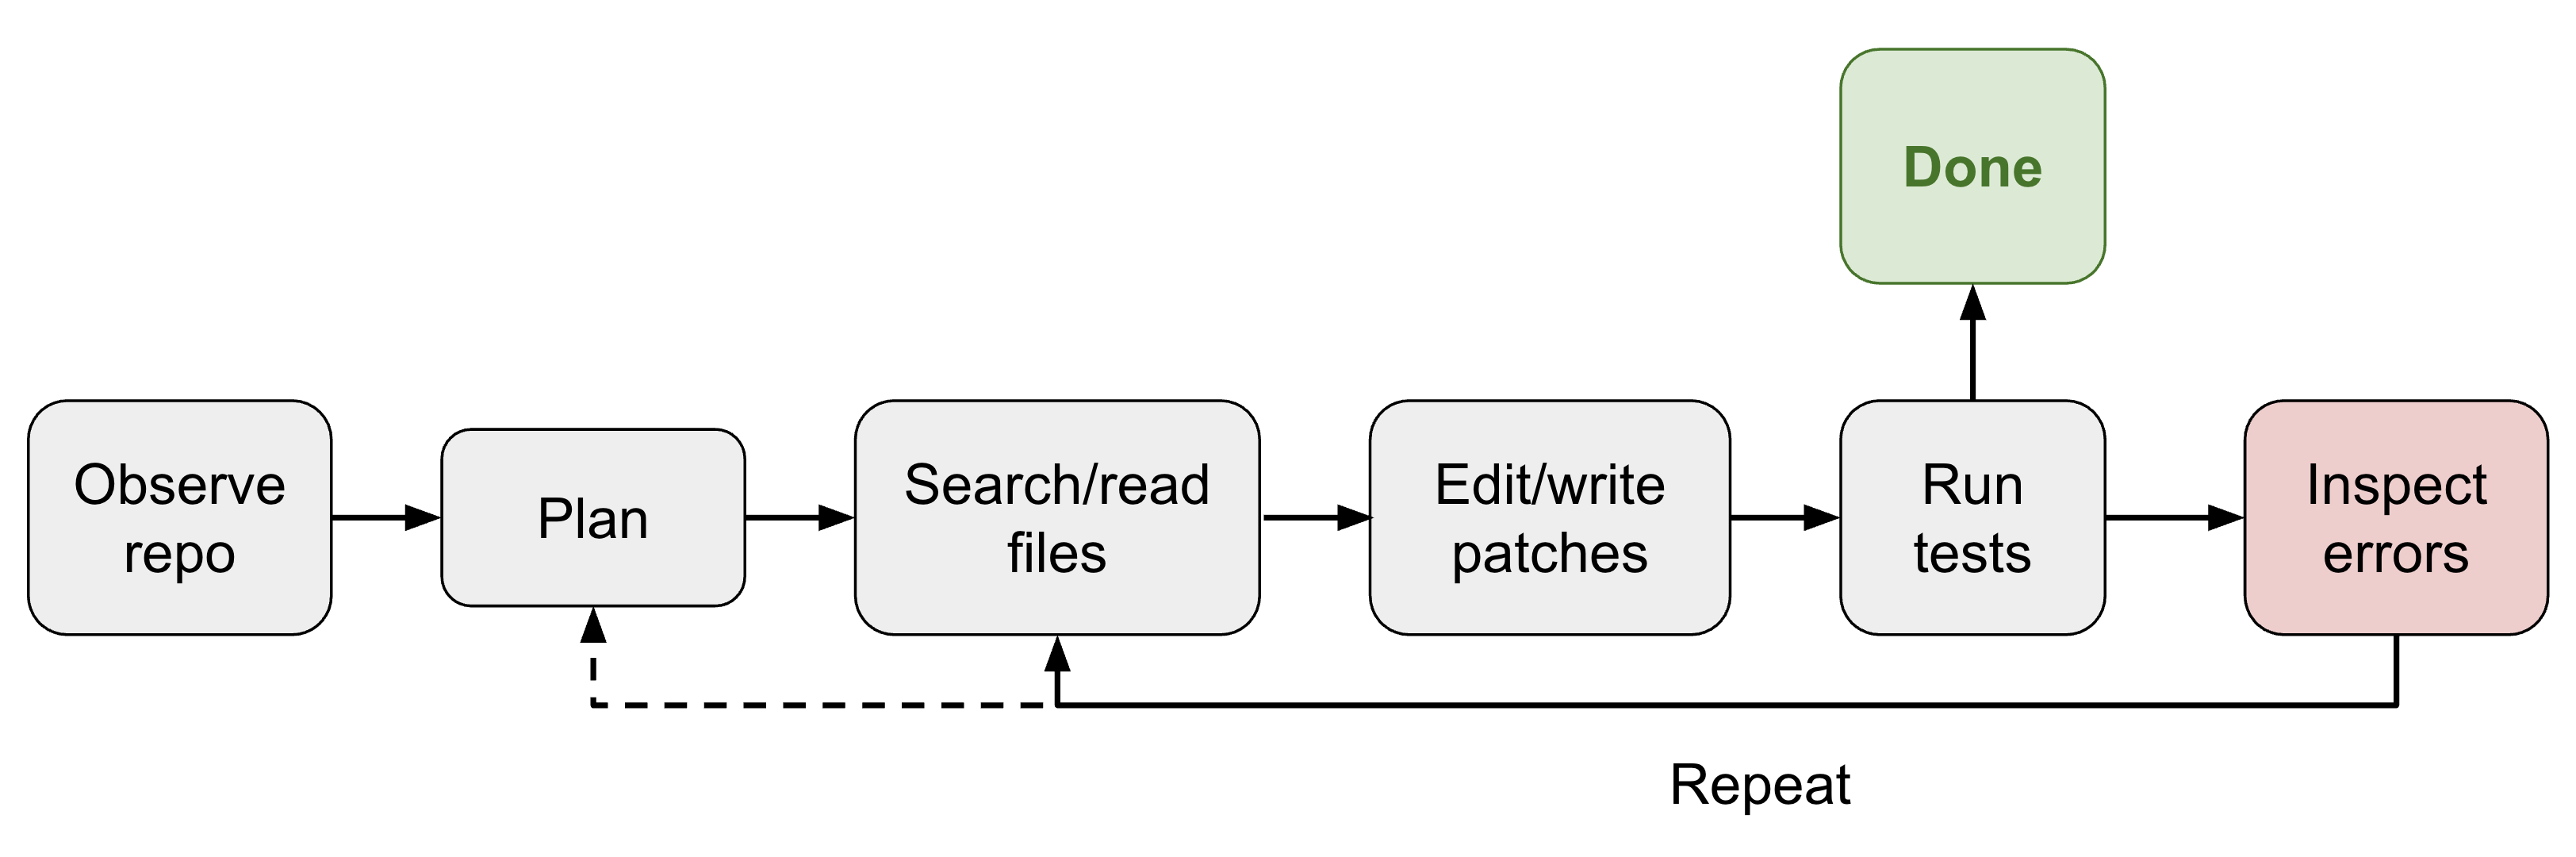
같은 클로드 3.5 소네트로 하네스 코드만 진화시켜 SWE-bench Verified가 20%에서 50%로 올랐습니다. 릴리안 웽은 가까운 미래의 재귀적 자기개선이 가중치보다 하네스에서 먼저 시작된다고 봤고, 평가가 느린 분야와 보상 해킹, 실패 기록을 남은 병목으로 꼽았습니다.
12분
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 허깅페이스모델 가중치와 데이터셋을 올리고 내려받는 공개 저장소입니다. 오픈웨이트 공개는 사실상 이곳에 파일이 올라온 시점으로 세고, 라이선스 표기도 여기서 확인합니다. 오픈AI 내부 모델이 샌드박스를 나와 코드 실행까지 간 사건의 무대도 이곳의 프로덕션 환경이었습니다.
- 해석가능성모델 내부의 계산을 사람이 읽을 수 있는 단위로 분해하는 연구 분야입니다. 출력만 보고는 알 수 없는 의도와 중간 상태를 확인하려는 목적으로 감시 설계와 직접 이어집니다.
- 오픈웨이트학습이 끝난 모델의 가중치 파일을 내려받아 직접 돌릴 수 있게 푼 것입니다. 소스 전체를 여는 오픈소스와 다르고, 내려받을 수 있다는 말과 상업적으로 써도 된다는 말도 다릅니다. 라이선스를 따로 봐야 합니다.
- LLM수천억 개 단어를 학습해 다음 토큰을 예측하는 모델입니다. 질문에 답하고 글을 쓰고 코드를 짜는 일이 모두 '다음에 올 말 맞히기'에서 나옵니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.