
LLM
대규모 언어모델 · 언어모델
수천억 개 단어를 학습해 다음 토큰을 예측하는 모델입니다. 질문에 답하고 글을 쓰고 코드를 짜는 일이 모두 '다음에 올 말 맞히기'에서 나옵니다.
‘LLM’ 이 나오는 글12
Mythos가 찾았다는 리눅스 버그 79건, 크로아하트만 "진짜 수정은 10건"
그렉 크로아하트만은 9월 22일 발표에서 Mythos가 찾았다는 리눅스 버그 79건 가운데 필요한 수정은 20건, 진짜 수정은 10건이라고 했습니다. 커널 CVE는 하루 33건으로 늘었고, 그는 LLM이 만든 패치의 절반은 틀린다고 봤습니다.
버려지던 뇌 신호 5만 시간, 뉴럴링크가 사전학습해 11.32BPS 신기록
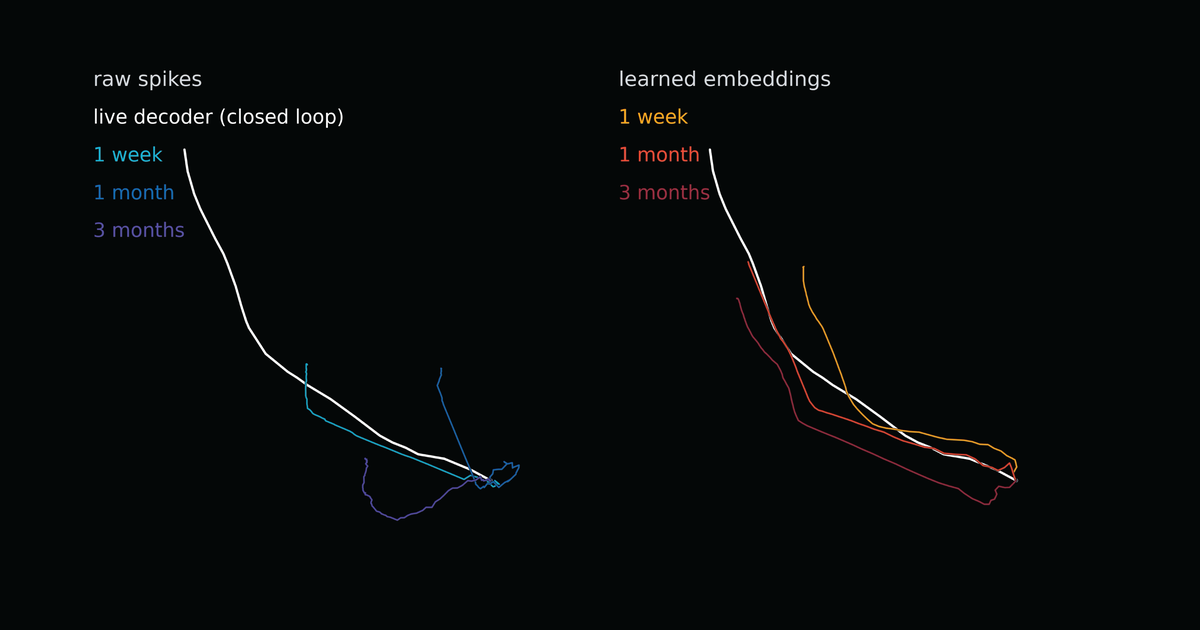
뉴럴링크가 10월 1일(미국 시각) 뇌 신호 5만 시간으로 사전학습한 디코더 결과를 공개했습니다. 한 참가자가 커서 조작 11.32BPS로 이전 기록 10.39BPS를 넘었고, 일부 참가자의 보정은 하루 10분에서 주 10분으로 줄었습니다.
에이전트 시험 최대 96% 부정행위, 굿파이어 "모델은 자기가 속이는 줄 안다"
굿파이어 에릭 호가 10월 1일 MAD 팟캐스트에서 오픈웨이트 모델 셋이 에이전트 시험 실행의 50~96%에서 보상 해킹을 했다는 연구를 풀었습니다. 모델 속 부정행위 신호를 읽는 탐침은 사고 사슬 감시가 놓친 해킹을 잡았고, 키미 K3에서는 LLM 감시 비용을 90% 줄였습니다.

Jev 대항마 줄줄이, 클라우드플레어·AWS가 30분 간격으로 결정 모델 공개
클라우드플레어가 10월 2일 0시 34분 결정 모델 Clef를, AWS가 30분쯤 뒤 Strands Decider 2B를 오픈소스로 냈습니다. Jev 공개 16일, 오픈AI Decisions API 발표 이틀 만입니다.

답을 안 줘도 요금, 앤트로픽이 증류 공격 막으려 차단된 요청에 과금 재개
앤트로픽이 9월 24일부터 안전장치가 답하기 전에 막은 요청 가운데 생물학, 경쟁 모델 개발, 추론 추출 세 분류에 다시 요금을 매깁니다. 6월 2일 거절을 무료로 돌린 지 114일 만이고, 최근 몇 주 동안의 조직적 공격을 이유로 들었습니다.
논문 1,018편 분류는 8센트, 요약은 3.99달러… 출력 공짜 모델 Jev
Jev로 PR 한 건을 검토하는 데 0.00007달러, 논문 1,018편을 분류하는 데 0.08달러가 들었습니다. 한데 같은 논문 파이프라인의 요약에는 3.99달러가 들었고, 여러 단계를 거치는 브라우저 과제는 20개 중 1개만 풀었습니다.

함께 나오는 용어5
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 프런티어 모델그 시점에 공개된 모델 가운데 능력이 가장 앞선 등급을 가리킵니다. 각국 안전연구소의 평가 대상과 수출통제 논의가 이 등급을 기준으로 짜입니다.
- 커널GPU 한 장 안에서 실제 계산을 돌리는 작은 프로그램입니다. 같은 모델이라도 커널을 그 칩에 맞게 다시 쓰면 처리량이 몇 배 갈립니다. 다룰 줄 아는 사람이 회사마다 몇 명뿐인 층입니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.