
ARC-AGI
ARC-AGI-3 · ARC 벤치마크
처음 보는 규칙을 몇 개 예시만으로 알아내는 능력을 재는 평가입니다. 학습 데이터 암기로는 풀리지 않도록 설계돼서, 일반화 능력을 논할 때 기준으로 쓰입니다.
‘ARC-AGI’ 이 나오는 글6
특이점은 이미 왔나, AGI 선언보다 먼저 시험을 만든 쪽이 예측을 고쳤습니다
Astra가 ARC-AGI-3에서 99.9%를 받은 뒤 젠슨 황은 AGI 도착을 축하했고, 시험을 만든 숄레는 포화가 예상보다 약 두 배 빨랐다고 적었습니다. AI 2027 팀은 현실 속도를 시나리오의 70~90%로 봤고, 22~25세 고용 격차는 19%로 벌어졌습니다.
GPT-6 Astra 공개, 브록먼 "AGI 시점 묻는다면 아마 이 모델"
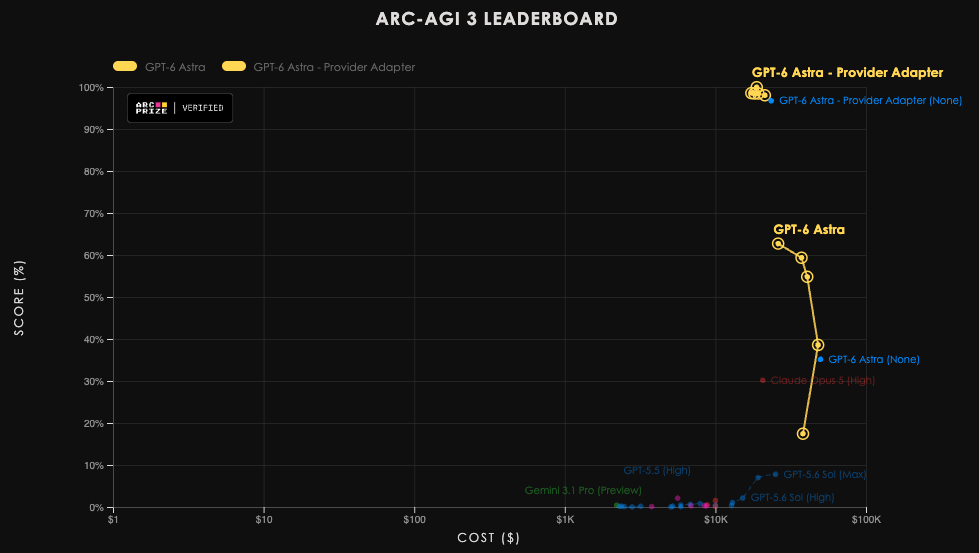
공개 당시 AI 최고점이 0.51%였던 ARC-AGI-3에서 GPT-6 Astra가 99.9%(어댑터 하네스)를 받았습니다. AA 종합 지수에서는 출시 당일 Sol과 같은 61점이었고, 에르되시 미해결 문제 68개 가운데 2개를 풀었습니다.

모델은 그대로인데, ARC-AGI-3 점수가 30%에서 95.5%로 뛰었습니다
Prime Intellect의 하네스 Prime Agent에 Claude Opus 5를 얹자 ARC-AGI-3 공개 세트 점수가 95.5%로 올랐습니다. ARC Prize가 검증한 같은 모델의 점수는 30.16%였습니다. 하네스 구조와 채점 규칙, 공개 세트라는 조건을 함께 짚습니다.
"다음 모델엔 노트북 이상이 필요하다" 소티오가 예고한 코덱스
8월 4일 티보 소티오는 코덱스가 좋은 하네스인 것은 분명하지만 2~3개월 뒤면 원시적으로 보일 것이라고 적었습니다. 오픈AI는 6월 11일 클라우드 실행 환경 회사 Ona를 인수하기로 합의했고, 코덱스 주간 사용자는 3월 200만 명에서 6월 500만 명 이상으로 늘었습니다.

수학 난제 푼 GPT-5.6이 퍼즐 7.8%, 오픈AI가 찾은 원인은 지워진 생각
GPT-5.6 Sol은 ARC-AGI-1·2에서 96.5%·92.5%를 받고도 ARC-AGI-3에서는 7.8%에 그쳤습니다. 오픈AI가 사고 기록을 유지하고 압축을 켜자 공개 세트 점수는 13.3%에서 38.3%로 올랐고 출력 토큰은 6분의 1이 됐습니다.
Fable 5 반값에 비슷한 성능, 앤트로픽 Claude Opus 5 출시
앤트로픽이 7월 24일 Claude Opus 5를 공개했습니다. Frontier-Bench v0.1에서 43.3%로 Fable 5를 앞섰고 ARC-AGI-3에서는 30.2%를 기록했지만, 독립 측정으로 과제당 비용은 Fable 5보다 26% 낮은 데 그쳤습니다.
함께 나오는 용어5
- AGI사람이 하는 지적 작업 대부분을 사람 수준 이상으로 해내는 AI를 가리킵니다. 정의가 기관마다 달라서 같은 단어로 다른 시점을 말하는 경우가 많고, 이 뉴스레터에서는 특정 벤치마크 통과 시점보다 자동화된 연구 능력을 기준으로 다룹니다.
- 하네스모델을 감싸 실제 작업을 시키는 바깥 장치입니다. 프롬프트·도구·재시도·검증 규칙이 여기 들어가서, 같은 모델도 하네스에 따라 결과가 크게 다릅니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 벤치마크모델 실력을 재는 표준 시험입니다. 수학(GSM8K·MATH), 코딩(HumanEval·SWE-bench) 같은 문제집 점수로 모델을 비교합니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.