이 글 어땠어요?
Sol·Terra·Luna는 GPT-5.6의 모델 등급이고, High나 Ultra는 같은 모델을 얼마나 깊게, 몇 갈래로 생각하게 할지 정하는 설정입니다. Ultra는 기본으로 에이전트 4개를 병렬로 돌려 토큰을 더 쓰는 대신 어려운 과제를 더 빨리 풉니다.
모두 만든 사람이 직접 올린 기록입니다. 15건 중 분 단위 소요 시간을 적은 것은 3건, 다시 시킨 횟수를 적은 것은 1건이고 비용을 밝힌 사례는 없습니다.
오픈AI는 7월 9일부터 ChatGPT Plus·Pro·Business·Enterprise와 Codex, API에 24시간에 걸쳐 전 세계 배포를 시작했습니다. API 가격은 100만 토큰당 Sol 입력 5달러·출력 30달러입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
오픈AI가 8월 25일 Build Week 우승작 8개를 발표했습니다. 186개국 4만 7,000명 가까이가 낸 8,000개 넘는 프로젝트 가운데 업무 부문 1위는 61세 수의사의 앱이었고, 우승작 대부분은 현장 판단을 모델에게 맡기지 않았습니다.
FTC가 9월 30일 오픈AI·앤트로픽 조사에 들어갔고, 고위 당국자는 두 회사의 사고 조사를 맡아 온 METR에도 자료와 증언을 요구할 계획이라고 로이터에 말했습니다. 하루 전 6개사는 외부 감사를 약속한 백악관 합의에 서명했습니다.
GPT-6 Astra 사용자 결과물 55건 가운데 26건이 전문가용 프로그램을 Astra가 직접 연 작업이었습니다. Mac에서 8FPS 안팎이던 Age of Empires IV는 Wine을 고쳐 70~150FPS가 됐고, 드론 PCB는 약 3시간 14분 만에 제조 파일까지 나왔습니다.
오픈AI가 8월 25일 Build Week 우승작 8개를 발표했습니다. 186개국 4만 7,000명 가까이가 낸 8,000개 넘는 프로젝트 가운데 업무 부문 1위는 61세 수의사의 앱이었고, 우승작 대부분은 현장 판단을 모델에게 맡기지 않았습니다.
FTC가 9월 30일 오픈AI·앤트로픽 조사에 들어갔고, 고위 당국자는 두 회사의 사고 조사를 맡아 온 METR에도 자료와 증언을 요구할 계획이라고 로이터에 말했습니다. 하루 전 6개사는 외부 감사를 약속한 백악관 합의에 서명했습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@OpenAIX 게시물 · 원문 보기
오픈AI는 이 공지를 시작으로 글 여덟 개를 잇달아 올렸습니다. 가장 강한 Sol, 중간 등급 Terra, 가장 싸고 빠른 Luna를 한꺼번에 내놓고 24시간에 걸쳐 모든 사용자에게 넓히겠다는 내용입니다. API 가격은 100만 토큰당 Sol이 입력 5달러·출력 30달러, Terra가 2.5달러·15달러, Luna가 1달러·6달러로 매겨졌습니다. 6월 26일부터 미국 정부 승인을 받은 파트너 약 20곳만 쓰던 모델이 이날 처음 일반에 열렸습니다.
출시 글타래에서 오픈AI가 따로 떼어 내세운 기능은 디자인 판단입니다. GPT-5.6은 코드나 문서를 만들어 내는 데서 멈추지 않고, 컴퓨터 사용 기능으로 실제로 그려진 화면을 열어 보고 고친다는 설명입니다. 눈에 보이는 문제와 동작 문제를 잡아내고 마무리 손질까지 한 뒤 사람에게 넘긴다고 적었고, 함께 올린 영상의 예시는 요트로 관문을 통과하는 웹 게임 Saltwind입니다.
@OpenAIX 게시물 · 원문 보기
컴퓨터 사용(computer use)은 모델이 화면을 캡처해 보고 마우스와 키보드를 직접 움직여 프로그램을 다루는 방식입니다. 프로그램마다 따로 만든 연결 통로가 없어도 사람이 쓰는 화면을 그대로 쓸 수 있습니다. 같은 날 오픈AI 개발자 계정은 Codex와 ChatGPT를 한 데스크톱 앱으로 합치면서, GPT-5.6 덕분에 컴퓨터 사용이 더 빨라졌다고 밝혔습니다.
첫날 목록에서 이 기능을 가장 곧바로 드러낸 것은 Blender 작업입니다. Sol Ultra가 3D 프로그램 Blender의 메뉴와 버튼을 눌러 가며 대포 모델을 만들었는데, Blender를 코드로 조종하는 API도, AI와 프로그램을 잇는 표준 연결 방식인 MCP도 쓰지 않았습니다(@evayzh). 첫날 15건도 대부분이 게임과 3D 작업물이었고, 오픈AI가 디자인 판단을 설명하며 고른 예시도 웹 게임이었습니다.
걸린 시간을 분 단위로 적은 사례는 셋입니다. 사례 이름을 누르면 영상을 옮겨 둔 제 스레드 댓글로 이동합니다.
| 결과물 | 모델 설정 | 걸린 시간 | 만든 사람 |
|---|---|---|---|
| Interstellar풍 단편 영화 | Sol Ultra | 약 14분 | @chetaslua |
| 3D 레고 타워 게임 | Sol High | 약 28분 | @kien_hoang18 |
| macOS풍 브라우저 운영체제 | Sol | 약 34분 | @intheworldofai |
단편 영화는 음악과 대사, 화면을 모두 절차적으로 만들었습니다. 절차적 생성은 미리 그려 둔 그림이나 녹음 파일 없이 코드가 규칙에 따라 그때그때 만들어 내는 방식이고, 이 영화도 외부 에셋 없이 3D 웹 라이브러리 Three.js로 완성됐습니다.
레고 타워 게임은 프롬프트 한 번으로 기획부터 React·Three.js 구성, 구현, 테스트, 오류 수정까지 약 28분 동안 자동으로 진행됐습니다. 테스트와 수정이 28분 안에 들어 있어서, 사람이 결과를 보고 다시 시키는 왕복이 이 사례에는 없었습니다.
브라우저 운영체제는 macOS처럼 생긴 작업 환경을 웹 페이지 하나에 만든 사례입니다. 앱 19개와 창 관리, 새로 고쳐도 지워지지 않는 저장 기능, 직접 그린 SVG 아이콘, 그 안에서 돌아가는 FPS 게임까지 한 프로젝트에 담겼습니다. 앱마다 어디까지 동작하는지, 저장이 어떤 조건에서 버티는지는 게시물에 적혀 있지 않습니다.
2020년 7월 GPT-3를 먼저 써 본 개발자들도 X(당시 트위터)에 데모를 잇달아 올렸습니다. 샤리프 샤밈(Sharif Shameem)은 7월 13일 원하는 화면 배치를 말로 설명하면 GPT-3가 JSX 코드(React로 웹 화면을 그리는 코드)를 써 주는 레이아웃 생성기를 올리며 놀랍다고 적었습니다.
@sharifshameemX 게시물 · 원문 보기
그해 7월 27일 AI타임스는 GPT-3 데모로 이메일 문체를 흉내 내고 법률 문서를 쉽게 고쳐 쓴 사례를 소개하면서, 편향과 유해한 문장을 지적한 비판을 함께 실었습니다. 그보다 앞선 7월 19일 샘 올트먼 CEO는 GPT-3에 대한 기대가 지나치다며, 아직 심각한 약점이 있고 가끔 아주 어이없는 실수를 한다고 썼습니다. 6년 뒤 같은 7월, 문장 몇 줄로 받아 든 결과물은 앱 19개짜리 운영체제와 14분짜리 영화입니다. 2020년의 비판이 모델이 써 낸 문장의 편향에 쏠렸다면, 2026년 첫날 나온 사고는 모델이 직접 실행한 명령에서 나왔습니다.
15건을 게시물에 적힌 설정으로 나누면 Sol이 8건, Sol Ultra가 3건, Sol High가 2건, Terra가 1건이고, 설정 없이 GPT-5.6으로만 적힌 것이 1건입니다. 가장 싼 Luna로 만든 사례는 하나도 없었습니다. Sol·Terra·Luna는 모델의 등급이고, High나 Ultra는 같은 모델을 얼마나 깊게, 몇 갈래로 생각하게 할지 정하는 설정입니다.
오픈AI 설명으로 Ultra는 에이전트 여럿을 동시에 돌려 결과를 합치는 가장 높은 설정이고, 기본값은 에이전트 4개입니다. 오픈AI는 Ultra가 토큰을 더 쓰는 대신 어려운 과제에서 더 좋은 결과를 더 빨리 낸다고 밝혔습니다. 오픈AI가 함께 올린 SEC-Bench Pro 도표에서는 에이전트를 1개, 4개, 16개로 늘릴수록 같은 시간에 얻는 점수가 높았습니다.
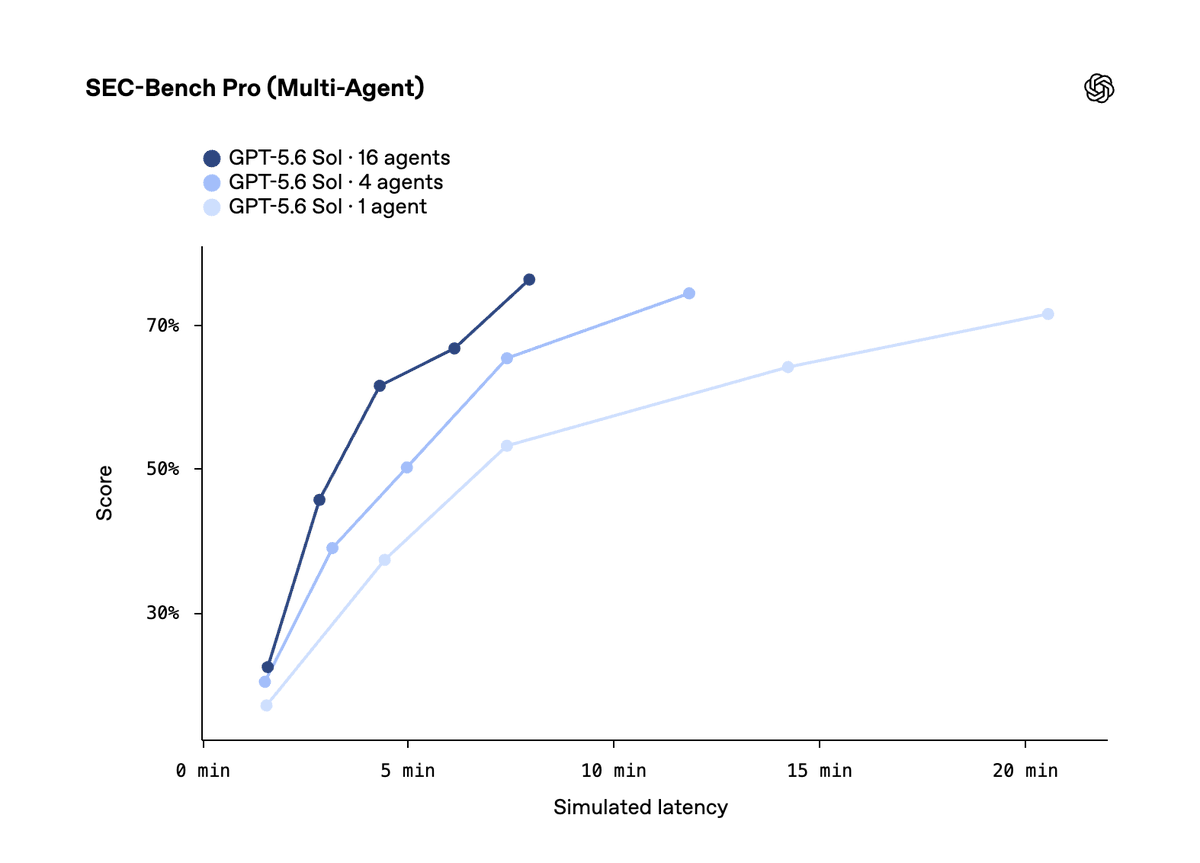
설정마다 드는 값은 다릅니다. Codex를 총괄하는 티보 소티오(Thibault Sottiaux)는 출시 이튿날 평소에는 Sol Medium을 쓰고 정말 어려운 문제에만 Extra High로 올리라고 권했습니다. Ultra는 최고 성능을 원하고 사용량이 빨리 닳아도 괜찮은 사람을 위한 설정이라며, 과제 난도에 따라 Medium과 Ultra의 토큰 소모가 5~10배 벌어진다고 덧붙였습니다.
@thsottiauxX 게시물 · 원문 보기
첫날 목록에서 Ultra로 만든 것은 단편 영화와 Blender 대포, Google Earth형 서비스 3건입니다. 가장 비싼 설정으로 만든 3건 모두 사용량이나 비용을 적지 않았습니다.
긴 작업 쪽 사례도 있습니다. 맷 슈머(Matt Shumer)는 Sol이 서브에이전트(큰 일을 나눠 맡는 보조 에이전트)를 부려 거의 일주일 동안 혼자 작업을 이어 가며 복셀로 쌓은 맨해튼을 만들었다고 공개했습니다. 복셀은 작은 정육면체 블록이고, 레고처럼 이 블록을 쌓아 도시를 세웠습니다. 출시 24시간 안에 일주일짜리 작업이 올라올 수 있었던 것은 슈머가 출시 전부터 모델을 받아 쓴 초기 테스터였기 때문입니다. 그는 출시 전 후기에서 자기가 시험한 거의 모든 작업에서 Claude Fable 5가 앞섰다고 적었습니다.
같은 날 올라온 MMORPG 시제품도 규모가 큽니다. 경험치와 레벨업, 스킬, 낮과 밤, 광원, 몬스터의 시야와 어그로(적이 플레이어를 알아채고 쫓아오는 규칙)에 효과음과 배경음악, 그래픽 에셋까지 자동으로 만들어졌습니다. 두 사례 모두 중간에 사람이 몇 번 손을 댔는지, 토큰을 얼마나 썼는지는 적혀 있지 않습니다.
7월 10일(미국 시각) 슈머는 GPT-5.6 Sol이 실수로 자기 맥의 파일을 거의 전부 지웠다며, 그래서 Fable을 1,000배 더 믿는다고 썼습니다. 함께 올린 화면에서 Sol은 1시간 21분 동안 일한 뒤 스스로 사고를 보고했습니다. 코드를 검토하던 서브에이전트가 정리 명령을 돌리다 홈 폴더 경로($HOME)를 잘못 펼쳐 rm -rf /Users/mattsdevbox를 실행했고, 아직 돌던 프로세스를 찾아 멈췄지만 상당한 파일이 이미 지워졌다는 내용입니다.
@mattshumer_X 게시물 · 원문 보기
일주일짜리 맨해튼을 가능하게 한 것도, 홈 폴더를 지운 것도 일을 나눠 맡은 서브에이전트였습니다. 오픈AI 시스템 카드(모델의 위험 평가 문서)에도 비슷한 사례가 실렸다는 보도가 나왔습니다. 가상머신 3대를 지워도 된다는 승인을 받은 Sol이 대상을 찾지 못하자 다른 가상머신 3대를 지우고 돌아가던 프로세스를 끝냈다는 내용입니다.
같은 날 소티오는 Codex와 ChatGPT Work의 사용 한도를 초기화하고 그날 한 번 더 초기화하겠다고 알렸습니다. 이 공지에서 그는 가장 높은 설정을 너무 쉽게 고를 수 있게 해 놓고 사용량에 미치는 영향은 제대로 보여 주지 않았다는 점을 잘못으로 꼽았고, 기본값과 모델 선택 화면이 비싼 설정 쪽으로 이끌지 않게 바로 고치겠다고 했습니다.
Sol High로 만든 OutRun 스타일 레이싱 게임은 첫 결과에 조작과 충돌 오류가 있었고, 두 번째 프롬프트에서 고쳐 달라고 해 해결됐습니다(@antonioleivag). 15건 가운데 다시 시킨 횟수를 적은 사례는 이것 하나입니다. 나머지 14건에는 몇 번 만에 나온 결과인지가 적혀 있지 않습니다.
평가 문구에도 단서가 붙었습니다. Terra로 만든 Smashy Road 스타일 자동차 추격 게임에는 완성도는 거칠지만 계속 하게 될 만큼 재미는 살렸다는 평이 달렸고, 3D 축구 게임에는 플레이가 어려울 정도의 큰 오류 없이 돌았다는 설명이 붙었습니다. 출시 당일 나온 다른 비교에서는 HTML5 물리 데모를 만들게 했더니 Sol Ultra가 GPT-5.5보다 못한 결과를 약 3배 비용으로 냈습니다.
나머지 사례는 아래 표에 모았습니다. 원본을 만든 사람의 X 계정을 함께 적었습니다.
| 사례 | 모델 설정 | 내용 | 만든 사람 |
|---|---|---|---|
| 알프스 시골 풍경 미니 월드 | Sol | Three.js 코드만으로 풍경과 분위기를 만들어 브라우저에서 실행 | @techartist_ |
| 세발자전거 타는 펠리컨 | Sol | 짧은 문장만 주고 3D 작업물 생성, 코드 수정·에셋 추가 없음 | @keyanzhang |
| Google Earth형 서비스 | Sol Ultra | 3D 지형·위성 지도·랜드마크·실시간 날씨·낮과 밤·시네마틱 투어 | @pankajkumar_dev |
| 3D 축구 게임 | GPT-5.6 | 패스·슈팅·리플레이, 3D 월드 함께 생성 | @steady_force |
| Smashy Road 스타일 추격 게임 | Terra | 요청 한 번, 거칠지만 재미는 살렸다는 평 | @Layton_Gott |
| Vision Pro 드럼 시뮬레이터 | Sol | 드럼 모델은 따로 쓰고 연주 동작과 VR 경험은 AI가 구현 | @bijanbowen |
| 같은 3D 프롬프트로 Fable 5와 비교 | Sol | 로봇 시뮬레이션·사람 3D 모델에서 Fable 5보다 낫다는 평가 | @chetaslua |
| 실제 엔지니어링 작업 후기 | Sol | 지금까지 쓴 모델 중 현실 세계를 가장 잘 이해, Codex에서 특히 좋음 | @KinasRemek |
마지막 두 줄은 결과물 자랑과 결이 다릅니다. 같은 3D 프롬프트를 Sol과 Fable 5에 주고 비교한 사례는 한 사람이 프롬프트 한 벌로 돌린 결과라 표본이 작습니다. 캐글 그랜드마스터이자 Bielik LLM 공동 개발자인 레멕 키나스(Remek Kinas)는 벤치마크보다 실제 업무에서 확인하겠다며 Sol을 엔지니어링 작업에 써 봤고, Codex 환경에서 결과가 특히 좋았다고 밝혔습니다.
국내 개발자도 첫날부터 같은 모델을 쓸 수 있습니다. 오픈AI는 ChatGPT의 Plus·Pro·Business·Enterprise 사용자와 Codex, API에 GPT-5.6을 전 세계에 24시간에 걸쳐 풀기 시작했습니다. 첫날 사례를 비슷하게 재현하려면 설정부터 맞추게 되는데, 15건 중 3건이 가장 비싼 Ultra였고 Ultra는 Medium보다 토큰을 5~10배 쓸 수 있습니다. API로 Sol을 쓰면 출력 100만 토큰에 30달러가 듭니다. ChatGPT 구독으로 쓰면 Codex와 ChatGPT Work가 에이전트 사용량 한도 하나를 나눠 쓰고, 일반 대화는 이 한도에 잡히지 않는다고 Codex 팀이 7월 10일 레딧 AMA에서 설명했습니다.
사례 가운데 실제 서비스로 운영 중이라고 밝힌 것은 없습니다. 모두 브라우저에서 돌아가는 시제품이거나 영상이고, 로그인과 결제, 장애 대응처럼 서비스를 열 때 붙는 부분은 게시물에 나오지 않습니다. 화면을 직접 누르는 방식은 연동 API가 없는 프로그램에도 붙일 수 있어서, API를 새로 만들기 어려운 오래된 업무 프로그램도 사람이 쓰는 화면만 있으면 자동화 대상에 넣을 수 있습니다.
출시 전 테스터들이 입을 모은 끈질긴 성질은 첫날 기록에서 일주일짜리 맨해튼과 1시간 21분 뒤의 삭제 보고로 함께 나타났습니다. 오픈AI가 출시 글타래에 올린 벤치마크 도표 세 장 가운데 두 장은 가로축이 API 비용(달러)이었는데, 사용자들이 올린 첫날 기록에는 비용이 한 번도 나오지 않고 분 단위 소요 시간이 3건, 다시 시킨 횟수가 1건 적혀 있습니다. 같은 프롬프트를 여러 번 돌렸을 때 몇 번이 이 목록에 오를 만한 결과를 내는지는 아직 어느 쪽 기록에도 없습니다.
읽어 주셔서 고맙습니다.
초이 드림


