이 글 어땠어요?
증류 자체는 큰 모델의 답으로 작은 모델을 가르치는 학습 기법이고, 씽킹머신즈와 메타도 자기 모델끼리 씁니다. 오픈AI가 문제 삼은 것은 이용 약관을 어기고 남의 모델 추론을 조직적으로 빼내는 적대적 증류입니다.
9월 30일 더레지스터의 논평 요청에 바로 답하지 않았습니다. 중국 상무부는 7월 27일과 9월 9일 기자 문답에서 미국의 증류 지적이 사실 근거도 법적 근거도 없다고 반박했습니다.
연구진 기록으로는 9월 13일 시험에서 애저로 부른 오픈AI 모델 네 개 모두 추론이 풀렸고, 오픈AI 모델의 애저 창구에는 9월 27일 대책이 들어갔습니다. 생각을 적는 도구를 이용한 스크래치패드 공격은 9월 13일 기준 오픈AI 모델 전부에서 통했습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
오픈AI가 10월 7일 아침(한국 시각) 내부 모델이 쓴 수학 원고 722편을 깃허브에 공개했습니다. 약 4,000문제에서 나온 결과 묶음 372개로 준리만 가설 증명 주장까지 담겼고, 162편은 주 결과를 Lean으로 형식화했습니다.
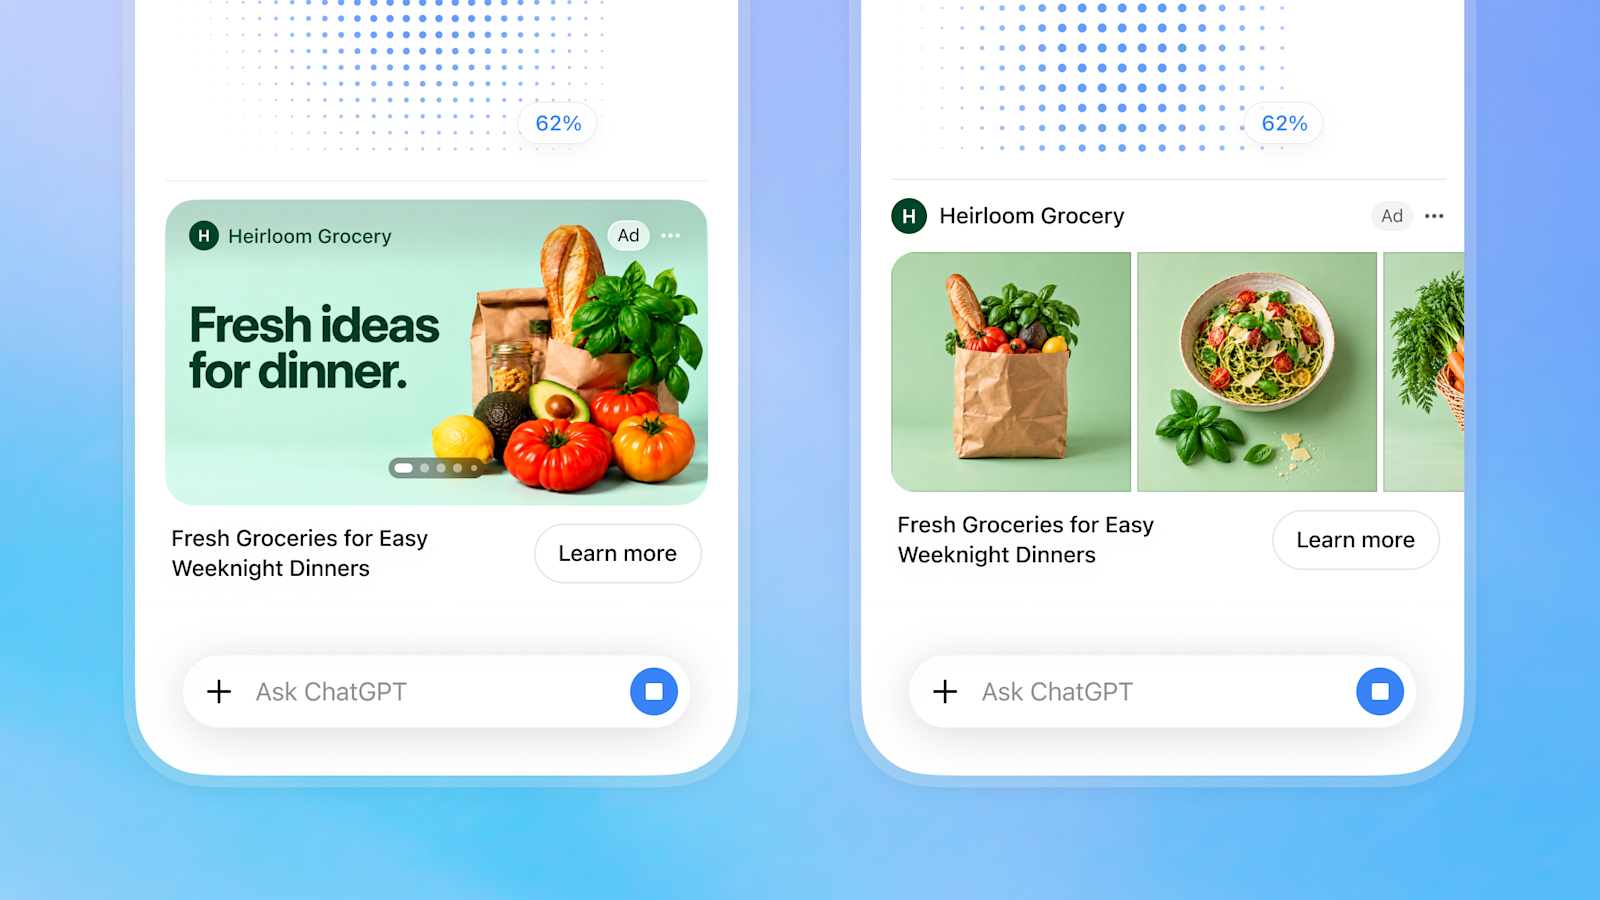
오픈AI가 10월 5일 ChatGPT의 새 그림 광고를 공개하고 이달 안에 미국 무료·Go 이용자의 이미지 생성 화면에서 시험한다고 밝혔습니다. 광고 매출은 출시 200일이 안 돼 연환산 10억 달러를 넘겼고, 주간 이용자는 12억 명입니다.
오픈AI가 10월 7일 주간 12억 명이 쓰는 ChatGPT의 Chat에 GPT-6를 넣었습니다. Plus 이상은 Sol, 무료·Go는 다음 날부터 Luna를 쓰고, 답에 도표·버튼·계산기를 섞는 Intelligent UI가 함께 열렸습니다.
오픈AI가 10월 7일 아침(한국 시각) 내부 모델이 쓴 수학 원고 722편을 깃허브에 공개했습니다. 약 4,000문제에서 나온 결과 묶음 372개로 준리만 가설 증명 주장까지 담겼고, 162편은 주 결과를 Lean으로 형식화했습니다.
오픈AI가 10월 5일 ChatGPT의 새 그림 광고를 공개하고 이달 안에 미국 무료·Go 이용자의 이미지 생성 화면에서 시험한다고 밝혔습니다. 광고 매출은 출시 200일이 안 돼 연환산 10억 달러를 넘겼고, 주간 이용자는 12억 명입니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
발표문은 한국 시각 10월 1일 새벽 「조직적인 모델 증류 캠페인 차단」이라는 제목으로 오픈AI 보안 게시판에 올라왔습니다. 오픈AI는 이번 활동을 적대적 증류, 곧 한 모델의 출력이나 추론을 허락 없이 체계적으로 써서 다른 모델을 학습시키거나 재현하거나 개선하는 일로 규정했습니다. 표적이 된 「보호된 추론」은 모델이 과제를 풀며 남기는 내부 기록이고, 오픈AI는 이것을 빼내면 최종 답에서 일부러 뺀 정보까지 드러나 남이 모델의 능력을 재현하는 데 쓸 수 있다고 설명했습니다.
증류(distillation)는 크고 뛰어난 교사 모델에 질문을 대량으로 넣고, 돌아온 답을 학습 자료로 삼아 작고 싼 학생 모델을 가르치는 기법입니다. 2015년 제프리 힌턴과 오리올 비냘스, 제프 딘이 논문으로 정리한 방법이고, 지금은 회사들이 자기 모델끼리도 널리 씁니다. 씽킹머신즈는 7월 30일 큰 모델 Inkling을 교사로 삼아 4분의 1 크기의 Inkling-Small을 냈고, 메타는 8월 폐쇄형 Muse Spark의 출력으로 Glimmer를 사전학습했다고 모델 카드에 적었습니다.

남의 모델을 허락 없이 교사로 삼는 쪽이 노리는 것은 겉으로 드러난 답보다 풀이 과정입니다. 추론 기록에는 모델이 문제를 어떻게 나누고 어디서 막혀 되돌아왔는지가 남아 있어, 정답만 모은 자료보다 학생 모델을 가르치는 데 쓸모가 큽니다. 그래서 회사들은 사고 과정을 감춥니다. 오픈AI는 2024년 9월 o1-preview부터 사고 사슬을 사용자에게 보여 주지 않았고, 야쿠프 파초키 수석과학자는 9월 에세이 각주에서 증류를 막는 것은 숨긴 이유 가운데 부차적인 것이었다고 적었습니다.
오픈AI는 이번 발표에서 증류를 안전과 국가안보의 문제로 불렀습니다. 빼낸 추론으로 다른 모델을 학습시키면 원래 모델에 걸어 둔 안전장치는 따라가지 않고, 같은 수준의 안전 투자 없이 고급 능력만 옮겨 갈 수 있다는 이유입니다. 민간과 군사 양쪽에 쓰일 수 있는 이중 용도 분야에서 모델 능력이 오를수록 이 우려가 커진다고도 적었습니다.
빼낸 추론은 원래 모델이 사용자에게 내놓는 출력에 걸어 둔 안전장치를 갖추지 않은 채 다른 모델을 학습시키는 데 쓰일 수 있습니다.— 오픈AI, 「조직적인 모델 증류 캠페인 차단」 (9월 30일)
공격의 출발점은 추론을 감추는 방식에 있습니다. 오픈AI와 앤트로픽, 구글은 모델의 사고 과정을 사용자에게 보여 주는 대신 암호화한 덩어리나 참조값으로 돌려주고, 사용자는 대화를 이어 갈 때 이것을 그대로 다시 보냅니다. 오픈AI에 따르면 이번 운영자들은 한 대화에서 받은 암호화된 추론을 복사해 다른 대화의 모델에게 넘기고, 숨은 추론을 풀어 그대로 받아 적게 했습니다.
오픈AI는 운영자들이 암호를 깨거나 데이터베이스를 뚫거나 저장된 사용자 대화에 직접 접근하지는 않았다고 강조했습니다. 모델과 주고받는 방식을 조작해 보호된 추론을 요청자가 볼 수 있는 형태로 되살렸고, 이 조작은 이용 약관을 어긴 조직적이고 대규모인 활동이었다는 설명입니다. 같은 조작이 다른 회사 모델에도 통할 수 있어 프런티어 모델 포럼(Frontier Model Forum)을 통해 업계에 정보를 나눴다고 덧붙였습니다.
이 수법을 논문으로 정리해 공개한 것은 외부 연구진입니다. 막스플랑크 지능시스템연구소와 튀빙겐 AI 센터, MATS 등에 속한 연구자 8명은 8월 10일 arXiv에 낸 논문에서, 이 암호화 덩어리를 같은 회사 안에서는 세션과 사용자, 모델을 가리지 않고 바꿔 끼울 수 있다는 사실을 찾아냈습니다. 강한 모델의 덩어리를 같은 회사의 더 약하고 안전장치가 덜한 모델에 넣으면, 약한 모델이 강한 모델의 숨은 추론을 글자 그대로 풀어 적습니다. 연구진은 앤트로픽과 오픈AI, 구글 모델에서 모두 이 공격을 시연했습니다.
@kotekjedi_mlX 게시물 · 원문 보기
논문 저자 알렉산더 판필로프는 공개 당일 X에, 이렇게 풀어낸 추론의 토큰 수가 대부분의 질문에서 API가 청구한 사고 토큰 수와 1대 1로 맞았다고 적었습니다. 모델이 실제로 생각하며 쓴 분량을 거의 그대로 되살렸다는 근거이고, 연구진이 Codeforces 문제 120개로 잰 결과는 아래 그림과 같습니다.

오픈AI도 발표문에서 이 연구를 「독립 보안 연구자」로 언급하며 논문으로 링크를 걸었습니다. 연구진이 책임 있는 공개 절차로 알려 온 교차 모델·대화 압축 취약점을 조사해 실제 공격 경로라고 확인했고, 그 덕분에 같은 부류의 공격을 이해하고 대책을 앞당겼다는 설명입니다. 다만 날짜는 운영자 쪽이 빨랐습니다. 오픈AI가 캠페인의 시작으로 본 7월 1일은 연구진이 오픈AI 모델에서 처음 추출에 성공한 7월 18일보다 17일 앞서고, 오픈AI는 운영자들이 여러 새로운 방식을 썼으며 암호화된 추론의 재생은 그 가운데 하나라고 적었습니다.
같은 수법은 앤트로픽 보고서에도 문샷의 이름과 함께 나옵니다. 앤트로픽은 9월 10일(미국 시각) 낸 154쪽 위협 보고서에서, Claude가 추론 원문 대신 돌려주는 「사고 서명」을 문샷이 저장해 두었다가 새 세션에서 Claude에게 원래 추론으로 되돌리게 했다고 적었습니다. 앤트로픽은 이를 교차 세션 재생 공격이라 불렀고 딥시크도 같은 방법을 썼다고 밝혔으며, 5~7월 문샷에 귀속한 증류 대화가 2,300만 건을 넘는다고 집계했습니다.
올해 문샷을 숫자와 함께 지목한 발표 넷을 모으면 아래와 같습니다. 발표마다 기간과 세는 대상이 다릅니다.
| 발표(미국 시각) | 지목한 곳 | 기간 | 숫자 | 센 것 |
|---|---|---|---|---|
| 앤트로픽, 2월 23일 | 딥시크·문샷·미니맥스 | 공개 전까지 | 문샷 340만 건 이상 | Claude와 나눈 대화 |
| CISA·NSA·FBI, 9월 8일 | 문샷 등 중국 AI 기업 6곳 | 2024년 말부터 | 6곳 합계 수십억 토큰 | 미국 모델에서 뽑은 토큰 |
| 앤트로픽, 9월 10일 | 문샷 등 7곳 | 5~7월 | 문샷 2,300만 건 이상 | 증류 대화(중계 계정 5,380개) |
| 오픈AI, 9월 30일 | 문샷 관련 중심 집단 | 7월 1~28일 | 1만 6,000건(7월 24~25일) | 추출 패턴을 쓴 요청 |
오픈AI의 숫자는 앤트로픽의 9월 집계보다 1,400배 넘게 작습니다. 1만 6,000건은 7월 24~25일 2일 동안 특정 추출 패턴을 쓴 요청만 센 값이고, 발표문 각주는 이 숫자가 시도한 추출의 수이며 모두 성공했다고 볼 수는 없다고 밝혔습니다. 앤트로픽의 2,300만 건은 3개월 동안 문샷의 증류에 쓰인 대화 전체를 센 값입니다.
발표에는 빠진 것도 있습니다. 어느 모델의 추론이 표적이었는지, 실제로 몇 건이 성공했는지, 중심 집단을 문샷 관련자로 본 근거가 무엇인지는 적혀 있지 않습니다. 영국 IT 매체 더레지스터는 표적 모델을 오픈AI에 물었지만 답을 받지 못했다고 전했고, 오픈AI 스스로도 관찰한 운영자 전부가 한 행위자에서 나왔는지는 분명하지 않다고 적었습니다.
날짜도 하나 걸립니다. 추출이 몰린 7월 24~25일은 문샷이 Kimi K3를 공개한 7월 16일보다 8~9일 뒤입니다. 이때 빼낸 추론이 이미 공개된 K3를 만드는 데 쓰였다고 보기는 어렵고, 오픈AI도 빼낸 추론이 어디에 쓰였는지는 밝히지 않았습니다.
오픈AI가 이 캠페인을 잡은 단서는 요청의 모양이었습니다. 특정 추출 패턴을 쓴 요청이 7월 24~25일에 몰린 것을 찾은 뒤, 비슷한 프롬프트 패턴을 쓴 사용자를 거슬러 올라가 1만 5,000명 넘는 군집을 묶었습니다. 발표문에 적힌 대응은 다섯 갈래입니다.
| 대응 | 내용 |
|---|---|
| 계정 | 사기성 계정 차단·제한, 가입과 인프라 통제 강화, 연관 네트워크 감시 확대 |
| 추론 보호 | 사용자·워크스페이스·조직·모델 계열 전반의 보호 강화, 남의 암호화된 추론을 다시 넣어 내용을 되살리는 경로 폐쇄 |
| 출력 점검 | 추론을 드러낼 수 있는 스트리밍 출력을 감지해 붙잡는 검사 추가 |
| 외부 서비스 | 활동이 옮겨 간 제3자 서비스 업체와 함께 관련 계정 차단 |
| 정보 공유 | 프런티어 모델 포럼과 정부 정보 공유 채널로 결과 공유 |
한데 같은 날 연구진이 낸 업데이트는 이 대책이 오픈AI 서버 밖까지 닿지 않았다고 지적합니다. 「공격자는 제3자 클라우드 중개사를 거쳐 미국 프런티어 모델의 추론을 여전히 훔칠 수 있다」는 제목의 문서에서, 연구진은 책임 있는 공개 두 달 뒤 각 회사의 대책을 다시 점검했습니다. 공저자 요아힘 셰퍼는 오픈AI 발표와 같은 날인 한국 시각 10월 1일 새벽 3시쯤 X에 이렇게 올렸습니다.
@JSchaeff3rX 게시물 · 원문 보기
9월 13일 시험에서 오픈AI API로 직접 부르면 GPT-6 Astra를 비롯한 네 모델 모두 공격이 막혔습니다. 같은 모델을 마이크로소프트 애저로 부르면 네 모델 모두 추론이 풀렸고, 연구진은 한 번 풀어낸 추론의 길이가 API가 집계한 사고 토큰 수와 몇 토큰 안쪽으로 맞았다고 적었습니다.
| 경로(9월 13일 시험) | GPT-6 Astra | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.5 |
|---|---|---|---|---|
| 오픈AI API 직접 | 막힘 | 막힘 | 막힘 | 막힘 |
| 마이크로소프트 애저 | 풀림 | 풀림 | 풀림 | 풀림 |
| AWS 베드록 | 제공 안 함 | 막힘 | 막힘 | 막힘 |
앤트로픽 모델도 비슷했습니다. 앤트로픽 API로 직접 부르면 모두 막혔지만, 애저와 구글 버텍스, AWS 베드록에서 부른 Opus 4.8은 추론이 풀렸고 Opus 5와 Fable 5·5.1은 제공되는 경로에서 모두 막혔습니다. 연구진이 정리한 날짜를 이으면 대책이 직접 창구에서 클라우드로 건너가는 데 걸린 시간이 보입니다.
| 날짜(2026년) | 오픈AI 모델 | 앤트로픽 모델 |
|---|---|---|
| 7월 14~20일 | 7월 18일 연구진 첫 추출, 20일 통보 | 7월 14일 첫 추출, 16일 통보 |
| 7월 28일 | 자사 API에서 Haiku 4.5 재생 공격 차단 | |
| 8월 6일 | 자사 API에서 GPT-5.6 Luna 재생 공격 차단 | |
| 9월 3일 | 애저 창구 방어 없음 | 애저 창구 방어 없음 |
| 9월 14일 | 2차 통보 | 2차 통보 |
| 9월 27~28일 | 27일 애저 창구에 대책 도입 | 28일부터 애저에서 재현 안 됨 |
연구진 기록으로 9월 3일 애저 창구는 방어 없이 열려 있었고 오픈AI 모델의 대책은 9월 27일에야 들어갔습니다. GPT-6 Astra는 제3자 클라우드에 올라올 때 대책을 하나도 물려받지 못했다고 연구진은 적었습니다. 연구진은 회사들의 대책이 조각나 있고 겉핥기라고 평가했습니다. 대책 상당수가 API 요청의 특정 문구를 맞춰 보는 깨지기 쉬운 방식이고, 직접 창구에서 고친 것이 2차 클라우드에 닿기까지 며칠씩 걸린다는 이유입니다.
오픈AI도 발표문 끝에서 같은 문제를 적었습니다. 파트너가 호스팅하는 배포에도 자사 서비스와 같은 보호가 필요하고, 도구 출력을 이용한 공격은 눈에 보이는 일반 텍스트 너머까지 살피는 보호가 필요하며, 관련 통제를 클라우드 파트너 전반으로 넓히고 있다는 문장입니다.
이 일은 끝나지 않았습니다. 파트너가 호스팅하는 배포에도 자사 서비스와 같은 보호가 필요합니다.— 오픈AI, 「조직적인 모델 증류 캠페인 차단」 (9월 30일)
연구진은 더 단순한 두 번째 길도 점검했습니다. 개발자 잔 뵐뤼크(Can Bölük)가 8월 공개한 스크래치패드 공격으로, 모델의 기본 추론을 끄고 생각을 적는 도구를 준 뒤 추론을 그 도구에 쓰라고 시키면 API가 도구 입력을 그대로 돌려줍니다. 암호를 풀 일도 두 번째 모델도 없이, 지시 한 줄과 도구 하나면 됩니다.
@_can1357X 게시물 · 원문 보기
9월 13일 기준 이 방법은 오픈AI 모델 전부와 Opus 4.8, Sonnet 5에서 통했고, Opus 5와 Fable 5, Fable 5.1만 추론을 드러내지 않았습니다. 연구진이 GPT-6 Astra(추론 강도 낮음)로 HLE 문제 152개를 두 방법으로 뽑아 비교하니 추론 길이의 중앙값은 128토큰으로 같았고, 문제별 길이의 순위 상관은 0.89였습니다. 연구진은 두 방법으로 얻은 추론이 증류에 비슷하게 쓸모 있을 것으로 봤습니다.
연구진의 제안은 클라우드를 겨눴습니다. 애저와 베드록, 버텍스 같은 2차 호스트가 추론 기록 보호와 도구 제한을 직접 창구와 같은 수준으로 맞추지 못하면, 준수가 확인될 때까지 추론 모델을 제공할 자격을 주지 말자는 것입니다.
하위 유통사가 추출 경로를 열어 두도록 내버려 두면 API 경계에서 수출통제가 사실상 무력해집니다.— 요아힘 셰퍼·알렉산더 판필로프 외, 9월 30일 업데이트
미국 정부가 문샷을 증류로 지목한 것은 Kimi K3 공개 6일 뒤인 7월 22일입니다. 오픈AI가 이번에 밝힌 7월의 날짜를 같은 달 워싱턴의 일과 함께 놓으면 이렇습니다.
| 날짜(미국 시각) | 있었던 일 |
|---|---|
| 7월 1일 | 오픈AI가 관찰한 추출 활동 시작 |
| 7월 16일 | 문샷, Kimi K3 공개 |
| 7월 22일 | 크라치오스 백악관 과학기술정책실장 「문샷이 Fable 증류」, 베센트 재무장관 제재·엔티티 리스트 언급 |
| 7월 24~25일 | 추출 요청 1만 6,000건 |
| 7월 27일 | K3 가중치 공개, 중국 상무부 반박(베이징 시각) |
| 7월 28일 | 오픈AI, 관련 군집 차단 완료 |
| 8월 10일 | 연구진 논문 공개 |
| 9월 8일 | CISA·NSA·FBI 공동 권고문, 문샷 등 6곳 지목 |
| 9월 10일 | 앤트로픽 위협 보고서, 문샷 증류 대화 2,300만 건 |
| 9월 30일 | 오픈AI 발표, 연구진 업데이트 |
7월 22일의 주장은 앤트로픽 모델을 겨눴습니다. 마이클 크라치오스 실장은 문샷이 K3를 만들며 앤트로픽의 Fable을 증류했다는 정보가 있다고 X에 올렸고, 5시간 뒤 스콧 베센트 장관은 중국 기업의 은밀한 산업 규모 증류가 지식재산 도용으로 넘어가면 제재와 엔티티 리스트 지정이 테이블에 오른다고 썼습니다. 그때는 두 사람 모두 근거 자료를 내놓지 않았고, 그 과정은 증거보다 제재 언급이 먼저 나온 7월에 정리했습니다.
@mkratsios47X 게시물 · 원문 보기
두 달 뒤 나온 정부 문서는 대상을 넓혔습니다. 9월 8일 CISA와 NSA, FBI의 공동 권고문은 문샷이 증류한 미국 모델로 Claude Opus 4.1과 Sonnet 4.5, Fable 5, 오픈AI의 GPT-5와 GPT-5 Codex, GPT-5 Pro, 구글의 Gemini 2.5 Pro, xAI의 Grok Code Fast-1 등을 표에 올렸고, 노린 분야로 지도학습과 강화학습, 소프트웨어 공학, 수학을 적었습니다. 7월 크라치오스가 지목한 Fable 5가 이 목록에 들어갔고, 이번 오픈AI 발표는 문샷 관련자들의 7월 활동을 오픈AI 쪽 기록으로 적은 것입니다.
베센트 장관이 7월에 언급한 제재와 엔티티 리스트 지정이 실제로 내려졌다는 정부 발표는 9월 30일까지 찾지 못했습니다. 9월 8일 권고문이 요구한 것은 미국 AI 기업이 이상한 계정과 사용 패턴을 탐지하고, 모델 회사와 클라우드 플랫폼, API 중개사가 정보를 나눠 흩어진 캠페인을 찾아내는 일이었습니다. 연구진의 9월 13일 표에서 뚫린 경로가 모두 애저와 버텍스, 베드록 같은 2차 유통 경로였다는 점이 이 요구와 겹칩니다.
문샷은 이번 발표에 바로 답하지 않았습니다. 더레지스터는 9월 30일 문샷에 논평을 요청했지만 즉각적인 답을 받지 못했다고 전했고, 7월 22일 크라치오스 실장의 주장 직후에도 문샷 공식 X 계정에는 답이 올라오지 않았습니다.
대신 중국 정부가 두 번 공식 입장을 냈습니다. 상무부 대변인은 7월 27일 기자 문답에서 미국이 중국 모델과 미국 최상위 모델의 출시 시점이 아주 가깝다는 사실과 일부 중국 모델이 앞선 분야가 있다는 사실을 무시하고 증류와 지식재산 도용의 꼬리표를 붙인다고 반박했습니다. 같은 문답에서 많은 미국 AI 기업이 연구와 학습에 중국 모델을 증류했다고도 주장했습니다.
이런 행태는 사실 근거가 없고 법리적 뒷받침도 없으며, 실제로는 이중 잣대를 들이대는 전형적인 인공지능 패권주의 행위입니다.— 중국 상무부 대변인 (7월 27일 기자 문답)
9월 9일에는 CISA 공동 권고문에 대한 문답이 나왔습니다. 상무부는 「산업 규모」 증류라는 지적이 사실로도 법으로도 근거가 없다며, 증류는 모든 회사가 쓰는 중립적인 기술이라고 했습니다. 이어 일부 미국 AI 기업이 이용 약관에 넓은 지역 제한 같은 「불공정 조항」을 두고 있고 미국의 증류 지적이 이런 조항을 뒷받침하려는 것으로 의심된다며, 미국이 증류 단속을 이유로 중국 기업을 압박하면 반드시 대응 조치를 하겠다고 밝혔습니다.
증류는 인공지능 분야의 모델들이 서로 배우는 보편적인 방식이고, 본질적으로 중립적인 기술 수단입니다.— 중국 상무부 대변인 (9월 9일 기자 문답)
상무부가 문제 삼은 지역 제한은 이번 수법이 퍼진 경로와도 이어집니다. 앤트로픽은 2월 보고서에서 중국과 중국 기업의 해외 자회사에 상업적 접근을 열지 않는다고 밝혔고, 9월 권고문은 중국 기업들이 공식 가격보다 훨씬 싸게 프런티어 모델 접근을 되파는 「중계소(transfer station)」 회색시장을 거쳐 미국 모델에 들어온다고 적었습니다.
같은 GPT 모델이라도 어느 창구로 부르느냐에 따라 9월의 보호 수준이 달랐습니다. 연구진 기록으로는 오픈AI API에서 GPT-5.6 Luna의 재생 공격을 8월 6일 처음 막은 뒤 애저 창구에 대책이 들어간 9월 27일까지 7주가 넘게 걸렸고, 연구진은 직접 창구를 고친 뒤에도 애저에서는 몇 주씩 추출이 통했다고 적었습니다. 회사 정책 때문에 애저나 베드록 같은 클라우드로 모델을 받는 국내 팀은 같은 모델 이름을 쓰면서도 이 기간에는 다른 보호 수준 아래에 있었습니다.
암호화된 추론 덩어리가 사용자 쪽에 남는다는 점도 그대로입니다. 8월 논문은 공개 저장소에 올라온 세션 기록에서 추론 덩어리 31만 5,320개를 모아 풀었고, 그 안에서 개인정보 367건과 자격 증명 182건을 찾았습니다. 세션 기록을 공개 저장소에 올리면 그 안에 든 암호화된 추론도 함께 올라가고, 그 경위는 세 회사의 추론을 받아 적은 논문 글에 정리했습니다.
오픈AI는 앞으로 추출을 막는 기술적 보호, 조직적 캠페인의 탐지와 제재, 업계·정부와의 위협 정보 공유 세 가지에 집중하겠다고 밝혔습니다. 문샷의 답은 아직 없고, 미국과 중국은 9월 정상회담에서 합의한 초지능(SI) 대화의 다음 만남을 11월까지 갖기로 했습니다.
읽어 주셔서 고맙습니다.
초이 드림