이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
200B~300B급 오픈웨이트는 사실 지식을 검색과 도구에 맡기고 추론과 코딩을 싸게 처리하는 용도로 쓰인다
7월 기준 근거는 Inkling-Small의 도구 사용 HLE 47.8%, 출력 100만 토큰당 1.20달러, SimpleQA Verified 20.6%입니다.
원본 가중치는 531.9GB라 어렵습니다. 공개 당일 허깅페이스의 페드로 쿠엔카가 NVFP4판(약 150GB)을 맥 스튜디오 한 대에서 돌렸고, Unsloth는 3비트판이 램 128GB 장비에서 돌아간다고 안내했습니다.
학생 모델이 직접 만든 답을 선생 모델이 토큰마다 채점해 가르치는 방식입니다. Inkling-Small은 Inkling을 선생으로 이 방식을 거친 뒤 에이전트 코딩 강화학습을 2주 더 했습니다.
파라미터 하나에 담을 수 있는 사실 지식이 약 2비트라는 연구가 있고, Inkling-Small의 전체 파라미터는 Inkling의 28%입니다. 같은 체급 오픈웨이트의 SimpleQA Verified 점수는 13.5~34.1%라 20.6%는 그 가운데쯤입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
Poolside가 7월 21일 공개한 Laguna S 2.1은 DeepSWE에서 40.4%를 받아 13배 큰 딥시크 V4-Pro-Max(9.0%)를 크게 앞섰습니다. DGX Spark 한 대에서 추측 디코딩 없이 초당 13~14토큰, 붙이면 최대 24토큰이 나옵니다.
씽킹머신즈가 7월 15일 첫 모델 Inkling의 가중치를 Apache 2.0으로 풀었습니다. 아티피셜애널리시스 지수 41점으로 미국 오픈웨이트 1위에 올랐지만, 오픈웨이트 전체로는 중국 모델 5개에 이은 6위입니다.
메타가 8월 10일 30B 오픈웨이트 모델 Muse Glimmer를 Apache 2.0으로 공개했습니다. 도구 호출 평가 MCP Atlas에서 75.5점으로 Gemma 4 31B와 Qwen 3.6 27B를 앞섰고, 화면 조작 평가 OSWorld에서는 65.9점으로 Qwen에 뒤졌습니다.
Poolside가 7월 21일 공개한 Laguna S 2.1은 DeepSWE에서 40.4%를 받아 13배 큰 딥시크 V4-Pro-Max(9.0%)를 크게 앞섰습니다. DGX Spark 한 대에서 추측 디코딩 없이 초당 13~14토큰, 붙이면 최대 24토큰이 나옵니다.
씽킹머신즈가 7월 15일 첫 모델 Inkling의 가중치를 Apache 2.0으로 풀었습니다. 아티피셜애널리시스 지수 41점으로 미국 오픈웨이트 1위에 올랐지만, 오픈웨이트 전체로는 중국 모델 5개에 이은 6위입니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@thinkymachinesX 게시물 · 원문 보기
씽킹머신즈는 발표문에서 Inkling과 비슷한 성능을 4분의 1 크기로 냈다고 적었습니다. 첫 모델 Inkling처럼 소리와 이미지를 별도 인코더 없이 글과 한 흐름으로 읽고, 컨텍스트는 최대 100만 토큰이며, 생각하는 양을 minimal부터 xhigh까지 고를 수 있습니다. 가중치는 허깅페이스에 원본(BF16)과 엔비디아의 4비트 형식(NVFP4) 두 가지로 올라갔고, 회사의 파인튜닝 서비스 Tinker와 대화용 Playground에는 한시 할인가로 들어갔습니다.
MoE는 전문가라고 부르는 작은 신경망을 여럿 두고 토큰마다 그중 일부만 켜는 구조입니다. 모델 카드에 따르면 Inkling-Small은 디코더 레이어 42개에 레이어마다 전문가 256개를 두고, 토큰마다 6개를 골라 쓰며 모든 토큰이 거치는 공용 전문가 2개를 더합니다. 토큰 하나를 만들 때 계산하는 양은 12B 모델 수준이고, 선생 Inkling의 41B와 비교하면 29%입니다.
계산이 가벼워도 파일은 가볍지 않습니다. 전문가 256개가 모두 메모리에 올라가 있어야 해서, 허깅페이스의 원본 가중치는 33개 파일에 531.9GB입니다. 스몰이라는 이름은 개인용이라는 뜻보다 975B짜리 Inkling과 견준 크기에 가깝습니다.
그 파일을 어디까지 줄여 돌릴 수 있는지는 공개 당일 바로 나왔습니다. 허깅페이스의 페드로 쿠엔카는 NVFP4 가중치를 맥 스튜디오 한 대에서 MLX로 돌리는 영상을 올리며, 모델이 약 150GB를 차지하니 128GB 노트북 두 대에 나눠 돌릴 수도 있다고 적었습니다. AI 인프라 회사 Modal은 NVFP4 가중치가 엔비디아 B300 한 장에 들어간다고 밝혔습니다.
@pcuenqX 게시물 · 원문 보기
로컬 실행 도구를 만드는 Unsloth는 같은 날 1비트부터 8비트까지 양자화 파일 20여 종을 허깅페이스에 올렸습니다. 양자화는 가중치를 낮은 정밀도로 바꿔 용량을 줄이는 작업으로, 많이 줄일수록 품질도 조금씩 깎입니다. 가장 작은 1비트 파일(IQ1_S)이 74.8GB, 품질 손실이 적은 4비트 파일(Q4_K_XL)이 163.3GB였고, Unsloth는 3비트 판이 램 128GB 장비에서 돌아간다고 안내했습니다.
발표문은 Inkling-Small이 Inkling보다 늦게 학습을 시작한 덕에 사전학습 데이터 배합과 학습 방법을 고칠 수 있었다고 적었습니다. 그다음 앞선 체크포인트(프리뷰)를 후속학습할 때 일부에 온폴리시 증류를 썼습니다. 선생은 Inkling이었고, 그 체크포인트에서 에이전트 코딩 강화학습을 2주 더 이어 간 것이 공개판입니다.
온폴리시 증류는 씽킹머신즈가 2025년 10월 연구 블로그에 따로 풀어 쓴 방법입니다. 그 글은 체스에 빗댔습니다. 강화학습은 코치 없이 대국을 두고 이겼는지 졌는지만 듣는 방식이라, 어느 수가 승패를 갈랐는지 알 수 없습니다. 선생의 풀이를 그대로 따라 배우는 기존 증류는 고수의 대국을 구경하는 방식인데, 초보자가 실제로는 거의 마주치지 않는 판에서 둔 수를 배우게 됩니다. 온폴리시 증류는 학생이 직접 둔 수를 선생이 하나하나 「악수」부터 「묘수」까지 매겨 주는 방식입니다.

이 발표 8일 전 워싱턴에서는 증류가 제재 논의로까지 번졌습니다. 마이클 크라치오스 백악관 과학기술정책실장은 7월 22일 문샷AI가 Kimi K3를 만들며 앤트로픽 Fable을 증류했다고 지목했고, 같은 날 스콧 베센트 재무장관은 제재와 엔티티 리스트 지정을 검토하겠다고 썼습니다. 크라치오스는 같은 글에서 정당한 증류와 은밀한 산업적 증류를 나눴습니다.
더 작고 효율적인 모델을 만드는 데 쓰는 정당한 AI 증류는 이 개방형 혁신 생태계에서 꼭 필요한 역할을 합니다.— 마이클 크라치오스, 백악관 과학기술정책실장
Inkling-Small은 그 문장이 가리키는 쪽의 사례입니다. 선생과 학생이 모두 씽킹머신즈가 처음부터 학습한 모델이고, 회사는 증류에 쓴 선생의 이름과 증류를 거친 체크포인트를 발표문에 적었습니다.
프리뷰의 성적표는 7월 15일 Inkling 발표문에 먼저 실렸습니다. 프리뷰에서 공개판까지 더해진 것은 2주의 에이전트 코딩 강화학습이고, 그 효과는 두 발표문의 숫자를 나란히 두면 보입니다. 두 표 모두 노력 수준(effort) 0.99로 잰 값입니다.
| 평가 | 프리뷰 (7월 15일 발표) | 공개판 (7월 30일) | Inkling |
|---|---|---|---|
| HLE (텍스트) | 29.6% | 31.6% | 29.7% |
| SWE-bench Verified | 77.4% | 80.2% | 77.6% |
| Terminal-Bench 2.1 | 52.7% | 64.7% | 63.8% |
| IFBench | 83.4% | 82.2% | 79.8% |
| SimpleQA Verified | 20.9% | 20.6% | 43.9% |
| FORTRESS 적대적 요청 거부 | 75.6% | 71.6% | 78.0% |
터미널에서 실제 작업을 끝내는 Terminal-Bench 2.1은 52.7%에서 64.7%로 12.0%포인트 올라 선생을 넘었고, 실제 깃허브 버그를 고치는 SWE-bench Verified도 80%를 넘었습니다. 짧은 사실을 묻는 SimpleQA Verified는 20.9%에서 20.6%로 거의 그대로였고, 해로운 요청을 거부하는 비율은 75.6%에서 71.6%로 내려갔습니다. 발표문은 인류의 마지막 시험(HLE)에서 생각하는 양을 어떻게 정해도 Inkling-Small의 곡선이 Inkling보다 위에 있었다고 덧붙였습니다.
코딩 점수에는 측정 조건이 붙어 있습니다. SWE-bench Verified는 bash 명령만 쓰는 하네스(모델에 도구와 지시를 붙여 일을 시키는 실행 틀)로, Terminal-Bench 2.1은 사내 하네스로 쟀고, 웹 검색으로 정답이 새어 들어간 풀이 몇 개는 0점으로 처리했습니다. 비교한 다른 회사 모델의 코딩 점수는 각 회사가 스스로 발표한 값입니다.
독립 평가 기관 아티피셜애널리시스는 공개 당일 Inkling-Small에 지능 지수 40점을 매겼습니다. 전체와 활성 파라미터가 모두 3분의 1이 안 되는데 41점인 Inkling과 1점 차이라는 평이었고, 같은 40점에는 딥시크 V4 Flash(max)와 GPT-5.4 mini(xhigh)가 있었습니다. 엔비디아 Nemotron 3 Ultra는 38점이었습니다.
@ArtificialAnlysX 게시물 · 원문 보기
씽킹머신즈가 낸 전체 표를 보면 앞선 항목과 뒤진 항목이 섞여 있습니다. 비슷한 체급의 딥시크 V4 Flash(전체 284B, 활성 13B)를 함께 놓으면 아래와 같습니다.
| 평가 | Inkling-Small (276B/12B) | Inkling (975B/41B) | 딥시크 V4 Flash (284B/13B) |
|---|---|---|---|
| AA 지능 지수 v4.1 | 40 | 41 | 40 |
| GPQA Diamond | 89.5% | 87.2% | 89.4% |
| HLE (텍스트) | 31.6% | 29.7% | 32.1% |
| SWE-bench Verified | 80.2% | 77.6% | 79.0% |
| GDPval-AA v2 | 1,269 | 1,238 | 1,189 |
| τ³-Banking | 15.5% | 23.7% | 22.9% |
| SimpleQA Verified | 20.6% | 43.9% | 34.1% |
| Global-MMLU-Lite | 86.7% | 88.7% | 88.4% |
실제 직무 과제로 모델끼리 겨루는 GDPval-AA v2는 제자가 앞섰지만, 은행 고객 응대 상황에서 도구를 써 요청을 처리하는 τ³-Banking은 23.7%에서 15.5%로 떨어졌습니다. 발표문도 지식 범위와 사실성에서는 Inkling이 앞선다고 직접 적었고, 회사가 쓴 표현은 앞섰다보다 비슷하다에 가까웠습니다.
SimpleQA Verified는 답이 하나로 정해진 짧은 사실 질문으로 이뤄진 시험입니다. 여기서 Inkling-Small은 20.6%로 선생의 43.9%에 절반이 안 됐습니다. 추론과 코딩 시험에서 선생을 넘은 모델이 외워서 답하는 시험에서는 23.3%포인트 뒤졌습니다.
모델이 담을 수 있는 사실의 양이 파라미터 수에 묶인다는 연구가 있습니다. 연구자 쩌위안 앨런주와 위안즈 리는 2024년 논문에서 통제된 실험을 거쳐 언어 모델이 파라미터 하나에 사실 지식을 약 2비트까지 저장한다고 보고했고, 같은 논문에서 이 용량이 학습 데이터의 질에 따라 달라진다고 적었습니다. Inkling-Small의 전체 파라미터는 Inkling의 28%입니다.
다만 같은 체급끼리 비교하면 그림이 달라집니다. 씽킹머신즈 표에서 전체 284B인 딥시크 V4 Flash는 34.1%, 397B인 Qwen3.5는 26.0%, 310B인 MiMo V2.5는 16.1%, 230B인 MiniMax M2.7은 13.5%였습니다. Inkling-Small의 20.6%는 200B~400B대 오픈웨이트 가운데 중간쯤이고, 크게 벌어진 상대는 975B짜리 선생입니다.
모르는 것을 모른다고 답하는지도 따로 잴 수 있습니다. 아티피셜애널리시스의 AA-Omniscience에서 Inkling-Small의 정답률은 31%로 Inkling의 40%보다 낮았지만, 맞히지 못한 문항에서 지어낸 답 대신 모른다고 답한 비율(비환각률)은 43%로 Inkling의 37%보다 높았습니다. 씽킹머신즈는 Inkling을 학습할 때 맞힐 가능성이 높을 때만 답해야 점수가 나오도록 보상을 짰고, Inkling-Small도 같은 방식으로 학습했다고 밝혔습니다. 이 시험의 종합 지수는 맞힌 답에 점수를 주고 틀린 답에서 점수를 빼며 모른다는 답은 0점으로 치는데, 정답률이 40%에서 31%로 줄면서 2.1에서 -9.0으로 내려갔습니다.
씽킹머신즈가 내놓은 보완책은 도구입니다. 도구를 붙인 HLE에서 Inkling-Small은 47.8%로 Inkling의 46.0%보다 높았고, 웹을 뒤져 답을 찾는 BrowseComp는 77.4%로 Inkling의 77.1%와 비슷했습니다. 이미지 쪽에서는 파이썬으로 그림을 자르고 확대해 문서와 차트를 읽는 능력을 키웠다고 밝혔습니다.
멀티모달 점수는 크기를 줄여도 대부분 지켰습니다. 오디오 이해를 재는 MMAU는 77.0%로 Inkling의 77.2%와 0.2%포인트 차이였고, 음성 지시를 따르는 VoiceBench는 90.1%로 1.3%포인트 낮았습니다. 오디오 객관식 시험 Audio MC는 54.9%로 Inkling의 56.6%보다 낮았지만 프리뷰의 49.6%보다는 올랐고, 이미지 추론 시험 MMMU Pro는 74.0%로 Inkling의 73.5%보다 조금 높았습니다.
공개 당일 허깅페이스의 머브 노얀은 Inkling-Small에 음성 합성 모델을 붙인 실시간 대화 시스템을 시험해, RTX Pro 6000 8장(시간당 22달러)으로 한 사용자에게 초당 160토큰을 냈고 동시 사용자 5명까지 실시간이 가능하다고 적었습니다. 씽킹머신즈가 Inkling을 설계하며 목표로 둔 쓰임도 사람이 말하고 화면을 보여 주며 실시간으로 협업하는 인터랙션 모델의 뒤에서 생각을 맡는 일이었습니다.
미래 사건의 확률을 맞히는 ForecastBench에서 Inkling-Small은 검색 없이 61.3점(±0.46)을 받았고, 발표문은 Inkling(60.1점, ±0.54)과 같은 수준이라고 적었습니다. 이 표는 7월 19일부터 28일 사이에 잰 값입니다. 7월 15일 Inkling 발표문에는 공개판과 다른 체크포인트로 잰 Inkling 점수 61.1점이 실려 있어, 두 표의 Inkling 점수는 1점 차이가 납니다.
안전 평가에서는 거부율이 내려갔습니다. 범죄와 폭력, 이중 용도 위험에 걸친 FORTRESS에서 해로운 요청을 거부한 비율은 71.6%로 Inkling의 78.0%보다 6.4%포인트 낮았고, 겉보기만 비슷한 무해한 요청에 답한 비율은 96.9%로 1.0%포인트 높았습니다. 명백히 해로운 요청의 거부를 재는 StrongREJECT는 98.4%로 Inkling의 98.6%와 비슷했습니다.
| 안전 평가 | Inkling-Small | Inkling | 딥시크 V4 Flash | MiniMax M2.7 |
|---|---|---|---|---|
| FORTRESS 적대적 요청 거부 | 71.6% | 78.0% | 32.0% | 86.3% |
| FORTRESS 무해한 요청 응답 | 96.9% | 95.9% | 99.2% | 90.1% |
| StrongREJECT | 98.4% | 98.6% | 97.4% | 99.4% |
씽킹머신즈는 Inkling과 같은 안전 후속학습 방식과 외부 레드팀을 포함한 배포 전 시험을 거쳤고, 기존 오픈웨이트 생태계보다 위험을 크게 키우는 수준은 아니라고 결론 내렸습니다. 모델 카드는 역할극이나 돌려 말한 요청에 가끔 응하는 경향을 남은 위험으로 적고, 모델의 거부에만 기대지 말고 Llama Guard 같은 입출력 분류기를 겹쳐 두라고 권했습니다. 프리뷰의 75.6%가 공개판에서 71.6%가 된 이유는 발표문에 나와 있지 않습니다.
발표문의 비용 도표는 출력 100만 토큰당 Inkling을 4.05달러, Inkling-Small을 1.20달러로 놓고 그렸습니다. 3.4배 차이로, 활성 파라미터 비율(41B 대 12B)과 거의 같습니다. 생각하는 양을 minimal부터 xhigh까지 바꿔 가며 그린 곡선에서 Inkling-Small은 세 평가 모두 Inkling보다 싼 쪽에 있습니다.
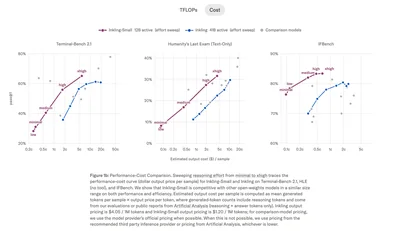
토큰도 덜 썼습니다. GDPval-AA v2에서 Inkling-Small은 과제당 출력 토큰 2만 3,000개로 1,269점을, Inkling은 2만 8,600개로 1,238점을 받았습니다. 공개 당일 LMSYS는 NVFP4 가중치를 B200 8장 서버에 올려 한 사용자 기준 초당 288토큰을 냈고, 추측 디코딩을 가정한 시뮬레이션에서는 초당 648토큰이 나왔다고 밝혔습니다.
가중치의 Apache 2.0은 상업적 이용과 수정, 재배포를 허락합니다. 모델 카드가 연결한 씽킹머신즈의 모델 이용 정책에는 금융과 법률, 고용, 의료, 주거, 보험처럼 개인의 권리에 영향을 주는 결정을 사람 없이 자동으로 내리는 일을 금지하는 조항과, AI와 대화한다는 사실을 사용자에게 알리라는 조항이 들어 있습니다. 회사가 정책을 고칠 수 있고 고친 뒤에도 계속 쓰면 동의한 것으로 본다는 문장도 있습니다.
같은 체급의 국산 모델도 8일 앞서 나왔습니다. 업스테이지가 7월 22일 공개한 Solar Open 2는 전체 250B에 토큰마다 15B를 쓰고, 모델 카드가 밝힌 최소 사양은 H200 4장입니다. 라이선스는 Apache 2.0을 바탕으로 한 업스테이지 솔라 라이선스로, 이 모델로 파인튜닝하거나 증류해 만든 모델을 배포하려면 이름을 Solar로 시작하고 「Built with Solar」를 표시한다는 조건이 붙습니다. Inkling-Small로 만든 파생 모델에는 이런 이름 조건이 없습니다.
한국어 성능은 따로 공개되지 않았습니다. 모델 카드는 지원 언어를 영어와 그 밖의 언어에 대한 일반적인 다국어 능력으로 적었고, 한국어 문항이 들어 있는 다국어 상식 시험 Global-MMLU-Lite는 86.7%로 Inkling의 88.7%보다 2.0%포인트 낮았지만 언어별 점수는 내놓지 않았습니다. 인터넷이 막힌 사내망처럼 검색을 붙이기 어려운 환경에서는 SimpleQA 20.6%가 그대로 드러납니다.
저는 이 체급의 오픈웨이트가 사실 지식은 검색에 맡기고 추론과 코딩을 싸게 처리하는 쪽으로 쓰일 것으로 봅니다. 도구를 붙인 HLE 47.8%와 출력 1.20달러가 그 근거입니다. 씽킹머신즈는 7월 15일 Inkling을 모델 가족의 첫 번째라고 소개했고, 두 번째 모델은 15일 뒤에 나왔습니다.
읽어 주셔서 고맙습니다.
초이 드림