이 글 어땠어요?
에이전트는 모델이 추론하면 CPU가 도구 호출과 코드 실행을 처리하고, 그 결과를 받아 다시 추론하는 과정을 차례로 반복합니다. 조지아공대와 인텔 연구진의 측정에서는 CPU에서 도는 도구 처리가 작업에 따라 전체 지연의 43.8~90.6%를 차지했습니다.
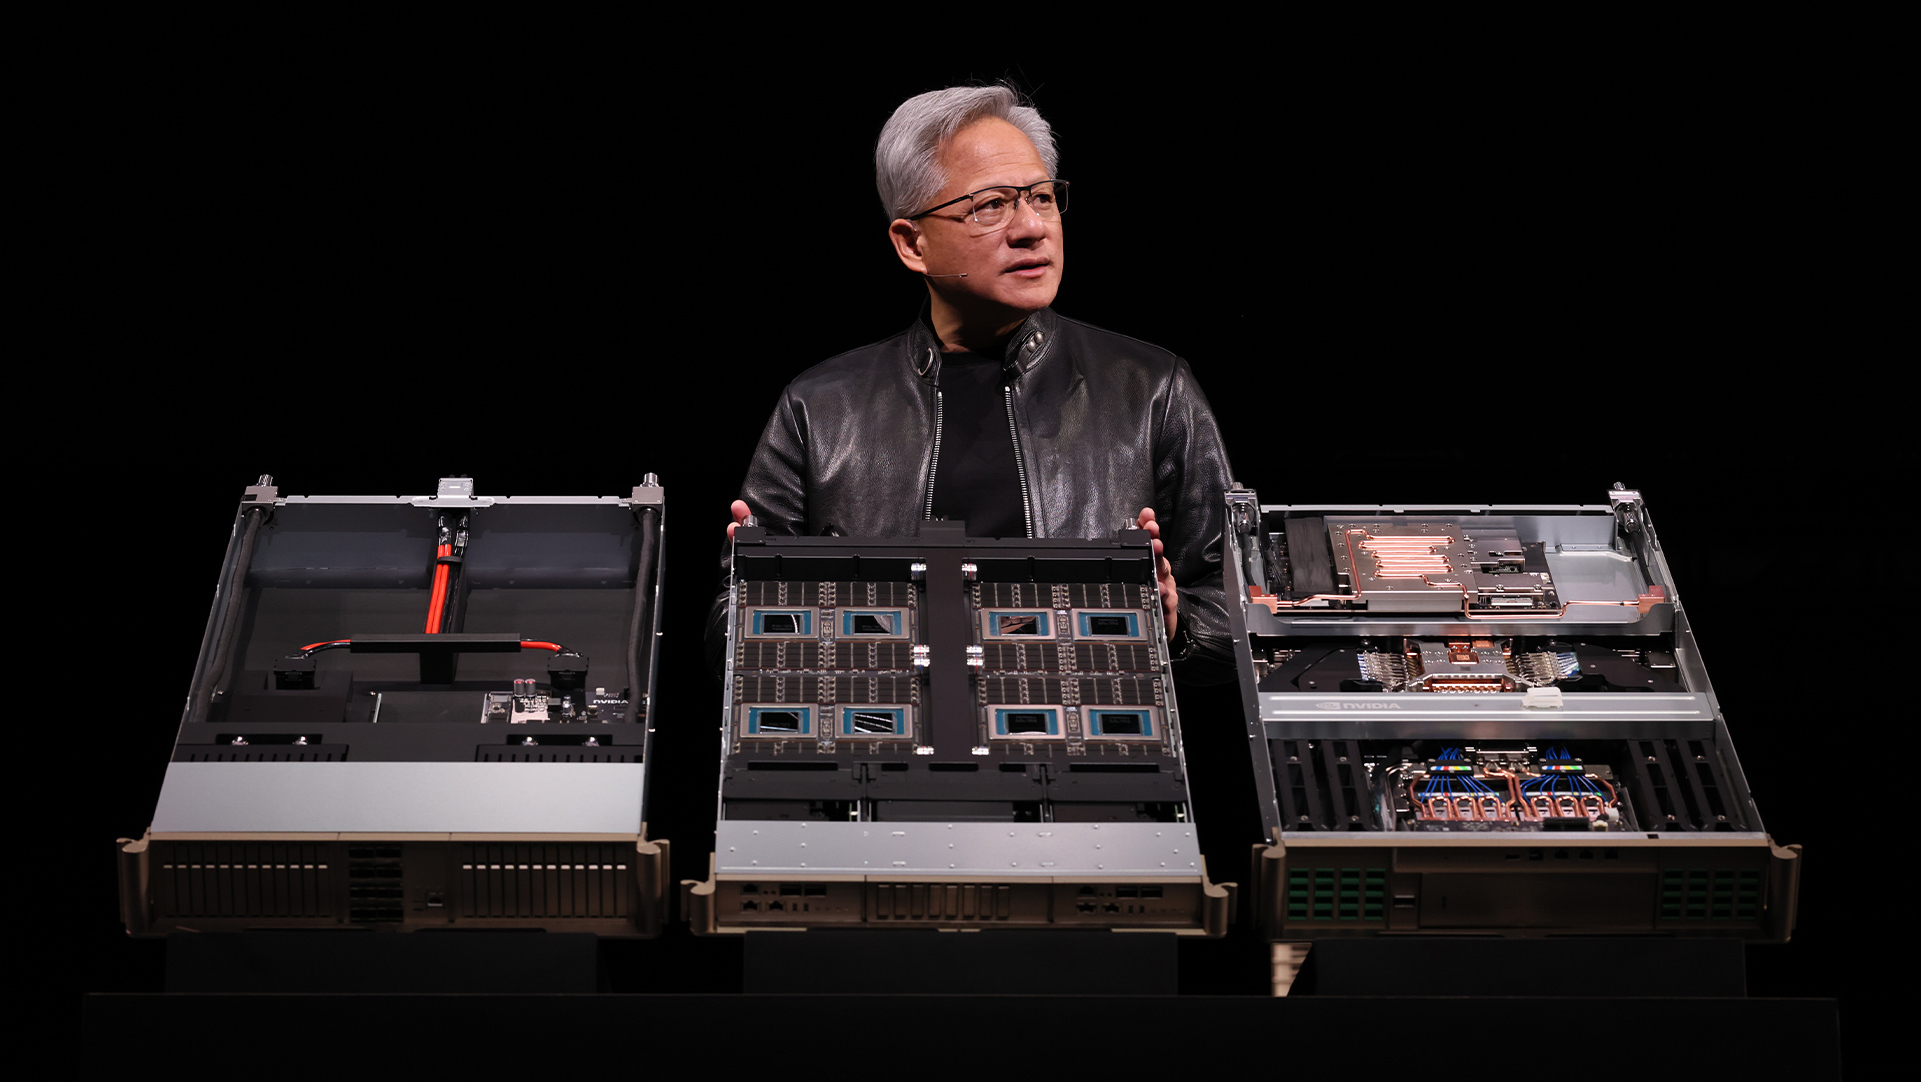
엔비디아가 직접 설계한 Olympus 코어 88개가 칩렛 없이 한 장의 다이에 들어가고, 클럭당 명령어 처리가 앞 세대 Grace보다 50% 많습니다. 메모리 대역폭은 최대 1.2TB/s이고 공간 멀티스레딩으로 스레드 176개를 돌립니다.
1.8배는 엔비디아가, 1.5배는 퍼플렉시티가 낸 값이고 비교한 x86 칩의 이름과 측정 조건은 공개되지 않았습니다. 같은 조건에서 제3자가 잰 결과는 아직 없습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
마이크로소프트가 10월 7일(미국 시각) 윈도 행사에서 에이전트 격리 장치 MXC를 정식 출시하고 메타 Muse의 윈도 앱을 예고했습니다. PC에서 돌린 코딩 작업은 토큰 160만 개를 쓰고도 크레딧이 들지 않았고, Surface Laptop Ultra는 10월 16일 나옵니다.
리플렉션 AI가 10월 5일(미국 시각) 첫 모델 Beam을 공개했습니다. GLM-5.2급 추론 점수를 3~4배 적은 연산으로 냈다고 밝혔지만, 자사 비교표에서도 GLM-5.3과 DeepSeek V4.1-Flash가 더 높습니다.
미국 법무부가 10월 1일 엔비디아 GPU 서버 3억 달러어치 넘게를 말레이시아·싱가포르를 거쳐 중국으로 보낸 혐의로 어스메이드 컴퓨터 대표를 체포했습니다. 엔비디아는 검찰이 주장하는 전용 비율이 0.5%도 안 된다고 반박했습니다.
마이크로소프트가 10월 7일(미국 시각) 윈도 행사에서 에이전트 격리 장치 MXC를 정식 출시하고 메타 Muse의 윈도 앱을 예고했습니다. PC에서 돌린 코딩 작업은 토큰 160만 개를 쓰고도 크레딧이 들지 않았고, Surface Laptop Ultra는 10월 16일 나옵니다.

리플렉션 AI가 10월 5일(미국 시각) 첫 모델 Beam을 공개했습니다. GLM-5.2급 추론 점수를 3~4배 적은 연산으로 냈다고 밝혔지만, 자사 비교표에서도 GLM-5.3과 DeepSeek V4.1-Flash가 더 높습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@nvidiaX 게시물 · 원문 보기
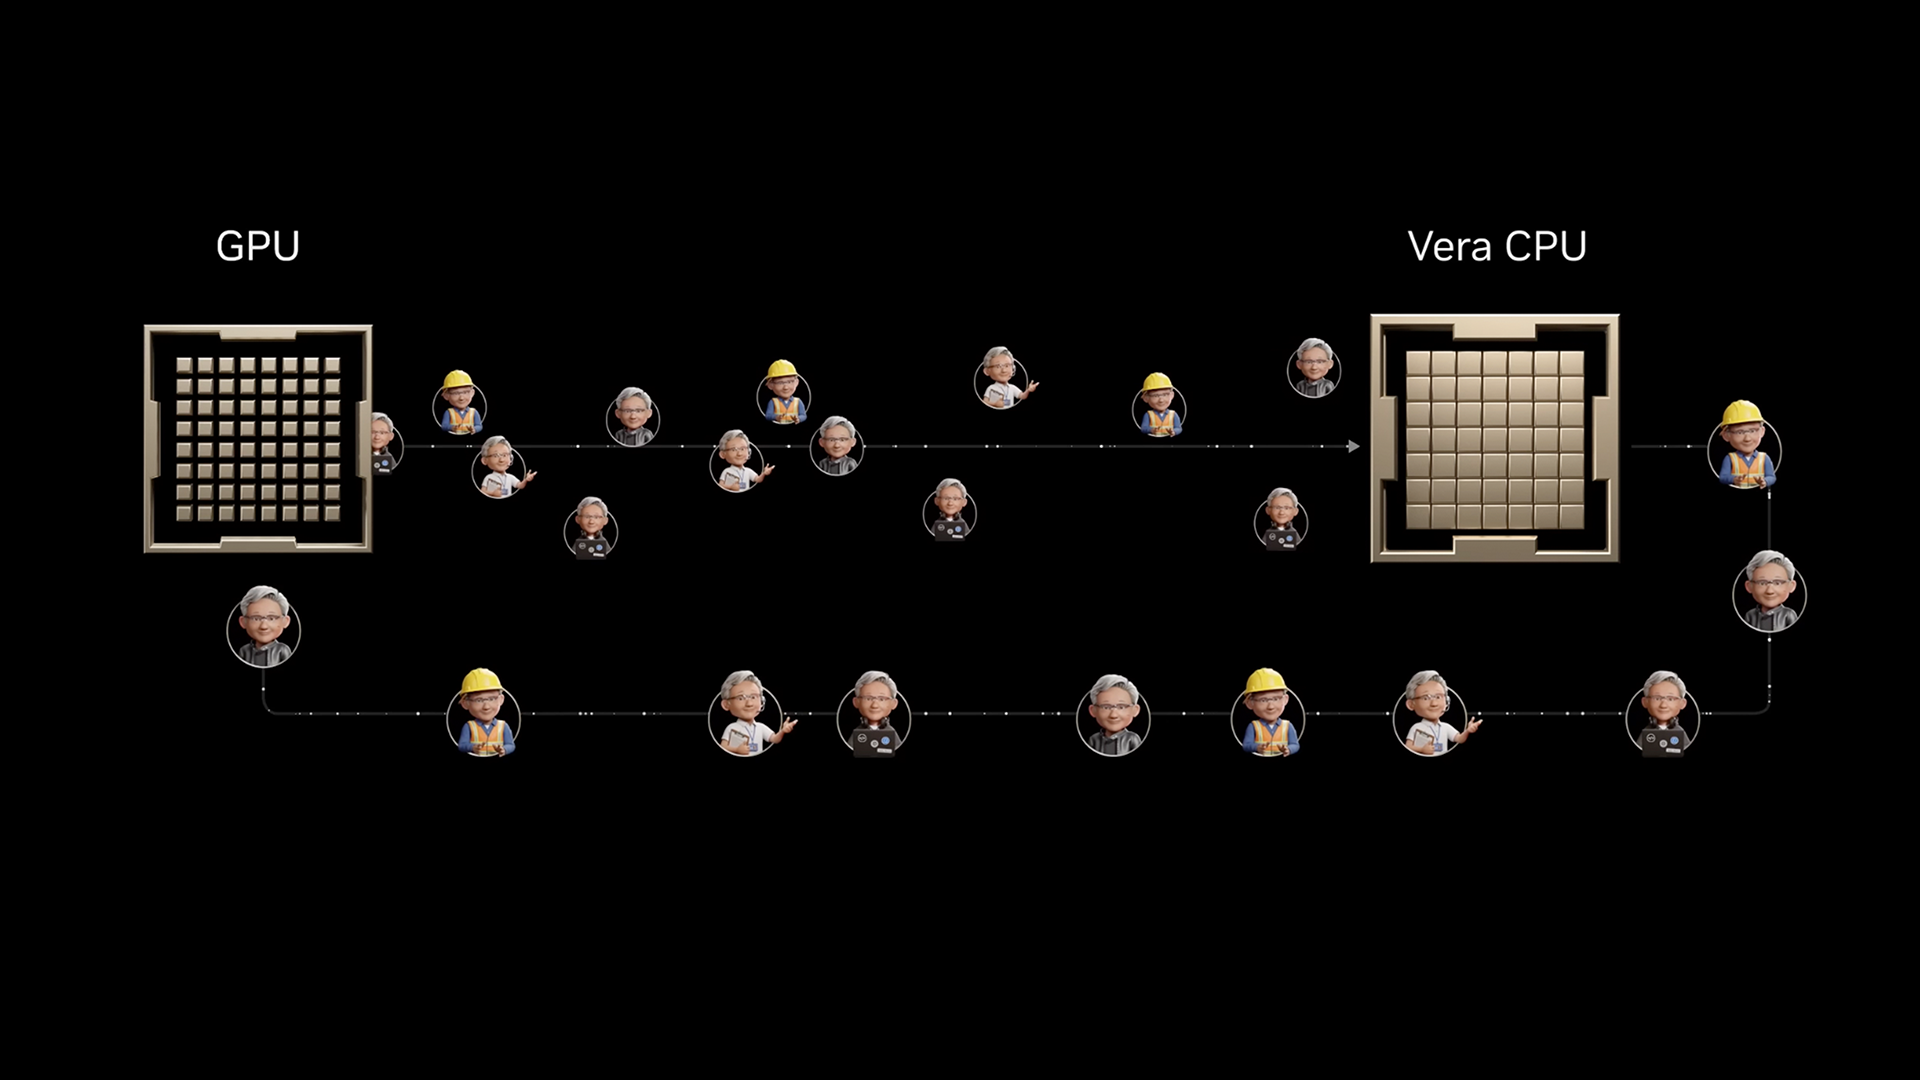
엔비디아 공식 계정은 같은 날 에이전트 시스템이 차례로 돈다고 적었습니다. 추론 단계와 도구 호출, 코드 실행이 CPU 위에서 하나씩 일어나기 때문에, CPU가 부하에 느려지면 에이전트 루프 전체가 느려지고 값비싼 GPU가 논다는 설명입니다. 게시물 끝에는 퍼플렉시티가 이미 Vera 위에서 서비스를 만들고 있다는 문장이 붙었습니다. 블로그를 쓴 이언 벅은 AI 팩토리에서 가장 값진 자원이 GPU 가동률이고, CPU 작업이 끝나기를 기다리는 시간은 그대로 AI 팩토리의 매출을 깎는다고 적었습니다.
에이전트는 요청 하나에 답하고 끝나지 않습니다. 모델이 다음 단계를 추론하면 CPU가 그 주변의 일을 처리하고, 결과가 돌아오면 모델이 다시 다음 할 일을 정하는 순환을 되풀이합니다. 엔비디아는 이때 CPU가 맡는 일로 도구 호출, 코드 실행, 데이터 처리, KV 캐시(모델이 앞서 읽은 문맥을 저장해 둔 값) 관리, 결과 분석을 꼽았습니다.
예전의 CPU 작업은 사람이 누를 때마다 짧게 일하고 쉬는 간헐적인 일이었지만, 에이전트의 일은 쉬지 않고 동시에 돌아갑니다. 수많은 에이전트가 계속 돌면서, 각자 앞 단계의 결과에 기대는 단계를 하나씩 밟아 갑니다.
세상은 초 단위로 셉니다. 에이전트는 나노초 단위로 셉니다.— 이언 벅, 엔비디아
이 구간이 실제로 얼마나 긴지는 엔비디아 밖에서도 잰 적이 있습니다. 조지아공대와 인텔 연구진은 지난해 11월 arXiv에 낸 논문에서 에이전트 작업 다섯 가지를 인텔 에메랄드래피즈 48코어 CPU와 엔비디아 B200 GPU를 붙인 시스템에서 돌렸습니다. 모델 추론보다 CPU에서 도는 도구 처리가 지연의 대부분을 차지했고, 많게는 전체의 90.6%였습니다.
| 작업 | CPU에서 도는 도구 처리 | 전체 지연 가운데 비중 |
|---|---|---|
| Haystack RAG, 질의응답 세 종 | 문서 검색 6.0~8.0초(모델 추론은 0.5초 이하) | 84.5~90.6% |
| SWE-Agent, APPS | Bash·파이썬 코드 실행 | 64.7% |
| SWE-Agent, BigCodeBench | Bash·파이썬 코드 실행 | 78.7% |
| SWE-Agent, DS-1000 | Bash·파이썬 코드 실행 | 43.8% |
여러 에이전트를 한꺼번에 돌리면 사정이 더 나빠졌습니다. LangChain 작업을 동시에 128개 돌리자 코어보다 많은 작업이 몰려 요약 도구의 평균 지연이 64개일 때의 2.9초에서 6.3초로 늘었고, 문서 검색 작업은 32개를 넘기면서 캐시와 디스크를 두고 다툼이 생겨 처리량이 막혔습니다. 연구진은 처리량을 막는 CPU 쪽 요인으로 코어 사이의 데이터 일관성 유지, 동기화, 코어보다 많은 작업을 올리는 과부하를 꼽았습니다.
에너지도 CPU 쪽으로 기울었습니다. 별도 장비(AMD 스레드리퍼 64코어와 엔비디아 H200)에서 잰 결과, 동시 작업을 1개에서 128개로 늘리는 동안 GPU의 동적 에너지는 26.8배 늘었지만 CPU는 86.7배 늘었습니다. 전체 동적 에너지에서 CPU가 차지하는 비중은 20%에서 44%가 됐습니다.
클라우드 시대의 서버 CPU는 코어 수를 늘리는 쪽으로 발전했습니다. 빌려줄 수 있는 코어 하나당 원가를 낮추려고 칩 하나에 코어를 더 넣었고, 그만큼 코어를 빠르게 만드는 데 쓰던 실리콘 면적(고성능 메모리 연결, 명령어 처리 장치)이 줄었다는 것이 엔비디아의 설명입니다. 칩을 여러 조각으로 나눠 붙이는 칩렛 설계는 원가를 더 낮췄지만, 코어가 칩 전체의 메모리 성능을 다 쓰지 못하는 「칩렛 세금」을 낳았다고 했습니다.
코어가 많으면 CPU 하나가 동시에 맡는 에이전트 작업이 늘어납니다. 그런데 에이전트 한 루프 안의 각 단계는 앞 단계 결과를 기다려야 해서, 코어를 아무리 늘려도 한 걸음의 시간은 줄지 않습니다. 병렬로 나눌 수 없는 부분이 전체 속도의 한계를 정한다는 암달의 법칙이 그대로 나타나는 겁니다. 엔비디아는 코어 수를 최대로 늘린 CPU에서는 코어끼리 자원을 다투느라 코어 하나의 성능이 오히려 떨어질 수 있다고 적었습니다.
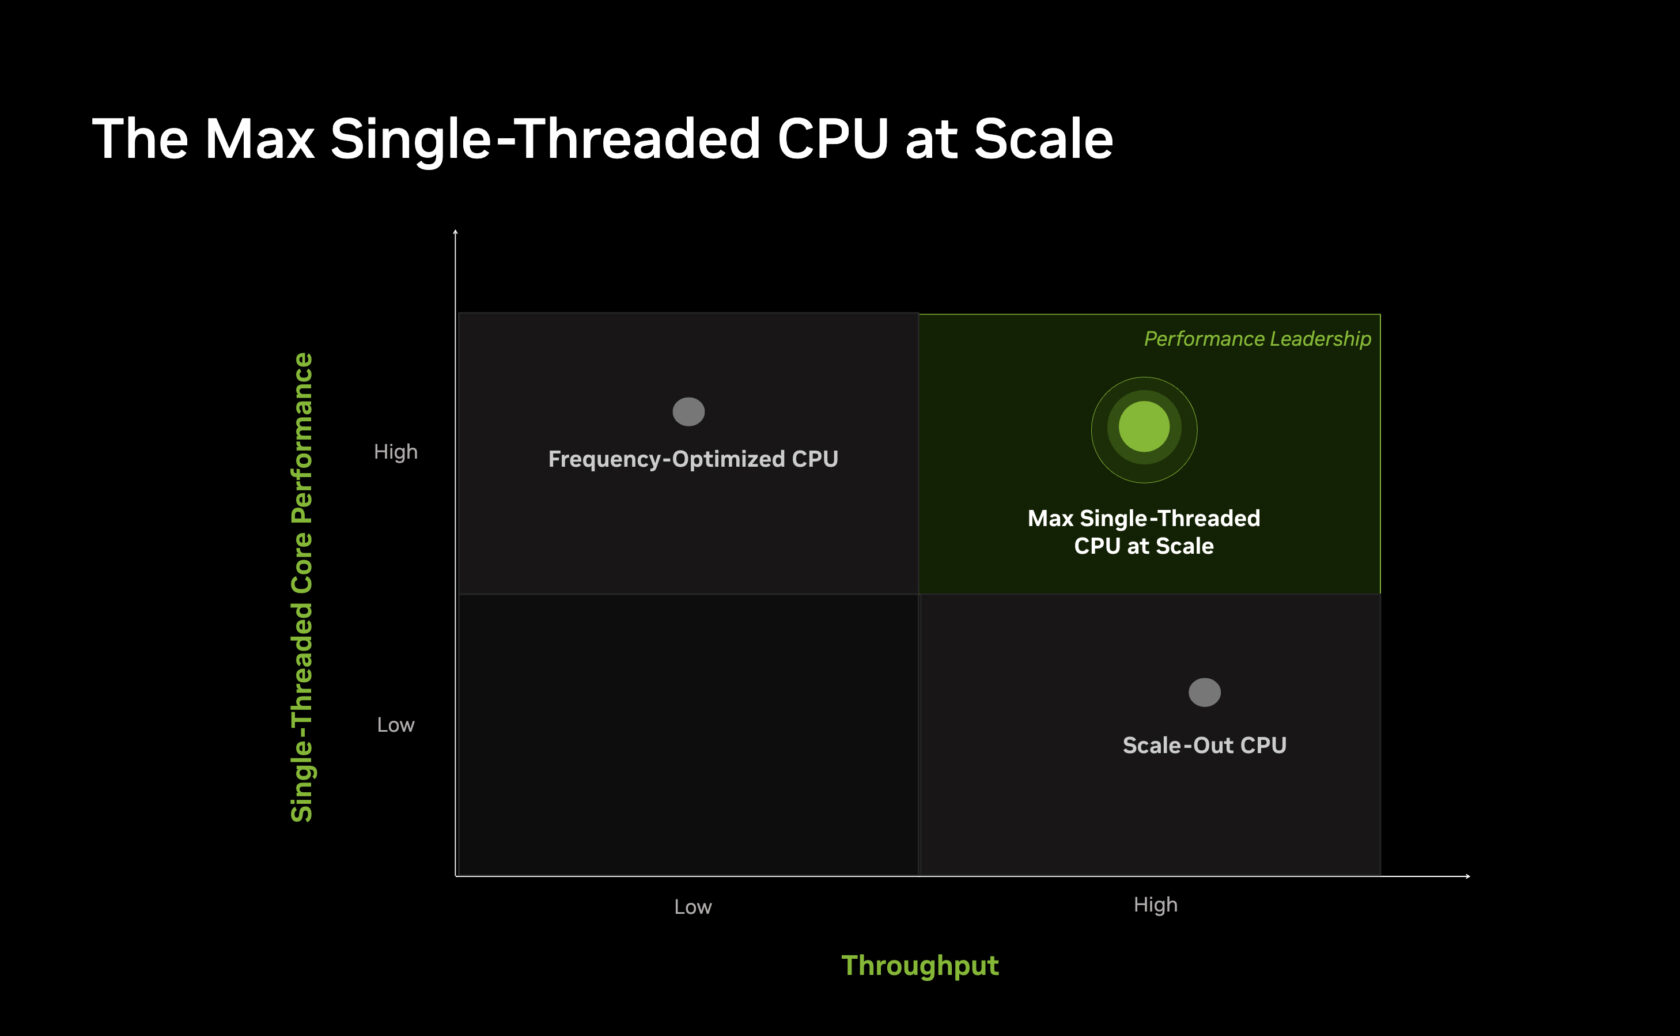
그래서 엔비디아가 내세운 조건은 셋입니다. 부하가 걸려도 유지되는 코어당 성능, 일하는 코어마다 데이터를 댈 만큼의 메모리 대역폭, 예측할 수 있는 지연 시간입니다. PC와 워크스테이션에는 이미 빠른 CPU가 있지만, 데이터센터 CPU는 코어 하나의 성능에서 멀어지는 쪽으로 발전해 왔다는 것이 엔비디아의 진단입니다.
| 항목 | Vera |
|---|---|
| 코어 | 엔비디아가 직접 설계한 Olympus 88개(앞 세대 Grace는 Arm Neoverse V2 72개) |
| 스레드 | 공간 멀티스레딩으로 176개 |
| 클럭당 명령어 처리 | Grace보다 50% 많음 |
| 메모리 | LPDDR5X 최대 1.5TB, 대역폭 최대 1.2TB/s(메모리 전력 40W 미만) |
| 코어 사이 연결 | 한 장의 다이, 코어 간 대역폭 3.4TB/s |
| GPU 연결 | NVLink-C2C 최대 1.8TB/s |
Vera의 88개 코어는 칩렛으로 나누지 않은 한 장의 다이에 들어갑니다. 엔비디아는 코어 간 대역폭 3.4TB/s가 다른 데이터센터 CPU의 3배이고, 그 덕에 88개 코어가 모두 CPU의 메모리 성능을 온전히 쓴다고 설명했습니다. 공간 멀티스레딩은 코어 하나를 스레드 두 개로 쓰되 코어 자원을 스레드마다 나눠 주는 방식으로, 엔비디아는 이를 대규모에서도 처리량을 예측할 수 있게 하는 설계로 소개합니다.
메모리는 스마트폰에 쓰이는 저전력 D램 LPDDR5X를 탈착식 모듈(SOCAMM)로 붙였습니다. 엔비디아는 기존 서버용 메모리보다 대역폭은 2배, 전력은 절반이라고 밝혔고, 이 메모리가 GPU와 나눠 쓰는 KV 캐시를 덜어 두는 데도 쓰인다고 적었습니다.
| 측정한 곳 | 작업 | 결과(x86 대비) |
|---|---|---|
| 엔비디아 | 에이전트 실행을 대표하는 부하 작업 | 코어당 지속 성능 1.8배 |
| 퍼플렉시티 | 저장소를 복제하고 샌드박스에서 테스트 실행 | 약 1.5배 빠름 |
| 퍼플렉시티 | 동시 샌드박스 시작 | 최대 1.9배 빠름 |
| 스타버스트 | 대규모 SQL 분석 | 3배 빠름 |
| 레드판다 | 실시간 스트리밍 | 지연 최대 6분의 1 |
1.8배의 비교 대상은 이름이 공개되지 않았습니다. 블로그는 x86이라고만 적었고, 제품 페이지의 성능 비교도 최신 세대 x86 CPU를 기준으로 삼았으며 측정값은 바뀔 수 있다고만 밝혔습니다. 어떤 부하로 에이전트 실행을 대표했는지도 공개하지 않았습니다.
퍼플렉시티의 수치는 실제 업무에서 나왔다는 점이 다릅니다. 저장소를 받아 테스트 스위트를 돌리는 일은 코딩 에이전트가 하루에도 수없이 반복하는 작업이고, 앞의 논문에서 SWE-Agent의 코드 실행이 지연의 43.8~78.7%를 차지한 구간과 같은 종류입니다. 다만 퍼플렉시티는 Vera를 다음 운영 시스템에 배치하는 방안을 검토하는 단계라고 엔비디아는 전했습니다. 표의 수치는 모두 공급사와 협력사가 낸 값이고, 같은 조건에서 제3자가 잰 결과는 아직 없습니다.
CPU가 병목이라면 칩을 바꾸기 전에 소프트웨어부터 손볼 수도 있습니다. 앞의 논문에서 LangChain 작업 128개를 파이썬 프로세스로 따로 띄워 코어에 나눠 주자 코어 하나로 차례로 돌릴 때보다 26.8배, 한 프로세스 안의 스레드로 돌릴 때보다 1.6배 빨랐습니다. 연구진은 새 하드웨어 없이 CPU와 GPU의 작업 배치를 조정하는 스케줄링 기법 두 가지도 내놓았고, 에이전트 작업의 중간값 지연을 최대 2.1배와 1.41배 줄였습니다.
논문의 숫자에는 조건도 붙어 있습니다. CPU에서 도는 도구 처리로 잡힌 시간에는 문서 검색, 울프럼알파 같은 외부 API 호출, 논문 검색과 내려받기처럼 네트워크를 기다리는 시간이 섞여 있습니다. 코어가 빨라져도 외부 서버의 응답은 빨라지지 않습니다. 코드를 실행하고 테스트를 돌리는 것처럼 계산이 많은 구간에서 코어당 성능의 효과가 가장 크고, 퍼플렉시티가 고른 테스트 실행도 계산이 많은 작업입니다.
Vera는 엔비디아의 다음 랙 시스템 Vera Rubin에서 GPU를 거느리는 호스트 CPU이고, 스토리지 처리 장치 BlueField-4 STX에도 들어갑니다. 엔비디아는 에이전트가 도구를 쓰고, 데이터를 처리하고, 요청을 받고, 강화학습으로 다음 모델을 훈련하는 일을 CPU 하나로 다 맡기면 AI 팩토리 전체가 한 가지 설계와 한 가지 개발 도구로 돌아간다고 강조했습니다.
@NVIDIAAIInfraX 게시물 · 원문 보기
발표 하루 전 엔비디아 AI 인프라 계정은 GTC 타이베이 행사를 정리하며, 에이전트용 CPU Vera를 앤트로픽과 코어위브, 오픈AI, 오라클이 이미 채택했다고 적었습니다. 엔비디아는 다음 세대 CPU Rosa와 그 코어 Rigel도 예고했습니다. Rigel은 Arm v9.2 기반으로, 같은 실리콘 면적에서 Olympus보다 코어당 성능을 높이고 L2 캐시를 키운다고 했습니다.
엔비디아가 GPU 옆의 CPU까지 자기 설계로 채우면, 랙 하나를 살 때 비교할 항목이 GPU 성능표에서 CPU와 메모리, 연결 방식까지 넓어집니다. 엔비디아는 에이전트가 수십억 개로 늘어나는 시장에서는 끝낸 에이전트 작업이 곧 상품이 된다고 적었고, 그 작업 시간의 상당 부분이 CPU에서 흐른다는 점을 이번 발표의 근거로 삼았습니다. 추론 수요가 커지며 엔비디아가 칩 밖으로 사업을 넓혀 온 과정은 아래 글에 정리했습니다.
Vera 한 개에는 LPDDR5X가 최대 1.5TB까지 붙습니다. LPDDR5X는 삼성전자와 SK하이닉스, 마이크론이 만드는 저전력 D램이라, GPU 옆의 HBM에 더해 CPU 옆에서도 AI 서버용 메모리 수요가 생깁니다. 추론 수요가 학습 수요를 넘어서며 메모리 회사가 가장 많은 이익을 내게 된 흐름은 메모리 회사의 실적과 주가를 다룬 글에서 다뤘습니다.
에이전트 서비스를 운영하는 국내 기업이 Vera 같은 CPU에서 얻을 효과는 자기 작업에서 CPU가 차지하는 시간이 정합니다. 논문에서 위 표로 옮긴 작업만 봐도 그 비중은 43.8%에서 90.6%까지 벌어졌고, 그 안에 섞인 네트워크 대기 시간은 코어를 바꿔서 줄일 수 있는 구간이 아닙니다. 퍼플렉시티가 운영 시스템에 Vera를 실제로 들이고 수치를 공개하는 때가 1.8배와 1.5배를 확인할 다음 기회입니다.
읽어 주셔서 고맙습니다.
초이 드림