
툴 호출
tool use · function calling · 도구 호출
모델이 검색·계산기·API 같은 외부 도구를 불러 쓰는 기능입니다. 에이전트가 실제 일을 하려면 꼭 필요합니다.
‘툴 호출’ 이 나오는 글8
게임처럼 '모드' 까는 Claude Code, 권한은 내 계정 그대로입니다
앤트로픽이 10월 2일 새벽 Claude Code 2.1.287에서 모드를 기본으로 켰습니다. 도구 호출을 붙잡거나 화면을 새로 그리는 함수가 샌드박스 없이 사용자 권한으로 실행되고, 10초를 넘긴 함수는 건너뜁니다.
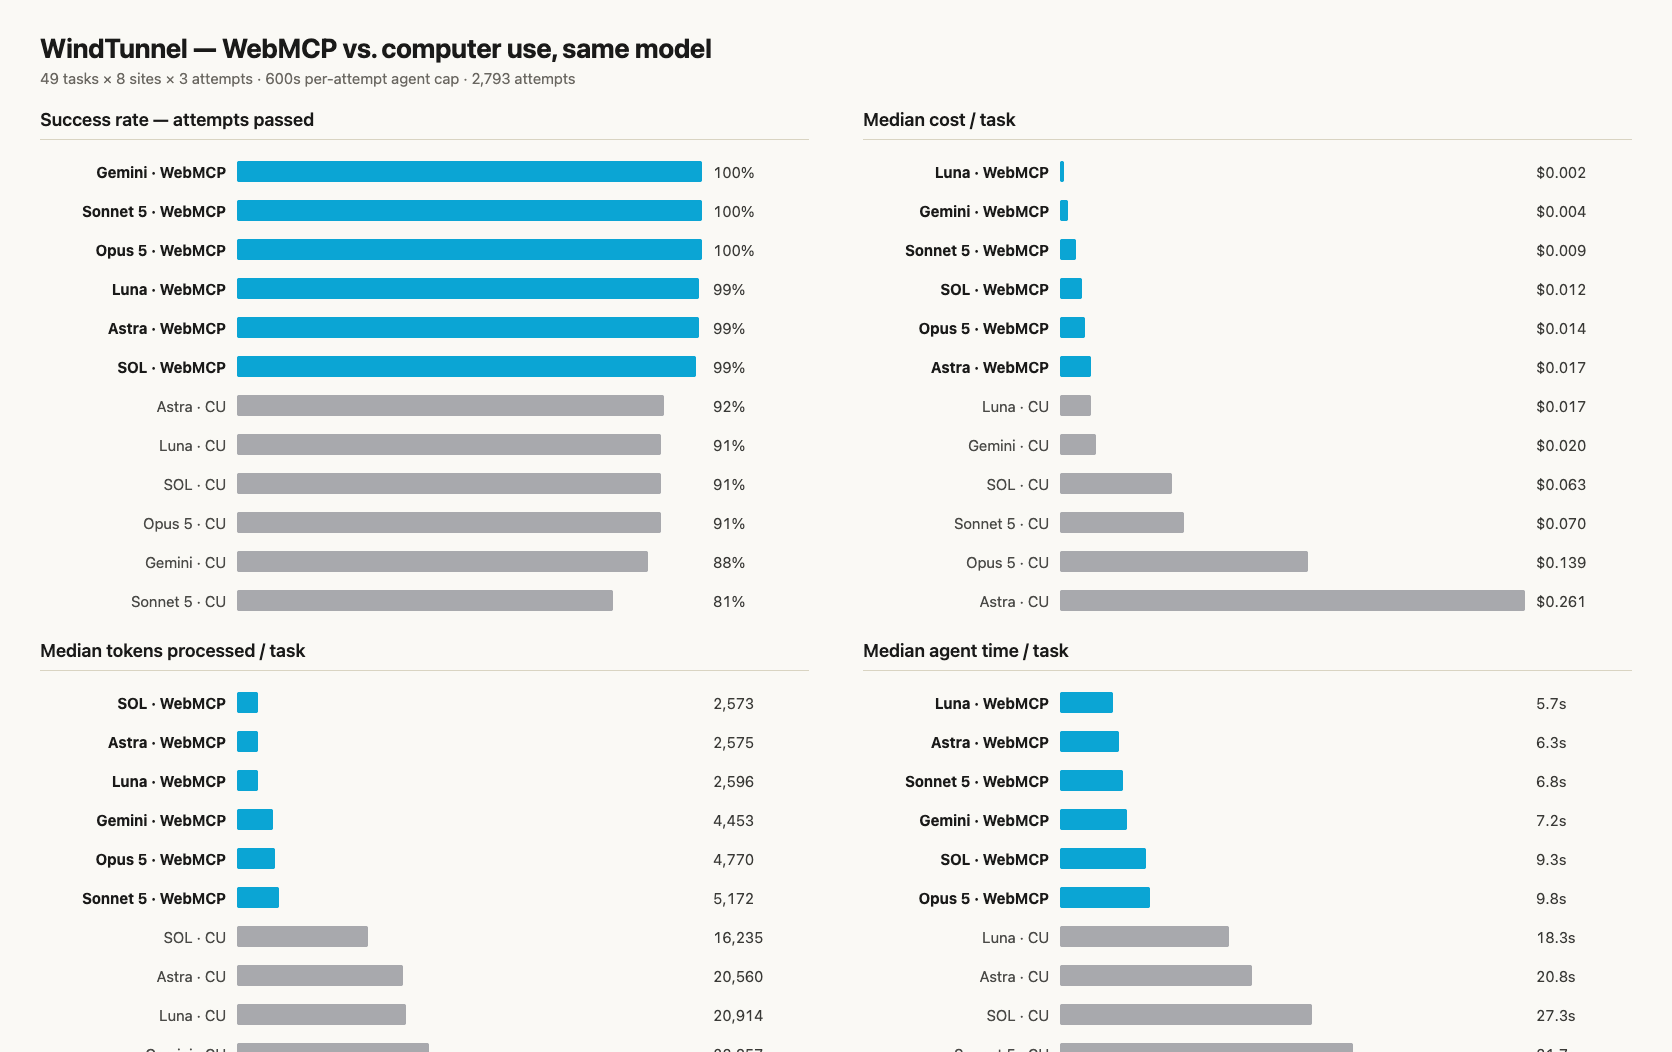
AI가 웹사이트를 쓰는 세 가지 방법, 가장 싼 길은 사이트가 열어야
9월 18일 공개된 윈드터널 새 판에서 Jev와 Mercury 2.5 조합이 WebMCP로 49개 작업을 모두 풀었습니다. 같은 모델끼리 비교하면 WebMCP가 컴퓨터 사용보다 7~15배 쌌고, 결제 도구를 추가하기 전까지는 WebMCP도 결제 과제를 모두 실패했습니다.
그래픽카드 한 장에 도는 30B, 메타가 16개월 만에 가중치를 풀었습니다
메타가 8월 10일 30B 오픈웨이트 모델 Muse Glimmer를 Apache 2.0으로 공개했습니다. 도구 호출 평가 MCP Atlas에서 75.5점으로 Gemma 4 31B와 Qwen 3.6 27B를 앞섰고, 화면 조작 평가 OSWorld에서는 65.9점으로 Qwen에 뒤졌습니다.
GPU보다 대기열이 먼저 찼다, 오픈AI GPT-Live 6개월 제작기
오픈AI가 8월 3일 GPT-Live 실시간 시스템을 6개월 동안 만든 과정을 공개했습니다. 미디어 경로와 추론 로직을 Python에서 Go로 다시 써 새 시스템의 p95 지연이 옛 시스템 p50 수준으로 내려왔고, 연결 준비 왕복은 6번에서 1번으로 줄었습니다.
가중치만으론 절반, 문샷AI가 Kimi K3에 커널·채점표까지 붙였습니다
문샷AI가 7월 27일 Kimi K3 가중치를 공개하며 FlashKDA·MoonEP·AgentENV를 함께 풀었고, 11분 뒤 서빙 업체 7곳의 검증 점수가 올라왔습니다. 지난해 K2는 vLLM에서 도구 호출 1,200여 건 중 218건만 제대로 처리될 만큼 흔들렸습니다.
코드 100만 줄을 AI가 쓴 팀, 매주 금요일은 'AI 슬롭' 청소였습니다
오픈AI 팀은 사람이 쓴 코드 없이 100만 줄짜리 제품을 만들면서도 좋은 코드의 기준만은 직접 정해 린터와 문서로 옮겼습니다. 구글 킬패트릭은 하네스가 12개월 안에 모델로 흡수된다고 봤고, 커서는 행동 기록으로 제안을 21% 줄이고 수락률을 28% 올렸습니다.
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 샌드박스모델이 도구를 쓰고 코드를 실행하도록 열어 주되 바깥 네트워크와 파일 시스템에서 끊어 놓은 격리 환경입니다. 프롬프트에 인터넷이 없다고 적어 두고 컨테이너는 인터넷에 붙어 있는 설정 불일치가 실제 침해 사고의 원인이 됐습니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.