앤트로픽이 한국 시각 9월 30일 새벽 Z.ai의 오픈웨이트 모델 GLM-5.3 분석을 내놨습니다.
미국 NIST 산하 CAISI는 9월 17일 이 모델을 지금까지 공개된 오픈웨이트 모델 가운데 사이버 능력이 가장 높고 미국 최전선 모델보다 약 4개월 뒤처진다고 평가했는데, 앤트로픽 시험 결과도 대체로 같았습니다.
ExploitBench 410번 가운데 50번에서 끝까지 성공했고, 앤트로픽은 단순한 방법으로 안전장치를 64~100% 우회할 수 있었다고 밝혔습니다.
Choi
앤트로픽은 미국 모델의 안전장치를 낮춘 판이 검증된 사용자에게만 열리는 반면 GLM-5.3은 누구나 내려받는다는 차이를 짚었습니다. Z.ai의 리쯔쉬안은 같은 모델을 쓰는 무료 OpenVuln 서비스가 오픈소스 389개 프로젝트에서 취약점 후보 4,249건을 관리자에게 비공개로 알렸다고 반박했습니다.
보안 테스트 기록과 다국어 데이터로 필요한 전문가만 골라 1.51TB짜리 GLM-5.3을 328GB로 줄였고, 보안용 추가 미세 조정은 하지 않았습니다.
실제 취약점 32개 평가에서 23개를 찾아 원본이 찾은 25개의 92%를 유지했고, 평균 탐지율은 60.4%로 원본 65.6%보다 5.2%p 낮았습니다.
가중치가 공개돼 자체 서버나 폐쇄망에서 H200 4장으로 돌릴 수 있습니다.
Choi
1.51TB를 328GB로 줄이면 모델은 원본의 약 22% 크기가 되고, 그 대가로 평균 탐지율 5.2%p를 내줬습니다.
Unsloth가 GLM-5.3-Flash의 로컬 GGUF 추론을 최적화했습니다.
디코딩 최적화와 Multi-Token Prediction을 적용해 기존보다 1.6~3.4배 빠르게 실행할 수 있다고 합니다.
GLM-5.3-Flash는 전체 320B 중 토큰당 18B만 활성화하는 MoE 모델로, 1M 컨텍스트와 멀티모달을 지원합니다.
3-bit 양자화를 사용하면 128GB 메모리 환경에서도 Unsloth Desktop이나 llama.cpp로 실행할 수 있습니다.
수천억 파라미터급 모델도 양자화와 추론 최적화를 통해 로컬에서 쓸 수 있는 범위로 계속 들어오고 있습니다.
Choi
전체 320B 가운데 토큰당 18B만 켜는 MoE 구조에 3-bit 양자화가 더해져, 수천억 파라미터 모델도 128GB 메모리 장비에서 돌릴 수 있게 됐습니다.
Abliteration.ai가 GLM-5.3 기반 abliterated-model-large-v2를 공개했습니다.
모델 내부에서 거절 반응과 관련된 활성화 방향을 제거해, 기존 모델이 중단하던 보안 테스트나 레드팀 작업을 계속 수행하도록 만든 버전입니다.
Terminal-Bench 4.0에서는 상위권 성능을 기록했고, 사이버 보안 벤치마크도 GLM-5.2보다 크게 올랐다고 합니다.
AI 안전장치를 더 강하게 만드는 흐름과, 반대로 안전장치를 걷어내 연구·보안용으로 쓰려는 흐름이 동시에 커지고 있습니다.
Choi
거절 반응을 지운 모델이 상품으로 팔리면, 학습 단계에서 넣은 안전장치는 배포 뒤에 다시 걷힐 수 있습니다. 성능 점수까지 높아 이 판을 쓰려는 이유도 함께 생깁니다.
320B 파라미터 중 18B가 활성화되는 구조이며, LoRA나 탈옥 프롬프트 대신 모델 가중치 자체를 수정했습니다.
MaliciousInstruct 거부율은 96%→11%, JailbreakBench는 93%→12%까지 떨어졌습니다.
다만 거부 성향이 완전히 사라지지는 않았습니다.
GLM-5.3-Flash의 안전장치가 특정 한 부분에 몰려 있지 않고 더 복잡하게 학습됐을 가능성이 있다는 설명입니다.
Choi
가중치를 직접 고쳤는데도 MaliciousInstruct 거부율 11%, JailbreakBench 12%가 남아, 안전장치가 한 부분에 몰려 있지 않을 가능성이 제기됐습니다.
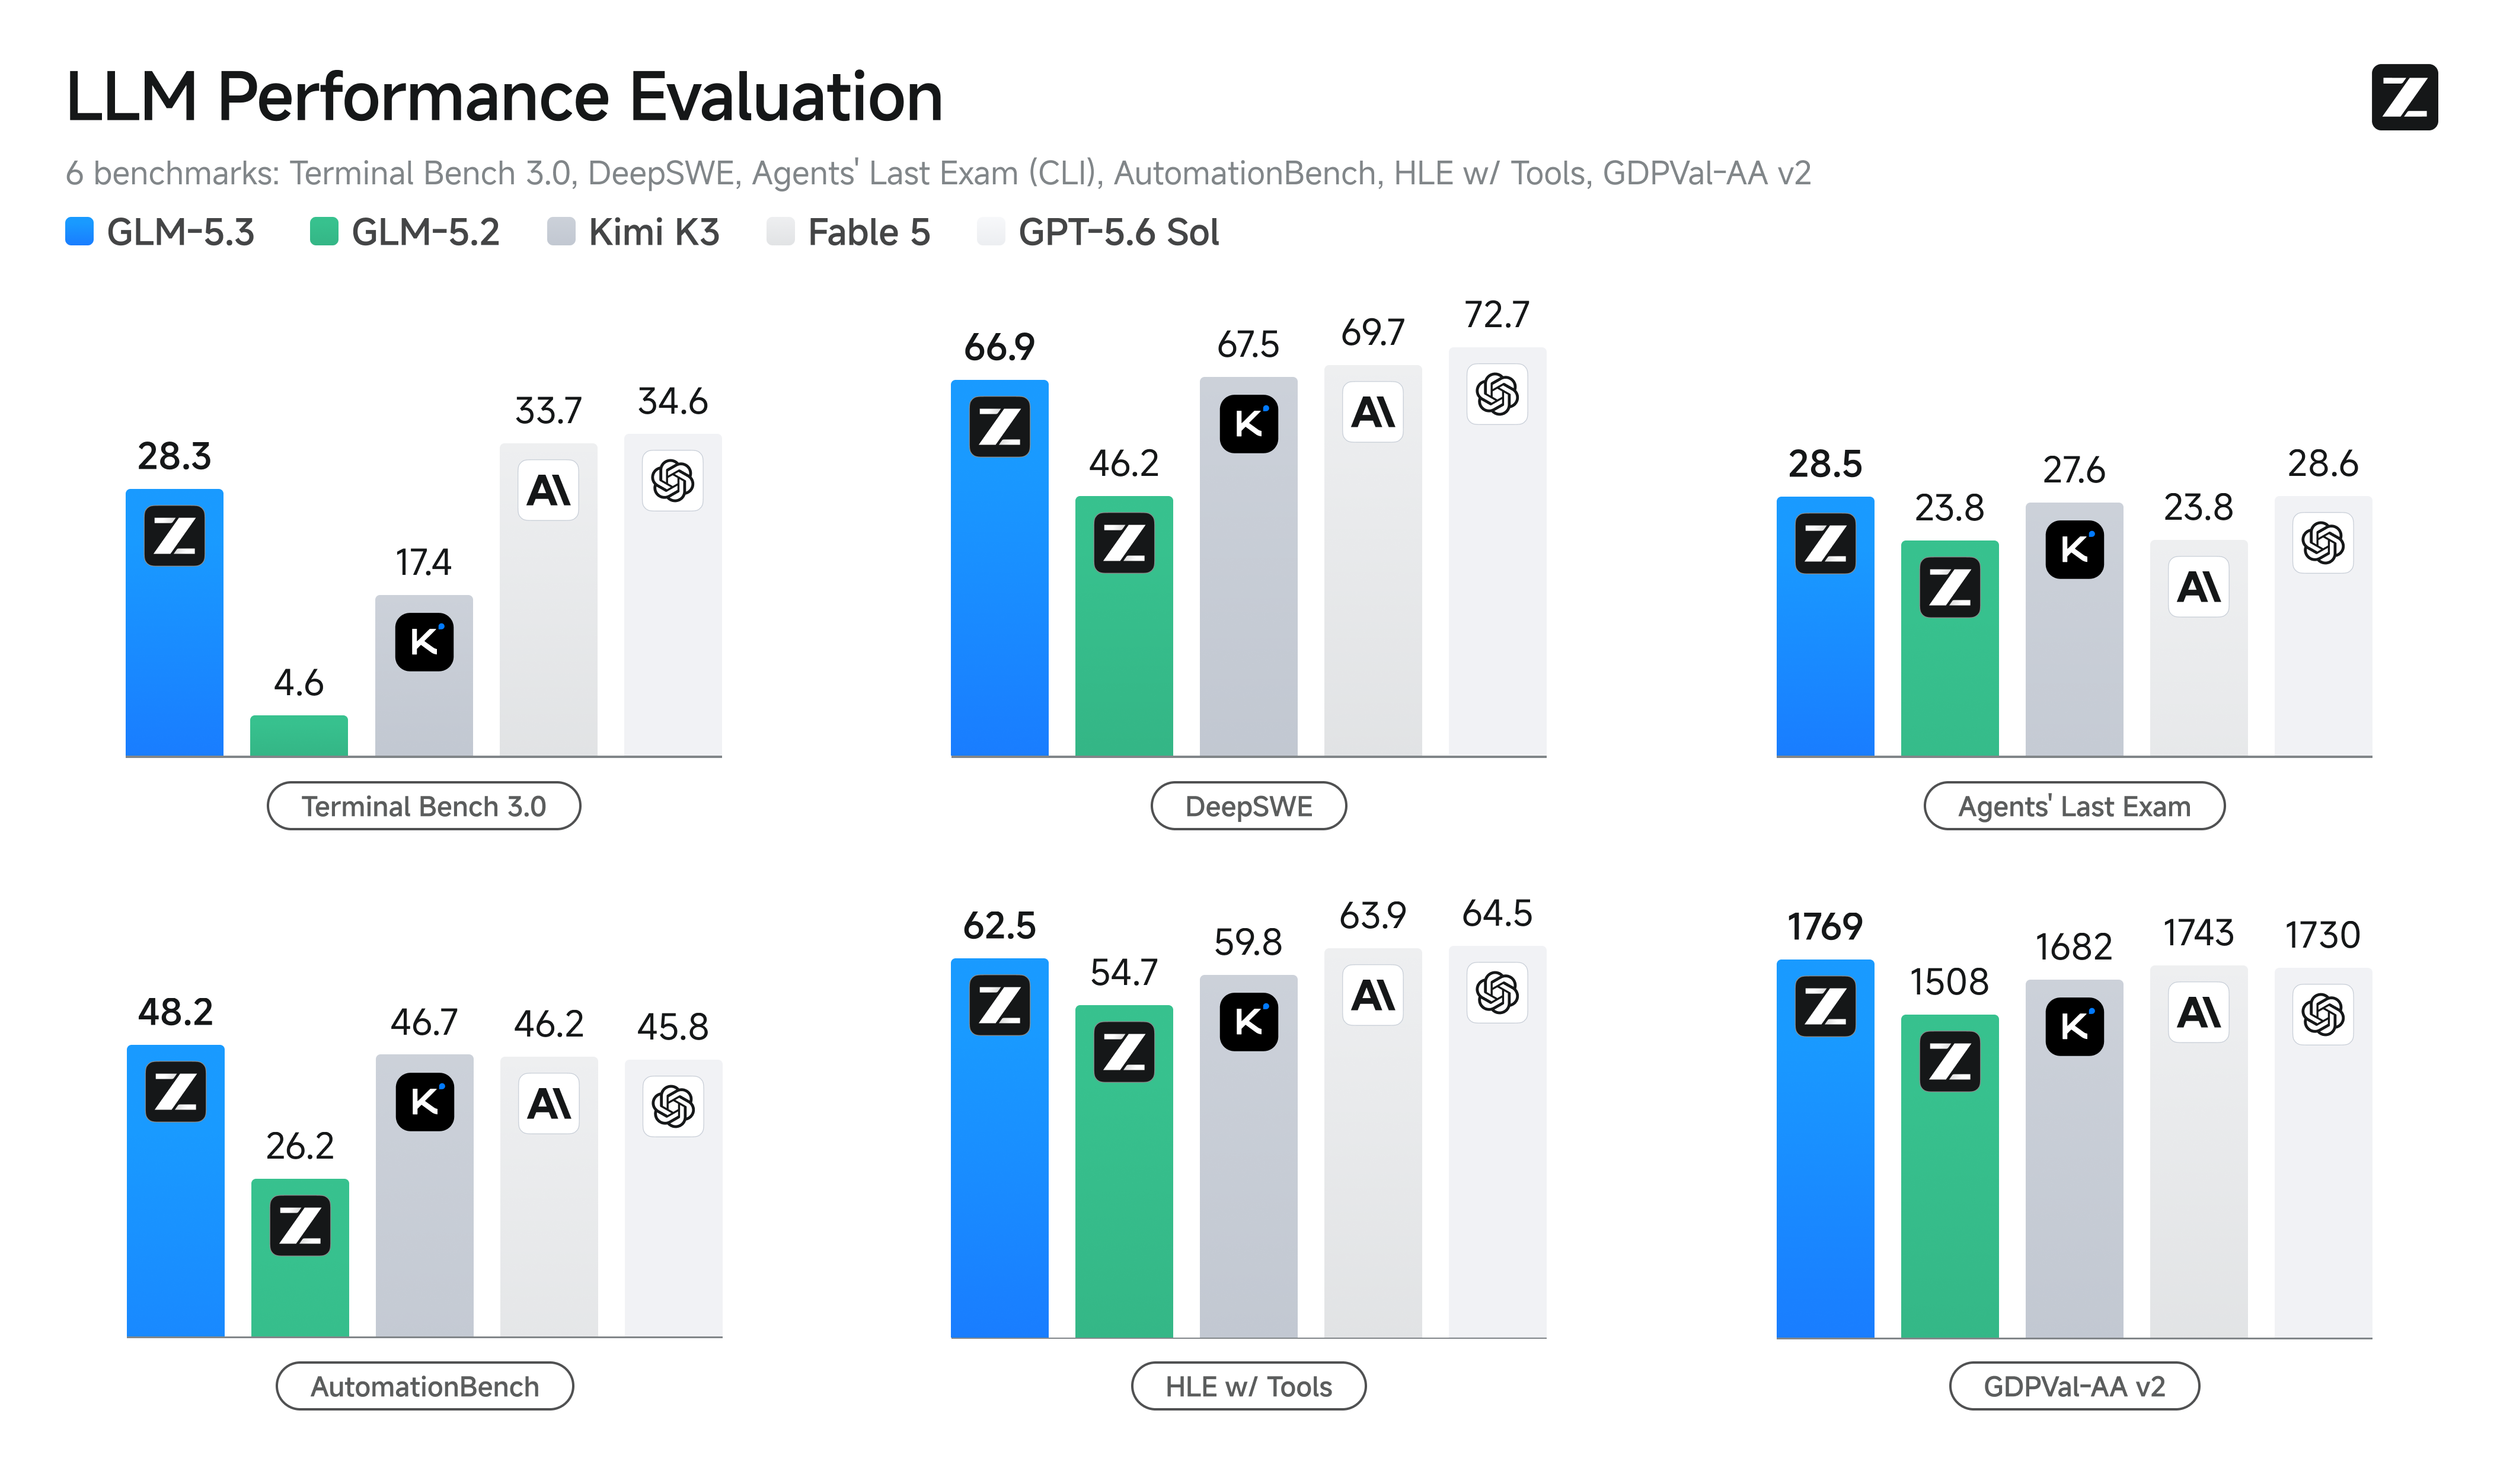
AI가 실제 터미널 환경에서 코딩·보안·머신러닝·시스템 운영 등의 작업을 얼마나 잘 처리하는지 평가하는 Terminal-Bench 4.0이 공개됐습니다.
Z.ai의 오픈웨이트 모델 GLM-5.3 Max가 GPT-5.6 Sol Max보다 높은 성적을 기록했습니다.
Terminal-Bench 4.0은 기존 평가에서 문제가 있던 작업을 수정·제거하고 실행 시간과 CPU, 메모리 조건까지 다시 조정했습니다.
몇 달 전까지만 해도 중국 오픈웨이트 모델은 미국의 최상위 모델을 따라가는 구도였는데, 이제는 새로운 평가가 나오자마자 GPT-5.6 Sol과 경쟁하거나 앞서는 결과까지 나오고 있습니다.
벤치마크 하나로 실제 성능을 전부 판단할 수는 없습니다.
Choi
Terminal-Bench 4.0은 기존 평가에서 문제가 있던 작업을 고치거나 빼고 실행 시간과 CPU·메모리 조건을 다시 맞춘 새 평가입니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.