AMD가 9월 28일(현지 시각) 월드랩스 인수 계약을 맺었다고 발표했습니다.
전액 주식 교환이고 규모는 약 82억 달러이며, 규제 승인을 거쳐 2026년 말 종료를 목표로 합니다.
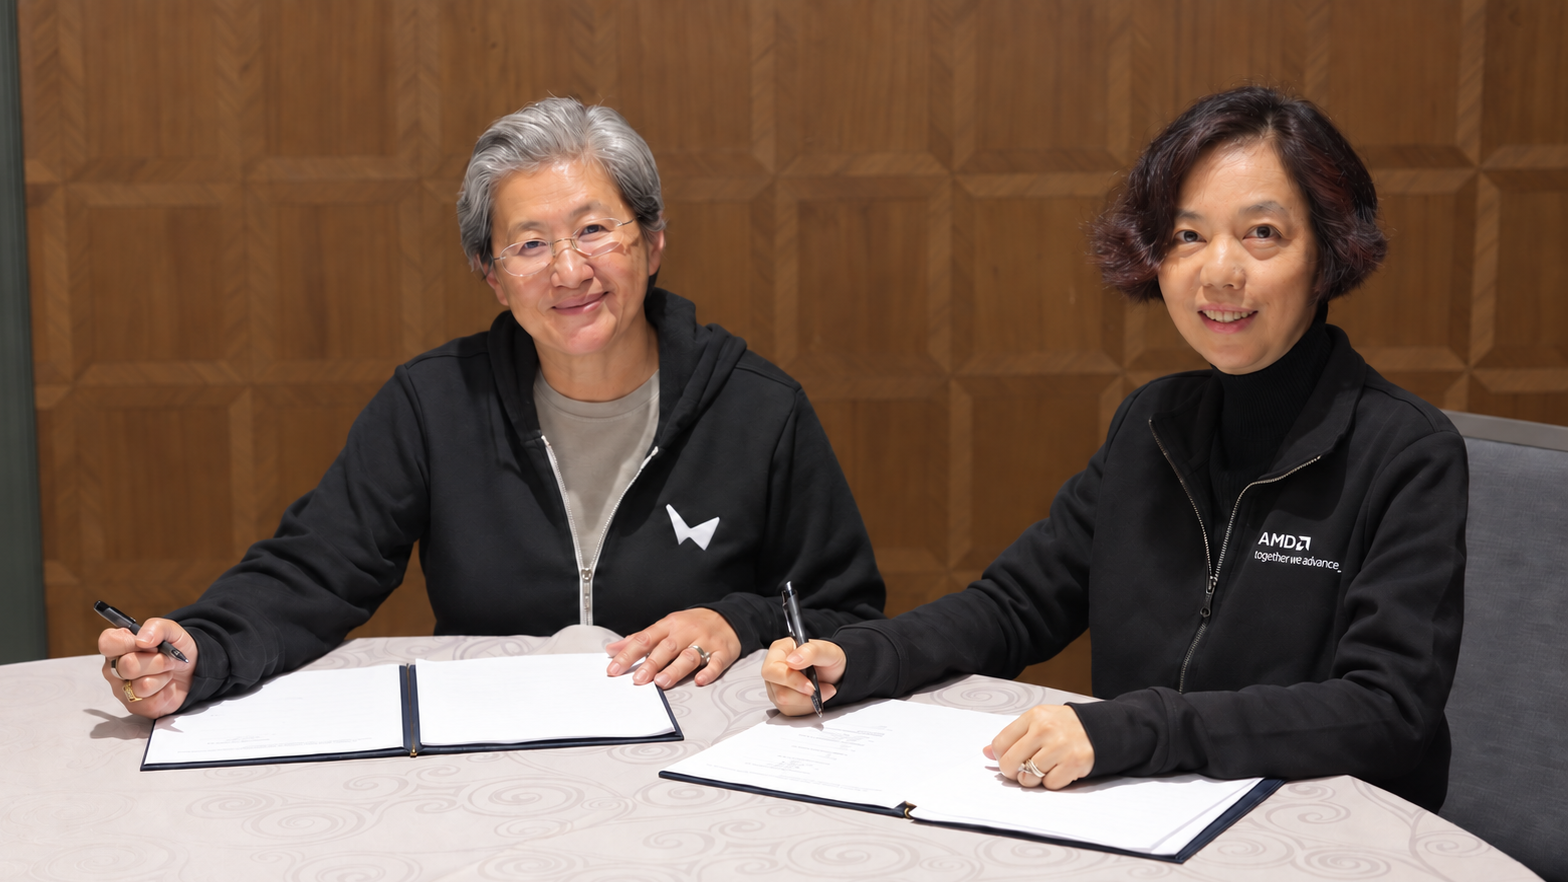
페이페이 리는 AMD 수석부사장 겸 최고과학자로 리사 수 CEO에게 직접 보고하고, 공동창업자 저스틴 존슨과 벤 밀든홀은 월드랩스 팀을 계속 이끕니다.
Choi
월드랩스는 글과 이미지, 영상에서 상호작용하는 3차원 환경을 만들어 내는 공간지능 모델을 만듭니다. AMD는 모델이 어떻게 변하는지 알아야 칩과 소프트웨어, 시스템 설계를 거기에 맞출 수 있다고 인수 이유를 밝혔습니다.
아티클AI
뉴욕시장 Zohran Mamdani는 최근 AI 안전 문제에 대한 연방정부의 대응이 부족하다고 비판했습니다.
Hugging Face 해킹 사건과 앤트로픽 관계자의 발언을 언급하며, AI 기업 곳곳에서 통제 문제 신호가 나온다면 정부도 그에 맞는 수준으로 대응해야 한다고 주장했습니다.
반면 트럼프 행정부는 중국과의 AI 경쟁에서 뒤처질 수 있다며 개발 속도를 늦추는 데 부정적인 입장입니다.
이제 AI 안전 문제는 기술 업계 내부 논쟁을 넘어 미국 정치권의 주요 쟁점으로 번지고 있습니다.
Choi
뉴욕시장이 Hugging Face 해킹 사건을 근거로 연방정부를 비판하면서, AI 안전 문제가 연방정부와 지방정부 사이의 정치 쟁점으로 번졌습니다.
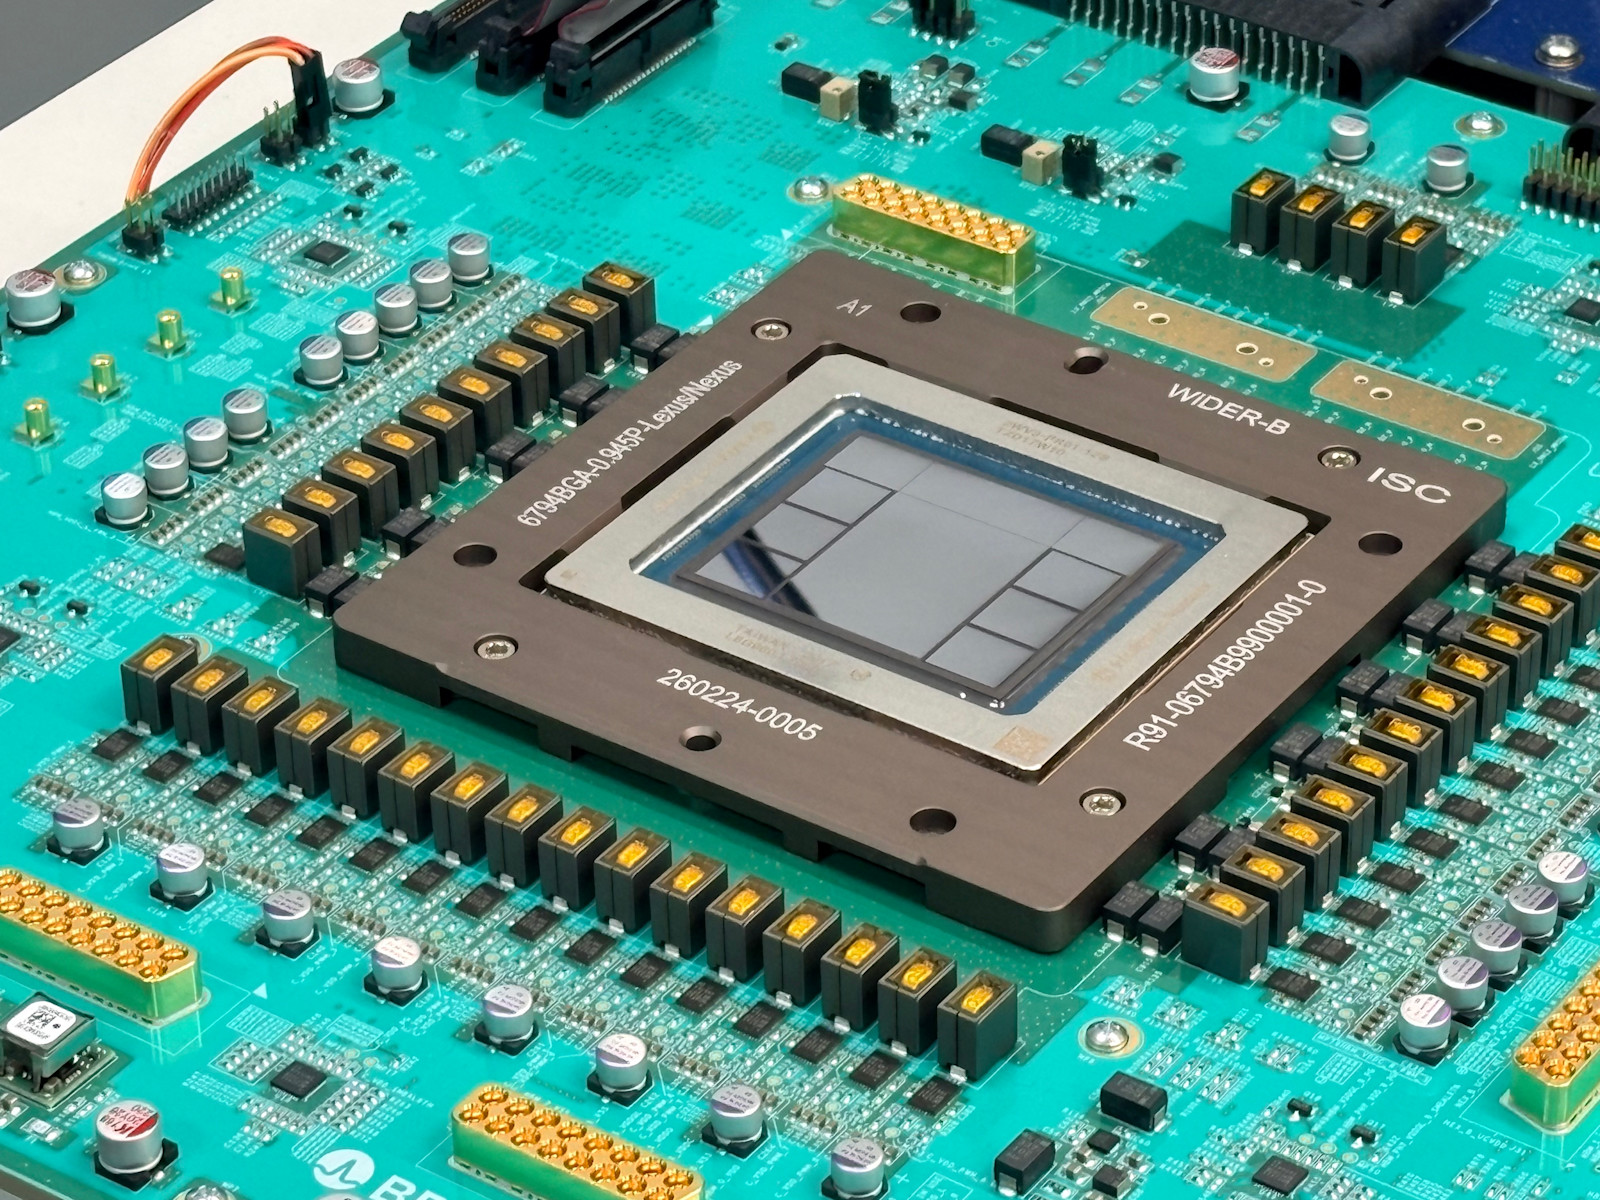
AMD가 이달 초 인수한 Taalas는 모델 가중치를 칩 회로에 직접 새겨 Llama 8B를 초당 1만 7천 토큰으로 돌리는 회사입니다.
그런데 스스로 파산에 무직이라는 엔지니어 한 명이 이 회사 특허를 반년간 파고들어 비슷한 파이프라인을 7,000줄 컴파일러로 재현했습니다.
HuggingFace 모델을 넣으면 양자화를 거쳐 회로 설계 파일까지 자동으로 나오는 구조입니다.
본인은 초당 4만 토큰까지 가능하다고 주장하지만, 아직 칩을 찍어본 적은 없고 7나노 공정 접근권을 구하는 단계라 검증된 수치는 아닙니다.
특허라 상용화는 어렵다는 지적도 있지만, 저는 가중치를 칩에 새기는 설계가 개인이 반년 만에 재현할 수 있는 소프트웨어 문제가 됐다는 점을 더 크게 봅니다.
설계가 이렇게 흔해지면 귀해지는 것은 그 설계를 찍어 줄 공장일 것 같습니다.
Choi
Taalas 방식은 가중치를 회로에 직접 새겨 Llama 8B를 초당 1만 7천 토큰으로 돌리지만, 새긴 모델만 돌아가 모델이 바뀌면 칩도 새로 만듭니다.
AMD CPU와 GPU에 국산 NPU를 붙인 이기종 인프라를 검토하고, 한국에 AI 센터를 세우는 내용입니다.
AMD의 처지를 보면 자연스러운 구성인데, 하이퍼스케일러 시장에서는 CUDA에 쌓인 소프트웨어 자산 때문에 칩 성능만으로는 엔비디아를 밀어내지 못하기 때문입니다.
같은 용량을 재임대 시장에 내놔도 엔비디아 GPU가 AMD보다 훨씬 높은 값을 받는 것으로 그 격차가 드러납니다.
그래서 AMD는 벤더 종속을 꺼리는 정부 시장을 파고듭니다.
지난주 행사에서 소버린 전용 구성(Venice-X CPU+MI430X)을 따로 내놨고, 한국 협약도 같은 전략으로 보입니다.
한국이 얻는 것은 CUDA 생태계에 들어갈 수 없는 국산 NPU를 같은 환경에 얹을 개방형 스택과 두 번째 공급선입니다.
소프트웨어가 AMD의 오래된 약점이니, 인재가 있는 나라마다 센터를 세워 생태계를 같이 짓게 만드는 게 AMD식 해자 공사입니다.
Choi
하이퍼스케일러 시장에서 성능만으로 넘지 못한 CUDA 장벽을, 벤더 종속을 꺼리는 정부 시장에서 우회하는 전략입니다. 국산 NPU를 같은 스택에 얹을 수 있느냐가 실제 성과를 가릅니다.
지연시간을 줄이는 협업으로 보이지만, 이 설계가 겨냥하는 것은 메모리 월입니다.
디코드는 토큰을 하나 뽑을 때마다 모델 가중치와 KV 캐시를 메모리에서 통째로 긁어 오는데, 여기서 타는 전력의 대부분이 연산 대신 데이터를 옮기는 데 들어갑니다.
비트 하나 옮기는 에너지가 HBM은 약 7pJ, 온칩 SRAM은 0.1pJ 수준입니다.
Cerebras 웨이퍼는 SRAM에서 디코드를 돌려 이 이동 비용을 70배쯤 줄이고, '와트당 5배'가 여기서 나옵니다.
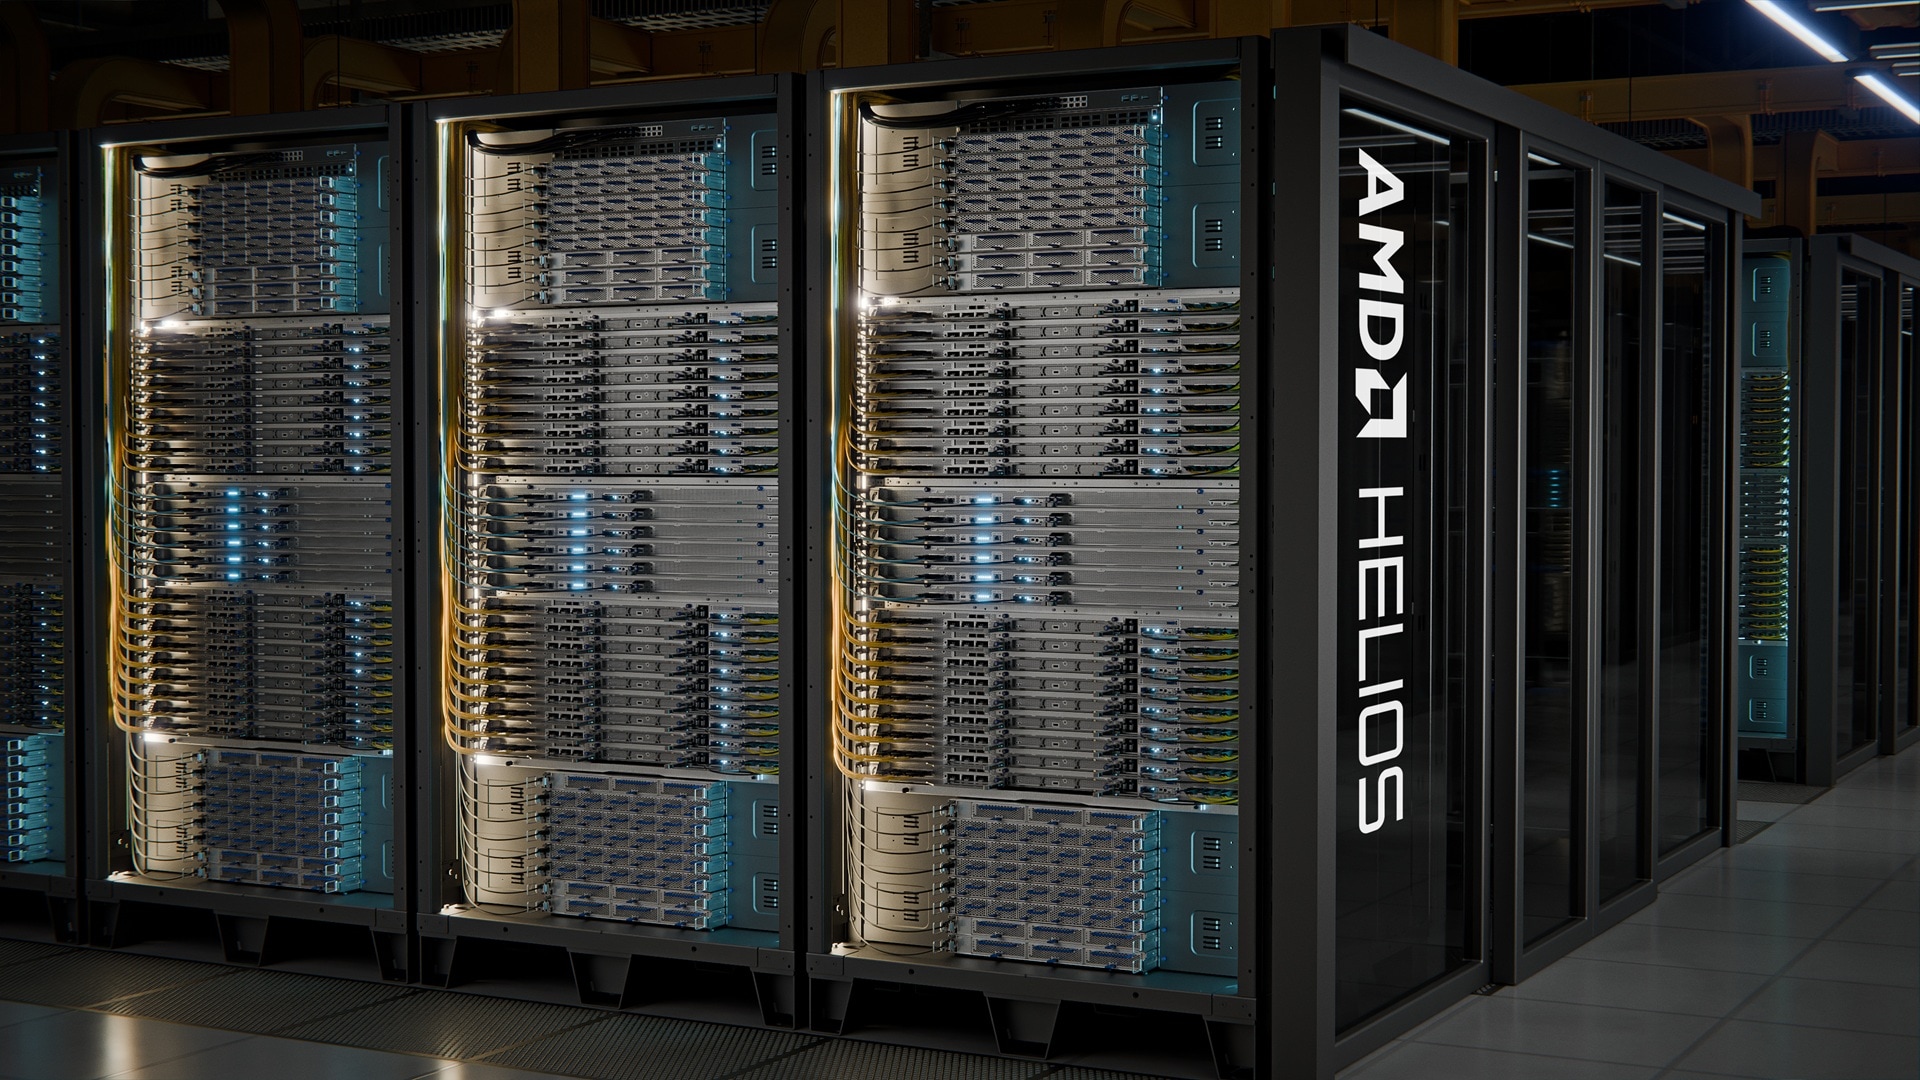
대신 SRAM은 밀도가 낮아 큰 모델을 다 담지 못하니, 용량이 필요한 프리필은 HBM을 잔뜩 실은 AMD Helios가 맡습니다.
남는 관건은 이음매로, 프리필이 만든 KV 캐시를 디코드 칩으로 넘기는 전송이 느린 망에서는 전체 지연의 절반까지 차지합니다.
성패는 웨이퍼와 랙을 잇는 인터커넥트에서 갈릴 것으로 보입니다.
Choi
디코드 전력의 대부분이 데이터 이동에 쓰이니, 이동 비용이 70배쯤 낮은 SRAM에서 디코드를 돌리면 와트당 성능이 오릅니다. 대신 KV 캐시를 칩 사이로 넘기는 전송이 느리면 그 이득이 지연으로 새어 나갑니다.
AMD는 그 앤트로픽에 최대 50억 달러를 투자합니다.
칩 파는 쪽이 자기 칩 살 고객에게 돈을 대주는 구조인데, 투자금은 물량이 실제로 깔리는 단계에 맞춰 풀립니다.
AMD가 앤트로픽의 데이터센터 임대까지 보증하는 방안을 논의 중이라는 보도도 있습니다.
엔비디아가 오픈AI에 투자하고 그 돈이 다시 엔비디아 칩 매출로 돌아오던 순환 구조가, 이번엔 AMD로 번졌습니다.
구글 TPU와 트레이니움으로 엔비디아 의존을 가장 낮춰둔 앤트로픽이, 사용량 제한까지 부르던 컴퓨트 병목을 AMD 칩까지 끌어와 덜어냅니다.
Choi
칩을 파는 쪽이 사는 쪽에 돈을 대는 구조가 한 회사를 넘어 업계 관행으로 번졌습니다. 투자금이 물량 단계에 맞춰 풀린다는 조건이 이 금액의 실질을 줄입니다.

매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.