이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
앞으로 몇 년 동안 강화학습 환경이 지금보다 훨씬 복잡하고 다양해진다
공동체 방식으로 개발하고 배포하는 AI가 시간이 갈수록 더 널리 채택된다
Nemotron 연합의 공동 기반 모델이 차기 Nemotron 4 가족의 토대가 된다
카탄자로는 Nemotron의 일을 두 가지로 설명했습니다. AI가 어떻게 돌아가는지 알아야 블랙웰 같은 칩과 시스템을 함께 설계할 수 있고, AI가 더 많이 만들어지고 배포될수록 엔비디아의 사업 기회가 커진다는 겁니다.
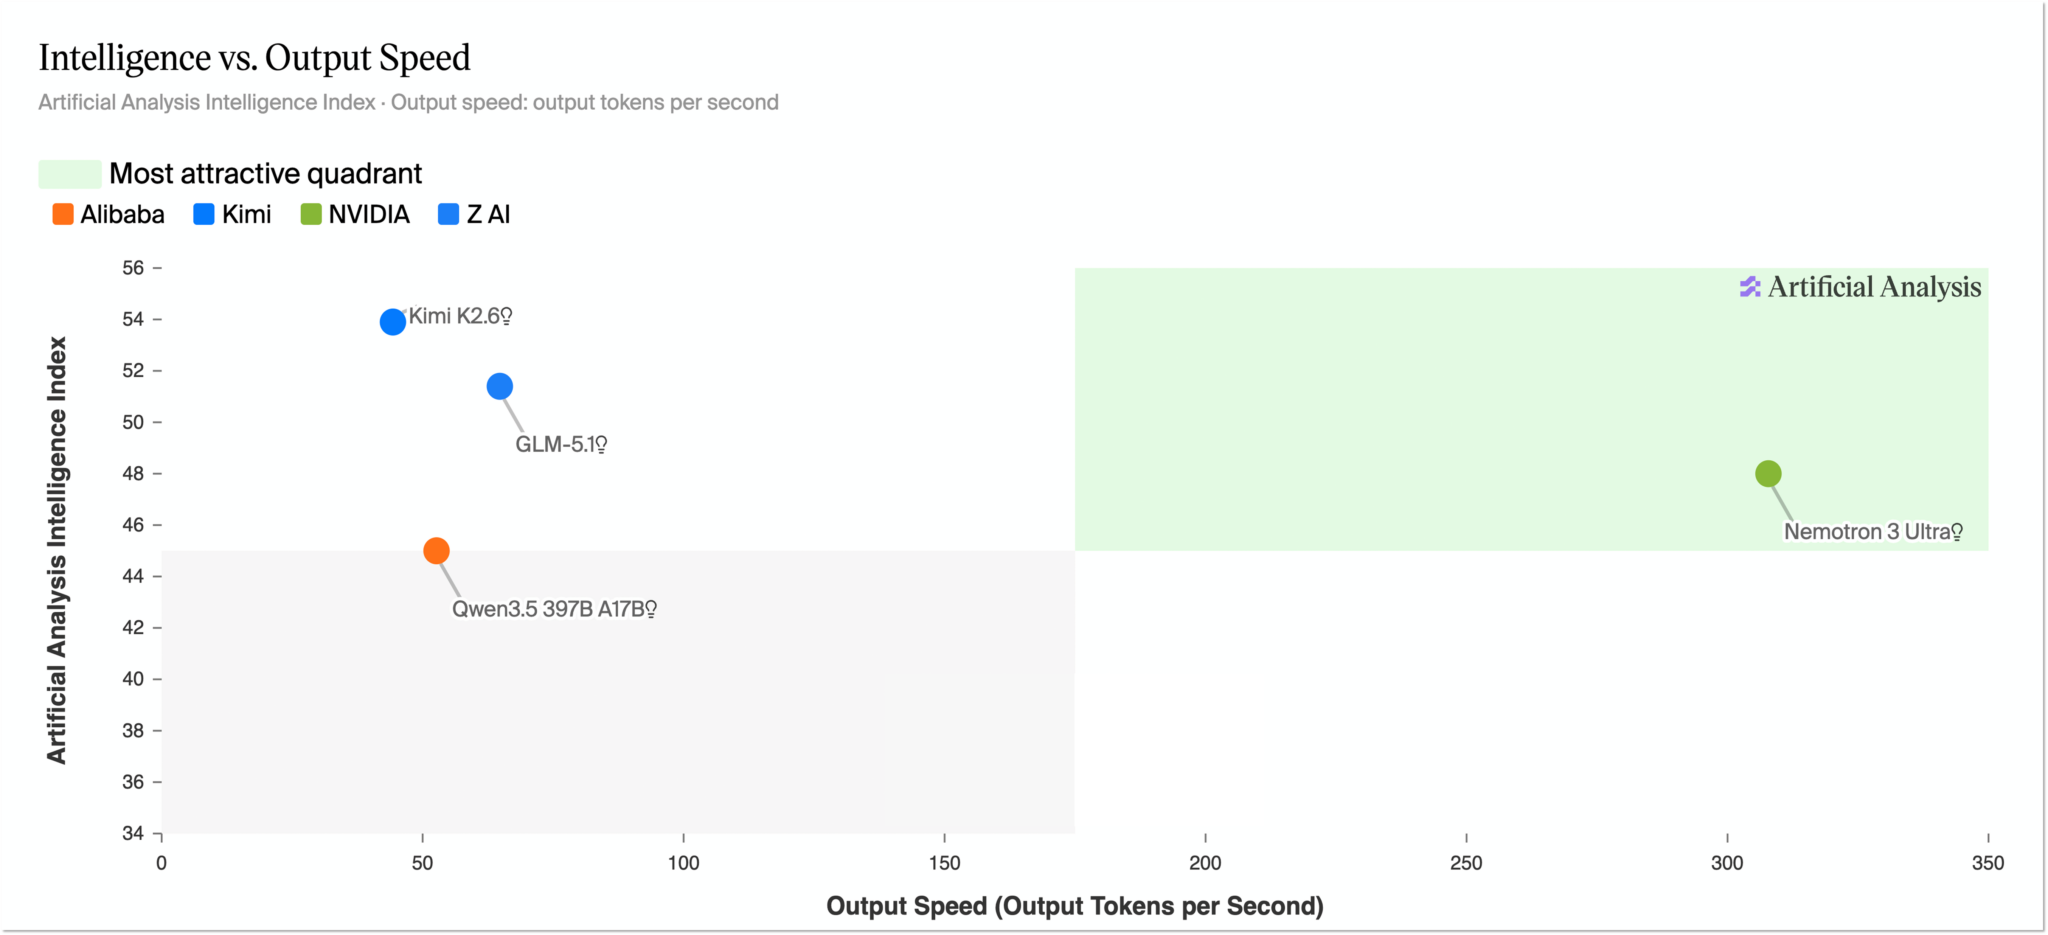
엔비디아 기술 보고서는 같은 조건에서 처리량이 GLM-5.1의 5.9배라고 밝혔지만, 엔비디아가 직접 잰 SWE-Bench Verified 점수는 70.7로 GLM-5.1(76.2)과 Kimi K2.6(75.7)보다 낮습니다. Artificial Analysis 지능 지수도 두 중국 모델이 높고, Ultra는 출력 속도에서 크게 앞섭니다.
숫자를 4비트(16가지 값)와 묶음별 8비트 배율로 나타내 학습하는 방식으로, 메모리와 에너지를 아끼지만 학습이 발산하기 쉽습니다. 엔비디아는 2025년 9월 120억 파라미터·10조 토큰 실험을 거쳐 2026년 6월 Ultra를 20조 토큰 동안 이 형식으로 학습했습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@mattturckX 게시물 · 원문 보기
진행자 맷 터크는 공개 당일 X에 엔비디아는 칩 회사인데 왜 수백 명의 연구자를 모델 만드는 데 두고 그 모델을 공짜로 나눠 주느냐는 물음을 먼저 적었습니다. 그는 대담 첫머리에서 Nemotron 3 Ultra가 나오자마자 미국산 오픈 웨이트 모델 1위에 올랐다고 소개했고, 83분 동안 미국과 중국의 오픈 모델 경쟁, 4비트 학습과 하이브리드 구조, 엔비디아 연구 조직이 일하는 방식을 차례로 물었습니다.
카탄자로는 Nemotron에 일이 두 가지 있다고 답했습니다. 하나는 미래의 시스템을 어떻게 만들지 엔비디아가 이해하게 돕는 일입니다. 그는 무어의 법칙이 이미 몇 년 전에 죽었다고 했습니다. 같은 칩에 트랜지스터를 두 배로 넣는 비용이 예전처럼 내려가지 않으니, 기존 설계를 줄여서 다음 제품을 만드는 방식이 통하지 않고 연산을 문제에 맞춰 특화해야 빨라진다는 겁니다. 특화하려면 AI를 속속들이 알아야 하고, 그래서 Nemotron의 일은 엔비디아가 계속 존재하게 하는 것이라고 했습니다.
그 이해가 칩으로 이어진 예로 그는 블랙웰의 NVL72를 들었습니다. 전문가 혼합(MoE, 토큰마다 모델의 일부 전문가만 골라 계산하는 구조)에서는 토큰이 레이어마다 다른 GPU에 있는 전문가로 옮겨 다니는데, 어디로 갈지 미리 알 수 없습니다. 그래서 GPU 72개가 서로의 메모리를 빠르게 읽고 쓰게 묶었다는 설명입니다.
AI를 이해하려는 작업을 하지 않았다면 블랙웰을 제대로 만들 수 없었을 겁니다.— 브라이언 카탄자로, 엔비디아 응용 딥러닝 연구 부사장 (The MAD Podcast)
다른 하나는 생태계를 받치는 일입니다. AI가 더 개발되고 더 배포될 때마다 엔비디아에는 사업 기회가 생기니, Nemotron이 유일한 오픈 모델이 되려는 것도 아니고 다른 회사의 오픈 모델도 반긴다고 했습니다. 그는 기업이 오픈 모델을 고르는 이유를 한 문장으로 요약했습니다. 모든 회사는 저마다의 비밀을 중심으로 세워져 있고, AI는 그 비밀과 가까이 붙을수록 값어치가 커지는데, 영업 비밀이나 규제 때문에 데이터를 밖에 맡기기 어려운 회사일수록 직접 고쳐 쓸 수 있는 모델이 필요하다는 겁니다.
Nemotron 3 Ultra의 라이선스는 OpenMDW 1.1입니다. 모델과 딸린 데이터·문서를 제한 없이 쓰고 고치고 나눌 수 있고, 배포할 때 이 계약서와 저작권 고지를 함께 두는 정도가 조건이며, 모델이 만든 출력물에는 아무 제한을 두지 않습니다. 3월 11일 나온 Nemotron 3 Super가 엔비디아 자체 오픈 모델 라이선스를 쓴 것과 달라진 대목입니다. 같은 모델 카드에 적힌 최소 사양은 GB200·B200·GB300·B300이나 H200 8장, 또는 H100 16장입니다.
데이터도 함께 풀었습니다. 카탄자로는 학습 데이터를 사서 쓰되 재배포할 권리가 있는 것은 공개하고, 자체 GPU로 언어 모델을 돌려 합성 데이터를 대량으로 만든다고 했습니다. 모델 카드를 보면 Ultra는 약 20조 토큰으로 사전학습했고, 공개된 사전학습 데이터 가운데 커먼 크롤 웹 문서를 거른 Nemotron-CC v2·v2.1만 9.1조 토큰입니다. 그는 다른 회사 모델이 이 데이터셋을 가져다 쓴다는 소식이 들리면 생태계를 키우는 일이 잘되고 있다는 뜻으로 받아들인다고 했습니다.
엔비디아는 3월 16일 GTC에서 Nemotron 연합을 만들었습니다. 미스트랄 AI, 커서, 퍼플렉시티, 싱킹 머신스 랩 등 8곳이 데이터와 평가, 전문 지식을 보태고, 첫 과제로 미스트랄과 엔비디아가 함께 만드는 기반 모델을 차기 Nemotron 4의 토대로 삼기로 했습니다. 카탄자로는 어차피 공개할 모델이라면 다 만든 뒤 써 보라고 올리는 대신, 만들기 전부터 쓸 회사들과 함께 짜는 편이 낫다고 설명했습니다. 6월 4일 Ultra 공개 때는 네이버클라우드와 H 컴퍼니, 누스 리서치, 프라임 인텔렉트가 연합에 새로 들어왔습니다. 네이버클라우드는 Ultra를 미리 받아 그 구조와 Nemotron 데이터셋으로 차세대 하이퍼클로바X를 학습하고 있다고 엔비디아가 6월 1일 밝혔고, Ultra가 지원하는 10개 언어에는 한국어가 들어 있습니다.
카탄자로가 엔비디아에 들어온 것은 대학원생이던 2008년입니다. 그해 국제머신러닝학회(ICML)에 GPU로 모델을 학습하는 첫 논문을 냈더니, 여기는 멋진 수학을 하는 곳인데 왜 왔느냐는 반응이 돌아왔다고 했습니다. GPU는 게임용 아니냐는 터크의 물음에는 GPU란 엔비디아가 GPU라고 하는 것이라고 받았습니다. 1995년에 세상에서 가장 중요한 계산은 그래픽이었고, 오래전부터는 AI라는 겁니다. 이후 그는 엔비디아 최초의 딥러닝 제품인 cuDNN을 만드는 데 참여했고, 바이두 실리콘밸리 AI 연구소에서 2년 반 동안 앤드루 응, 다리오 아모데이와 함께 일했습니다. 아모데이를 면접한 패널에 그도 있었고, 2015년 음성인식 논문 딥 스피치 2에는 세 사람의 이름이 함께 올라 있습니다.
2016년 젠슨 황의 전화를 받고 돌아와 처음 만든 것이 게임 그래픽을 AI로 채우는 DLSS였습니다. 그는 요즘 DLSS를 켜고 게임을 하면 픽셀 24개 가운데 23개를 AI 모델이 만든다고 했습니다. 이어 2017년에는 가장 크고 센 트랜스포머라는 뜻의 Megatron 프로젝트를 시작했습니다. 트랜스포머를 발명한 구글의 TPU로만 큰 모델을 학습할 수 있다는 주장이 돌던 때, GPU로도 된다는 것을 보이려는 시스템 연구였다고 했습니다. Nemotron이라는 이름은 AI 소프트웨어를 만들던 NeMo 팀과 Megatron 팀이 힘을 합치며 붙었습니다.
| 공개 | 모델 | 특징 |
|---|---|---|
| 2019년 9월 | Megatron-LM 논문 | GPU 여러 장에 트랜스포머를 나눠 학습 |
| 2022년 1월 | Megatron-Turing NLG 530B 논문 | 마이크로소프트와 공동 학습, 나중에 Nemotron 1로 부름 |
| 2024년 6월 | Nemotron-4 340B | 오픈 모델 라이선스로 공개 |
| 2025년 12월 15일 | Nemotron 3 Nano | 전체 300억·활성 30억 파라미터 |
| 2026년 3월 11일 | Nemotron 3 Super | 전체 1,200억·활성 120억, 100만 토큰 |
| 2026년 6월 4일 | Nemotron 3 Ultra | 전체 5,500억·활성 550억, 20조 토큰 4비트 사전학습 |
그는 작년에 낸 Nemotron 2에 전문가 혼합이 없어 오픈AI의 GPT-OSS 20B보다 느렸고, 그래서 서둘러 MoE를 넣은 것이 Nemotron 3라고 했습니다. 다음 세대 이름을 두고는 2024년에 이미 Nemotron-4를 냈으니 마케팅 문제가 생겼다며, 자기가 만든 문제는 아니라고 했습니다.
Nemotron 3에서 카탄자로가 가장 자랑한 것은 Super와 Ultra를 NVFP4라는 4비트 형식으로 사전학습한 일입니다. 4비트로는 값을 16개밖에 나타낼 수 없고, 숫자 묶음마다 8비트 배율을 따로 붙여 범위를 맞춥니다. 추론용 4비트 형식은 이미 널리 쓰이지만, 가중치를 계속 고쳐 가는 사전학습을 이렇게 거친 숫자로 하면 학습이 발산해 모델을 버리게 될 수 있어 새 알고리즘이 필요했다고 했습니다.
우리가 한계에서 달리게 된다는 것을 사실로 받아들이면, 더 많은 지능을 얻는 길은 더 효율적이 되는 것입니다.— 브라이언 카탄자로, 엔비디아 응용 딥러닝 연구 부사장 (The MAD Podcast)
그 한계는 서버를 살 돈일 수도 있고 쓸 수 있는 전력일 수도 있다고 그는 덧붙였습니다. 4비트 숫자는 메모리에서 옮길 때와 계산할 때 드는 에너지가 적고, 블랙웰 울트라는 이 형식의 처리량이 훨씬 높습니다. 엔비디아가 2025년 9월 낸 논문에서 4비트로 학습한 모델은 120억 파라미터, 10조 토큰이었고 당시 공개된 4비트 학습 가운데 가장 길었습니다. 9개월 뒤 Ultra는 5,500억 파라미터 모델을 20조 토큰 동안 같은 형식으로 학습했습니다.
구조도 속도 쪽으로 짰습니다. 엔비디아가 2024년 6월 낸 연구에서 맘바-2(입력 전체를 고정된 크기의 상태로 요약해 가며 읽는 상태공간 모델) 레이어 43%, 어텐션 7%, MLP 50%로 짠 80억 파라미터 모델은 같은 크기 트랜스포머를 12개 과제 모두에서 평균 2.65점 앞섰습니다. 카탄자로는 상태공간 모델이 흐름을 어림잡아 전체를 이해하는 데 강하고, 어텐션은 특정 정보를 정확히 집어 오는 데 강해서 둘을 섞으면 더 똑똑해진다고 설명했습니다.
여기에 토큰 벡터를 압축해 GPU 사이로 보내는 LatentMoE로 같은 추론 비용에서 전문가 수를 4배로 늘렸고, 한 번에 여러 토큰을 미리 예측한 뒤 다음 계산에서 검증하는 다중 토큰 예측(MTP)도 넣었습니다. 예측이 정확할수록 빨라지니 모델의 정확도가 곧 속도라는 것이 그의 말입니다. 그는 추론을 2026년의 가장 중요한 계산으로 꼽으며, 다중 토큰 예측의 정확도에 따라 추론 비용이 3분의 1로 줄 수 있다면 엔비디아의 사업에 곧바로 영향을 준다고 했습니다.
엔비디아 기술 보고서는 8K 토큰을 넣고 64K 토큰을 받는 조건에서 Ultra의 처리량이 GLM-5.1의 5.9배, Kimi K2.6의 4.8배, Qwen 3.5의 1.6배라고 적었습니다. 한데 같은 회사가 공개한 비교표에서 Ultra가 늘 앞서지는 않습니다. 모델 카드의 점수는 모두 엔비디아가 자체 평가 도구로 잰 값입니다.
| 벤치마크 | Nemotron 3 Ultra | GLM-5.1 | Kimi K2.6 | 딥시크 V4 Pro |
|---|---|---|---|---|
| SWE-Bench Verified (코딩) | 70.7 | 76.2 | 75.7 | 74.5 |
| HLE, 도구 없이 (고난도 지식) | 26.7 | 27.2 | 34.8 | 37.7 |
| OmniScience 환각 없는 비율 | 78.7 | 66.8 | 67.1 | 5.7 |
엔비디아 블로그에 실린 Artificial Analysis 도표도 같은 모양입니다. Ultra는 초당 300토큰 넘게 출력해 다른 모델들과 멀리 떨어져 있지만, 지능 지수는 Kimi K2.6과 GLM-5.1보다 낮습니다. 카탄자로가 Nemotron을 처음부터 속도 우선으로 만든다고 말한 대로, Ultra가 겨루는 것은 에이전트가 오래 일할 때 드는 시간과 비용입니다. 엔비디아는 복잡한 에이전트 작업 비용을 최대 30% 줄인다고 밝혔습니다.
중국을 두고 카탄자로는 바이두에서 일하며 본 동료들을 떠올렸습니다. 중국의 성과가 베끼기에서 나왔다는 말은 완전히 틀렸다고 했고, 중국 AI 업계가 만든 것을 열어 둔 덕에 많은 회사가 혼자서는 못 했을 것을 만들었다며 나머지 세계가 따라잡을 것은 개방성이라고 했습니다. 터크가 폐쇄형 연구소들이 증류를 막기 시작하면 오픈소스가 느려지지 않느냐고 묻자, 소수가 좋은 생각을 독점하는 일은 없다고 답했습니다. Ultra 기술 보고서를 보면 엔비디아도 검색 에이전트 학습 데이터를 만들 때 MiniMax와 GLM 같은 중국 오픈 모델을 교사로 썼습니다.
@ctnzrX 게시물 · 원문 보기
마지막 후속 학습은 다중 교사 온폴리시 증류(MOPD)였습니다. 과학, 수학 증명, 코딩, 에이전트 작업처럼 분야마다 따로 끝까지 밀어붙인 교사 모델을 만든 뒤, 학생 모델이 스스로 낸 답의 토큰 하나하나를 교사가 채점하게 해 모든 분야를 한 모델에 모으는 방식입니다. 카탄자로는 교사가 10~15개였다고 했고, 기술 보고서에는 10개가 넘는다고 적혀 있습니다. 그는 이 기법이 사람 문제를 풀었다고 했습니다. 예를 들어 500명이 모델 하나를 고치는데 팀마다 자기 분야를 앞세우면 줄다리기가 벌어지는데, 분야별 교사를 따로 두면 모두의 작업이 모델에 들어간다는 겁니다.
조직도 그렇게 굴러갑니다. 카탄자로의 팀은 공식 연구 조직이 아닌 GPU를 설계하는 조직에 속해 있고, 회사 안 10개쯤 되는 팀이 Nemotron에 참여합니다. 직원 누구나 사내 사이트에 아이디어를 올리면 분야별 책임자 25명이 검토하고, 연산은 2주마다 프로그램과 프로젝트의 요청을 모아 나눕니다. 연구자마다 GPU가 1,000배만 있으면 세상을 바꿀 수 있다고 믿지만 그만큼은 없다며, 그는 이 배분 방식에 아직 고칠 점이 많다고 인정했습니다. 엔비디아는 최근 Nemotron에 쓰는 연산 투자를 크게 늘렸다고도 했습니다.
카탄자로는 특이점을 믿지 않는다고 했습니다. 회사가 다음 CEO를 뽑을 때 국제수학올림피아드 수상자를 찾지는 않는다며, 지능은 여러 얼굴을 가졌고 맥락에 따라 쓸모가 달라진다는 이유를 댔습니다. 엔진의 힘이 아무리 세도 바퀴가 없으면 가지 못한다는 비유도 들었습니다. 사람이 부엌이라는 바깥 위장을 만든 뒤 농업과 도시가 생겼듯, 지금은 바깥 두뇌를 만들고 있고 그 파장은 아무도 모른다고 했습니다.
안전에 대한 답은 대담 마지막에 나왔습니다. 그는 앤트로픽 Fable 5가 출시 3일 만에 미국 정부의 수출통제로 막혔다 18일 만에 풀린 일을 안전 우려의 결과로 봤고, 그래도 소수가 모두의 안전을 맡는 구조보다 더 많은 사람이 들여다보는 쪽이 안전하다고 주장했습니다. 한 가지 생각만 안전하다고 정하는 단일 문화보다 다양성이 안전하다며, 미국이 양심과 표현의 자유를 법으로 지켜 온 역사를 근거로 들었습니다.
저는 햇빛이 더 많이 드는 만큼 열린 기술이 대체로 더 안전하다고 봅니다.— 브라이언 카탄자로, 엔비디아 응용 딥러닝 연구 부사장 (The MAD Podcast)
카탄자로의 말은 몇 가지로 맞춰 볼 수 있습니다. 미스트랄과 함께 만드는 연합 기반 모델이 Nemotron 4로 나오는지, 그때도 OpenMDW처럼 조건이 느슨한 라이선스를 쓰는지, 그리고 이름이 겹치는 2024년의 Nemotron-4 340B와 어떻게 구분하는지입니다. 그는 지금 강화학습 환경이 아직 단순하다며 앞으로 몇 년 동안 훨씬 복잡하고 다양해질 것으로 봤습니다. 네이버클라우드가 Ultra의 구조와 Nemotron 데이터로 학습 중인 차세대 하이퍼클로바X가 언제 어떤 성능으로 나오는지도 한국에서 맞춰 볼 수 있는 대목입니다.
읽어 주셔서 고맙습니다.
초이 드림