이 글 어땠어요?
결과가 나오면 맞았는지 그대로 적어요.
양수만 쓰는 구조는 뇌를 흉내 낸 칩과 잘 맞아 전력을 크게 아낄 수 있다
저자들은 아날로그·광·시냅스 소자 기반 뉴로모픽 기판에 맞을 수 있다고 적었지만 칩 위 측정은 논문에 없고, 음의 기여를 처리하는 회로는 여전히 필요하다고 밝혔습니다.
뉴런 하나가 모든 시냅스에서 같은 신경전달물질을 내보내, 연결된 상대를 모두 깨우는 흥분성이거나 모두 재우는 억제성 가운데 한쪽으로만 작동한다는 원칙입니다. 지금의 인공 신경망은 뉴런 하나의 연결에 양수와 음수를 섞어 이 원칙을 지키지 않습니다.
논문은 인터넷 아카이브에 남은 가네코 이사무(I. Kaneko)의 개인 홈페이지를 원조로 인용했습니다. 이 홈페이지는 1999년 7월 12일 샘플 프로그램을 공개했고, 가네코는 2001년 파일 공유 프로그램 Winny를 만들기 시작한 프로그래머입니다.
HalfCheetah에서는 5494점으로 역전파 PPO의 3520점을 앞섰지만 Humanoid와 Craftax에서는 뒤처졌고, CIFAR-10 61.7%는 DFA의 69.1%보다 낮습니다. 저자들도 CIFAR-10 정확도가 기존 방법과 겨룰 수준과는 거리가 멀다고 적었습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
애플 연구진이 10월 1일 공개한 LoopCD는 루프 모델이 버리던 첫 바퀴 예측을 기준점 삼아 마지막 예측을 한 번 더 밉니다. 추가 학습 없이 AIME 2024 정답률이 61.88%에서 73.33%로 올랐고, 연산 22.5~48.2% 절감은 객관식 실험에서 쟀습니다.
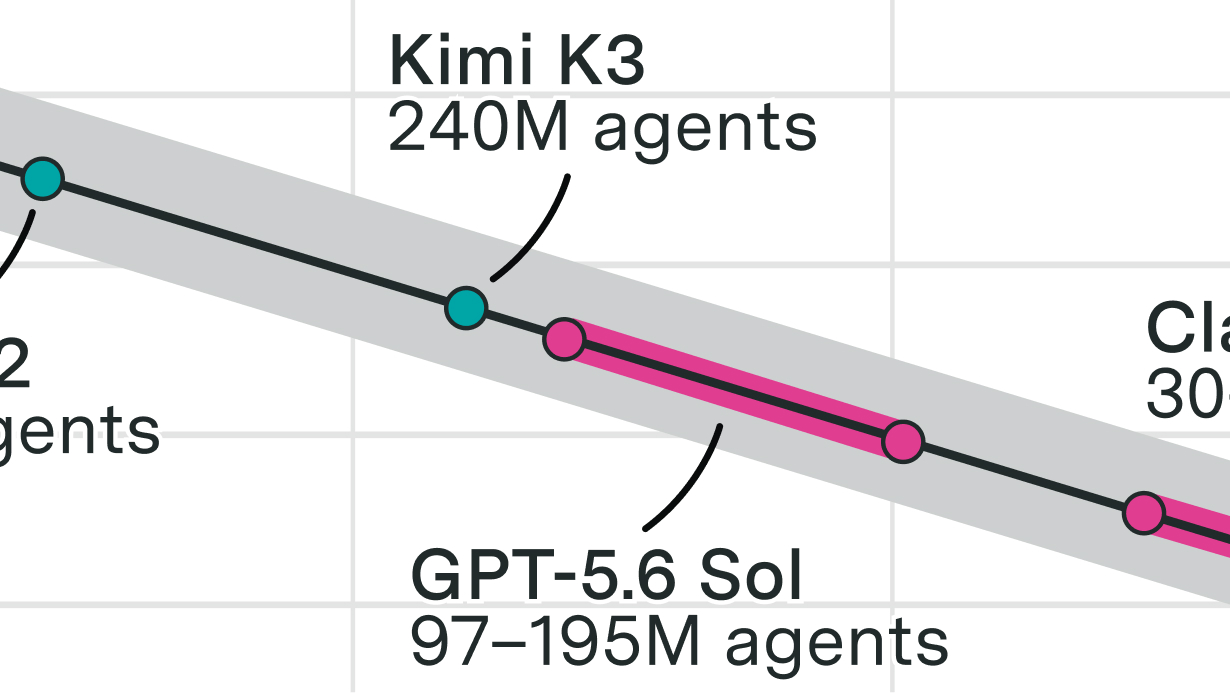
에포크 AI가 10월 2일 HBM 출하량으로 AI 에이전트 수를 셌습니다. 2027년까지 나올 메모리로 프런티어 에이전트 3,300만~1억 7,100만 개를 동시에 돌릴 수 있고, 용량의 20%만 써도 연 2조 6,000억~5조 3,000억 달러어치입니다.
7월 13일 네이처 커뮤니케이션스에 실린 사카나·코펜하겐 IT대학 논문에서 큐브 197개가 약 70초 만에 자기 모양을 맞혔습니다. 비교용으로 넣은 학습 없는 알고리즘도 시뮬레이션에서 100%를 냈습니다.

애플 연구진이 10월 1일 공개한 LoopCD는 루프 모델이 버리던 첫 바퀴 예측을 기준점 삼아 마지막 예측을 한 번 더 밉니다. 추가 학습 없이 AIME 2024 정답률이 61.88%에서 73.33%로 올랐고, 연산 22.5~48.2% 절감은 객관식 실험에서 쟀습니다.

에포크 AI가 10월 2일 HBM 출하량으로 AI 에이전트 수를 셌습니다. 2027년까지 나올 메모리로 프런티어 에이전트 3,300만~1억 7,100만 개를 동시에 돌릴 수 있고, 용량의 20%만 써도 연 2조 6,000억~5조 3,000억 달러어치입니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@SakanaAILabsX 게시물 · 원문 보기
사카나는 발표 게시물에서 질문을 이렇게 세웠습니다. 실제 뉴런은 대체로 흥분성이거나 억제성인데, 인공 신경망은 뉴런 하나가 내보내는 연결에 양수와 음수를 마음대로 섞습니다. 역전파는 여기에 더해 앞으로 흐른 가중치를 정확히 뒤집은 복사본을 요구하는데, 생물에는 그런 장치가 있는 것 같지 않습니다. 그래서 뉴런 역할을 엄격히 고정한 신경망이 가중치를 거꾸로 나르지 않고도 잘 배울 수 있는지 물었고, 이미지 분류와 강화학습 양쪽에서 된다는 답을 냈다고 적었습니다.
역전파는 신경망이 틀린 만큼을 출력에서 입력 쪽으로 한 층씩 되짚으며 연결마다 고칠 양을 계산하는 방법입니다. 되짚을 때는 앞으로 계산할 때 쓴 가중치를 그대로 뒤집어 씁니다. 뉴런 A가 B로 신호를 보낸 연결의 세기와 똑같은 값이, B에서 A로 오차를 돌려보낼 때도 있어야 하는 구조입니다. 뇌의 시냅스는 한 방향으로만 신호를 보내고 이런 거울 복사본을 만드는 방법도 알려져 있지 않아, 이 어긋남을 가중치 수송 문제라고 부릅니다.
뇌에는 규칙이 하나 더 있습니다. 뉴런 하나는 자기가 닿는 모든 시냅스에서 같은 신경전달물질을 내보냅니다. 그래서 어떤 뉴런은 연결된 상대를 모두 깨우는 흥분성으로, 어떤 뉴런은 모두 재우는 억제성으로 작동합니다. 1935년 헨리 데일의 연구에서 이름을 딴 데일 원칙입니다. 지금의 인공 신경망은 이 원칙을 지키지 않아서, 같은 뉴런이 어떤 상대는 밀고 어떤 상대는 당깁니다.
거울 복사본을 피하려는 시도는 전에도 있었습니다. 피드백 정렬(FA)은 되짚는 가중치를 무작위로 정해 고정하고, 직접 피드백 정렬(DFA)은 출력 오차를 고정된 무작위 행렬로 은닉층마다 곧장 보냅니다. 논문은 이런 방법들이 가중치 수송은 피해도 모두 부호가 자유로운 가중치를 허용해 데일 원칙은 지키지 않는다고 짚었습니다.
| 방법 | 오차를 되돌리는 길 | 데일 원칙 |
|---|---|---|
| 역전파 | 앞 가중치를 뒤집은 복사본으로 한 층씩 | 안 지킴 |
| 피드백 정렬(FA) | 고정한 무작위 가중치로 한 층씩 | 안 지킴 |
| 직접 피드백 정렬(DFA) | 고정한 무작위 행렬로 은닉층마다 곧장 | 안 지킴 |
| 오차 확산(ED) | 출력 오차를 정해진 규칙에 따라 은닉 뉴런에 곧장 | 지킴 |
논문이 오차 확산의 원조로 인용한 문헌은 학술지 논문이 아닙니다. 인터넷 아카이브에 남은 2000년 3월 6일자 개인 홈페이지 사본이고, 저자는 I. Kaneko로 적혀 있습니다. 이 홈페이지는 1999년 7월 12일 「오차 확산 학습법의 샘플 프로그램」을 올렸고, 연락처로 일본원자력연구소 메일 주소를 남겼습니다. 홈페이지는 이후 「가네코 이사무의 소프트웨어 페이지」로 옮겨 갔습니다. 가네코 이사무는 1999년 박사 학위를 받고 일본원자력연구소에서 박사후연구원으로 일하다가, 2001년 파일 공유 프로그램 Winny를 만들기 시작한 프로그래머입니다. 그는 2013년 세상을 떠났습니다.
홈페이지에서 가네코는 역전파가 실제 신경계의 모델로는 너무 부자연스럽다고 적었습니다. 특히 오차 정보가 축삭을 거꾸로 흐르며 계산된다는 대목을 납득할 수 없다고 했습니다. 그가 내놓은 대안은 오차가 공간으로 퍼진다는 가정입니다. 도파민 같은 아민 계열 물질이 주변 신경세포에 한꺼번에 퍼지듯, 출력층의 오차를 이웃 뉴런 무리가 함께 나눠 받는다는 생각입니다.
두 번째 기둥은 흥분성 신경세포의 출력은 모두 흥분으로, 억제성 신경세포의 출력은 모두 억제로 작용한다는 사실이었습니다. 이 두 가정을 두면 출력을 올리거나 내리려고 은닉층 가중치를 어느 쪽으로 움직일지가 출력 오차와 뉴런 종류만으로 정해진다는 설명입니다. 지금 말로 하면 데일 원칙 위에서 오차를 방송하듯 뿌리는 학습 규칙입니다.
이 방법은 제가 처음 생각해 낸 것입니다. 지금은 이 홈페이지에서만 정보를 내고 있습니다.— 가네코 이사무, 1999년 개인 홈페이지
실험도 함께 올렸습니다. 손글씨 숫자 1,000자를 배운 뒤 다른 1,000자를 판별해, 은닉 뉴런을 늘렸을 때 약 93%를 맞혔습니다. 가네코는 이 방법이 문자 인식에는 약하지만 논리 학습에는 뛰어나니 강화학습으로 행동을 배우는 데 잘 맞을 것이라고 적었습니다. 투고한 논문이 뇌의 학습 이론인지 공학 이론인지 모호하다는 심사 의견을 받았고, 자기는 뇌 쪽을 밀겠다는 경과도 남겼습니다.
이 학습법은 오랫동안 일본어 자료로만 남아 있었습니다. 2025년 4월 후지타 가즈히사가 현대식 수식과 구현으로 다시 정리해 arXiv에 올렸는데, 원래 방식은 출력이 하나뿐이라 부류가 여럿이면 부류마다 신경망을 따로 둬야 했고 모든 시험에서 역전파보다 낮은 점수를 냈습니다. 후지타가 이미지를 한 줄로 펴서 넣는 단순 다층 퍼셉트론으로 CIFAR-10에서 얻은 값은 약 55.2%였습니다.
사카나 논문의 저자는 야마다 유타로, 루카 그리요티, 루지콘 차라콘, 세바스티안 리시, 데이비드 하, 로버트 랑에 여섯 명으로 모두 사카나 AI 소속이고, 논문은 6월 30일 arXiv에 먼저 올라왔습니다. 사카나는 데이비드 하와 트랜스포머 논문 공저자 리온 존스가 도쿄에 세운 연구소로, 모델을 키우는 경쟁과 거리를 두고 자연을 흉내 낸 방법을 파고들어 왔습니다. 이들은 가네코의 구조를 그대로 가져왔습니다. 층마다 뉴런을 흥분 흐름과 억제 흐름 두 무리로 나누고, 앞 층의 두 무리와 다음 층의 두 무리를 잇는 가중치 행렬 네 개를 모두 0 이상의 값으로만 둡니다. 억제로 작용하는 연결에는 처음부터 빼기 부호를 박아 두기 때문에, 어떤 연결이 누르는 쪽인지는 학습으로 정해지지 않고 뉴런이 어느 무리에 속하느냐로 정해집니다.
이 논문이 새로 더한 것은 모듈로 라우팅입니다. 은닉 뉴런 i번은 출력 부류 수 C로 나눈 나머지, 곧 i mod C번째 출력의 오차만 학습 신호로 받습니다. 출력이 하나뿐이던 원래 방식을 신경망 하나로 여러 부류를 맞히는 문제로 넓힌 장치입니다. 무작위 행렬에 기대는 DFA와 달리 뉴런과 출력의 짝이 처음부터 정해져 있습니다. 대가도 있습니다. 행렬이 네 벌이라 같은 폭의 신경망보다 파라미터가 약 4배 많아서, 같은 구조에서 DFA가 약 800만 개를 쓸 때 이 방식은 약 3,200만 개를 씁니다.
이미지 분류에는 보조 장치 세 가지를 더 붙였습니다. 층마다 시그모이드 곡선의 폭을 달리 줬고(층별 시그모이드 폭), 한 배치 안에서 부류마다 오차의 평균을 빼 줬고(배치 중심 오차), 흥분 가중치는 1.5배, 억제 가중치는 0.5배로 시작해 흥분과 억제를 3 대 1로 기울여 놓았습니다(비대칭 초기화). 시그모이드의 기울기가 오차 신호를 직접 거르기 때문에 출력층에서 첫 은닉층까지 신호가 25배 약해졌고, 폭을 넓힌 것은 이 감쇠를 막으려는 조치였습니다.
첫 시험은 이미지 분류입니다. MNIST는 0부터 9까지 손글씨 숫자 흑백 사진을 맞히는 과제이고, CIFAR-10은 비행기·자동차·새·고양이 같은 10개 부류의 작은 컬러 사진을 가르는 과제입니다. 오차 확산을 합성곱 신경망에 적용한 것은 이번이 처음입니다. 판마다 250에포크씩, 시드 다섯 개로 돌렸습니다.
| 판 | MNIST | CIFAR-10 |
|---|---|---|
| 오차 확산 (데일 원칙, 보조 장치 3개) | 96.7% | 61.7% |
| 직접 피드백 정렬 (데일 원칙 안 지킴) | 97.6% | 69.1% |
| 보조 장치 없는 오차 확산 | 50.4% | 11.6% |
DFA는 두 과제 모두 더 높았지만 음수 가중치를 약 284만 개 씁니다. 두 방식의 차이는 손글씨에서 0.9%포인트, 사진에서 7.4%포인트였습니다. 저자들은 이 차이를 음수 가중치를 쓰지 않는 대가로 봤고, 과제가 어려워지자 그 대가가 8배 넘게 커졌습니다. 약 62%라는 CIFAR-10 정확도가 기존 경사 기반 방법과 겨룰 수준과는 아직 거리가 멀다는 점도 저자들이 직접 적었습니다.
논문에서 저자들이 가장 공들여 설명한 것은 보조 장치를 하나씩 빼 보는 절제 실험입니다. 어느 장치가 성능을 떠받치는지가 과제에 따라 거꾸로 나왔습니다.
| 뺀 장치 | MNIST | CIFAR-10 |
|---|---|---|
| 층별 시그모이드 폭 | −71.4%p (25.3%) | −15.1%p (46.6%) |
| 배치 중심 오차 | −0.3%p (96.4%) | −47.9%p (13.8%) |
| 비대칭 초기화 | 0.0%p (96.7%) | −5.5%p (56.2%) |
손글씨에서는 시그모이드 폭을 빼자 정확도가 25.3%로 무너져 찍기에 가까운 수준이 됐고, 배치 중심 오차는 빼도 0.3%포인트만 움직였습니다. 사진에서는 반대로 배치 중심 오차를 빼자 13.8%로 떨어지며 시드 다섯 개 가운데 네 개가 무너졌습니다. 부류마다 정답인지 아닌지를 따로 가리는 방식에서는 사진 한 장마다 정답 부류 하나와 오답 부류 아홉 개가 오차를 내는데, 부류끼리 닮은 사진일수록 이 9 대 1 불균형이 출력을 한쪽으로 눌러 버린다는 것이 저자들의 설명입니다. 저자들은 이 결과를 근거로, 생물학적 학습 규칙을 벤치마크 하나로만 평가하면 어떤 설계가 중요한지 잘못 판단할 수 있다고 적었습니다.
두 번째 시험은 강화학습입니다. 저자들은 널리 쓰이는 강화학습법 PPO의 경사 계산을 오차 확산으로 바꿔 ED-PPO를 만들었습니다. 구글의 물리 시뮬레이터 Brax에서 네 발 로봇(Ant), 치타 모양 로봇(HalfCheetah), 사람 모양 로봇(Humanoid)을 달리게 하고, 채집하고 만들고 싸우며 살아남는 게임 Craftax도 시켰습니다. 강화학습에서는 분류용 보조 장치 세 가지를 쓰지 않았습니다.
@SakanaAILabsX 게시물 · 원문 보기
| 과제 | ED-PPO (데일 원칙) | 역전파 PPO | 비고 |
|---|---|---|---|
| HalfCheetah | 5494 ± 691 | 3520 ± 485 | 역전파보다 높음(p<0.001), DFA-PPO 5581 ± 359와 비슷 |
| Ant | 6891 ± 835 | 6740 ± 1781 | 비슷 |
| Humanoid | 6670 ± 2592 | 8478 ± 3252 | 뒤처짐 |
| Craftax | 20.9 ± 2.9 | 27.0 | 뒤처짐, DFA-PPO 19.8 ± 1.5 |
점수는 시드 다섯 개 평균이고 ± 뒤는 표준편차입니다. 치타에서는 역전파보다 1,974점 높았지만, 네 과제 가운데 통계적으로 역전파를 앞선 것은 치타 하나였습니다. 같은 오차 확산에서 부호 제약만 푼 판은 Craftax에서 23.0점을 냈고, DFA-PPO는 이 판보다 유의하게 낮았습니다. 데일 원칙을 지킨 ED-PPO와 DFA-PPO의 차이는 1.1점이었습니다.

가네코가 1999년에 적은 강화학습 전망에 대한 답은 과제마다 달랐습니다. 걷기와 달리기 같은 연속 제어에서는 역전파와 겨뤘지만, 긴 시간에 걸쳐 판단을 쌓아야 하는 Craftax에서는 역전파에 6.1점 뒤졌습니다. 저자들은 오차를 뭉뚱그려 나눠 주는 방식이 세밀한 시간 단위 판단에는 부족할 수 있다고 적었습니다. 한계 절에는 ED-PPO의 결과가 모든 환경에서 역전파보다 크게 흔들린다는 문장도 있지만, 본문 표의 시드 간 표준편차만 보면 Ant와 Humanoid에서는 역전파 쪽이 더 컸습니다.
학습 방향이 얼마나 정확한지도 따로 쟀습니다. Ant, Humanoid, HalfCheetah 학습 중에 오차 확산이 고르는 수정 방향과 역전파가 계산한 방향의 유사도를 비교했더니, 시험한 오차 분배 방식 가운데 모듈로 라우팅이 역전파 방향과 가장 가깝게 맞았습니다.
학습을 마친 신경망에서는 뇌와 닮은 현상이 저절로 나타났습니다. CIFAR-10 모델을 흥분 3, 억제 1의 비율로 시작했는데, 250에포크 뒤 은닉층의 흥분 대 억제 가중치 비율은 1에 가깝게 모였습니다. 첫 번째 층은 1.03, 두 번째 층은 0.90, 세 번째 층은 0.81로 깊은 층일수록 억제가 강해졌습니다. 저자들은 대뇌 피질이 성숙하며 흥분과 억제의 균형을 맞춰 가는 과정과 느슨하게 닮았다고 보면서도, 가중치 비율은 세포 수와 발화율을 함께 따지는 생물의 균형을 간접적으로만 대신한다는 단서를 달았습니다.
음수로 내려가지 못하는 제약은 가지치기 효과도 냈습니다. 학습이 끝나자 가중치의 37.3%가 하한값(0.0001)에 붙어 사실상 끊겼고, 억제 쪽 완전 연결층은 최대 68.8%, 흥분 쪽은 26~49%가 하한에 붙었습니다. 저자들은 이 때문에 실제로 쓰이는 용량이 명목상 파라미터 수보다 훨씬 작아졌을 수 있다고 봤습니다. 학습 데이터와 시험 데이터의 정확도 차이가 0.98%에 그친 것도 과적합보다 용량 부족에 가깝다는 해석입니다.
저자들은 향후 과제의 첫 번째로 하드웨어를 꼽았습니다. 아날로그 회로나 빛으로 계산하는 칩, 시냅스 소자로 만든 뉴로모픽 칩은 물리 소자가 원래 음수가 아닌 양을 담는 경우가 많습니다. 데일 원칙을 지키는 신경망은 가중치가 모두 0 이상이고 부호는 뉴런 무리의 소속으로 정해지니, 이런 소자와 잘 맞을 수 있다는 설명입니다.
다만 저자들은 뺄셈이나 차동 회로를 통째로 없앨 수 있다고 쓰지 않았습니다. 음의 기여는 여전히 필요하고, 달라지는 것은 부호를 가중치마다 따로 두는 대신 뉴런 무리와 고정된 연결 구조가 정한다는 점이라고 적었습니다. 가중치의 37.3%가 저절로 끊기는 성질은 추론 때 희소 연산으로 모델을 공짜로 압축하는 데 쓸 수 있다고 봤고, 억제 흐름이 큰 가중치 변화를 누그러뜨려 여러 과제를 이어 배울 때 앞서 배운 것을 덜 잊을 수 있다는 추측도 덧붙였습니다.
저는 이 방향이 칩과 전력 문제까지 건드린다고 봅니다. 다만 그 전망을 가를 칩 위 전력 측정은 이 논문에 아직 없고, 저자들도 이 응용을 향후 과제로 적었습니다.
논문 감사의 글에는 원고 편집과 코드 생성에 더해 아이디어를 내고 실험을 자율로 돌리는 데에도 AI를 썼다는 문장이 있습니다. 27년 전 한 프로그래머가 개인 홈페이지에 올린 규칙이, AI에게 실험 일부를 맡기는 도쿄 연구소의 손을 거쳐 합성곱 신경망과 강화학습으로 옮겨졌습니다.
그 결과 뇌의 규칙을 지키는 값이 과제별 숫자로 남았습니다. DFA 대비 손글씨에서 0.9%포인트, 사진에서 7.4%포인트 뒤졌고, 역전파 PPO 대비 Craftax에서 6.1점 뒤졌으며, 치타에서는 1,974점 앞섰습니다. 저자들은 다음 과제로 더 정교한 오차 분배, 고정 대신 학습하는 출력·은닉 연결, 시그모이드의 장점을 살리면서 감쇠를 줄이는 활성화 함수를 들었습니다. 뇌를 닮은 학습이 더 나은 칩과 평생 배우는 AI로 가는 길일지, 흥미로운 우회로에 그칠지는 아직 열려 있습니다.
읽어 주셔서 고맙습니다.
초이 드림


