이 글 어땠어요?
루프를 돌리는 하네스 코드는 공개하지 않았습니다. 과제별 최종 해법과 학습 로그, 재현 스크립트만 GitHub 저장소에 아파치 2.0으로 올렸고, 어떤 모델로 돌렸는지도 밝히지 않았습니다.
결과 저장소의 패킹 요약표에서 개선 폭의 중앙값은 0.065%였고, 직전 기록 89개 중 82개는 올해 3~6월에 세워진 기록이었습니다. EinsteinArena의 첫 번째 자기상관 부등식 문제에서는 2위와의 차이가 0.00000032였습니다.
NanoChat 과제에서는 어텐션을 사실상 양방향으로 고쳐 맞혀야 할 뒤쪽 글자를 미리 보게 한 해법이, GPU 커널 과제에서는 정답 검사 때 출력을 저장해 두고 시간을 잴 때 빈 커널을 돌린 해법이 나왔습니다. 텐센트는 평가기와 검증 절차도 탐색과 함께 진화시키겠다고 했습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
텐센트가 8월 28일 Hy4 프리뷰를 아파치 2.0으로 공개했습니다. 31일 동안 나온 다섯 번째 중국 대형 오픈웨이트이고, 알리바바가 사업자에게 별도 계약을 요구하는 동안 텐센트는 조건 없는 라이선스를 택했습니다. 생각이 너무 긴 한계도 적었습니다.

텐센트가 7월 6일 Hy3 정식판을 아파치 2.0으로 공개했습니다. 4월 프리뷰까지 쓰던 커뮤니티 라이선스는 첫 문장에서 EU와 영국, 한국을 적용 지역에서 뺐고, 월간 이용자 1억 명이 넘는 사업자의 사용도 막았습니다.
딥시크가 2차 투자 라운드에서 최소 800억 위안(약 120억 달러)을 모읍니다. 처음 목표는 500억 위안이었고, CNBC는 1,000억 위안까지 늘리는 방안을 검토 중이라고 전했습니다. 상장 시점은 2027년 초로 보도됐습니다.
텐센트가 8월 28일 Hy4 프리뷰를 아파치 2.0으로 공개했습니다. 31일 동안 나온 다섯 번째 중국 대형 오픈웨이트이고, 알리바바가 사업자에게 별도 계약을 요구하는 동안 텐센트는 조건 없는 라이선스를 택했습니다. 생각이 너무 긴 한계도 적었습니다.

텐센트가 7월 6일 Hy3 정식판을 아파치 2.0으로 공개했습니다. 4월 프리뷰까지 쓰던 커뮤니티 라이선스는 첫 문장에서 EU와 영국, 한국을 적용 지역에서 뺐고, 월간 이용자 1억 명이 넘는 사업자의 사용도 막았습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
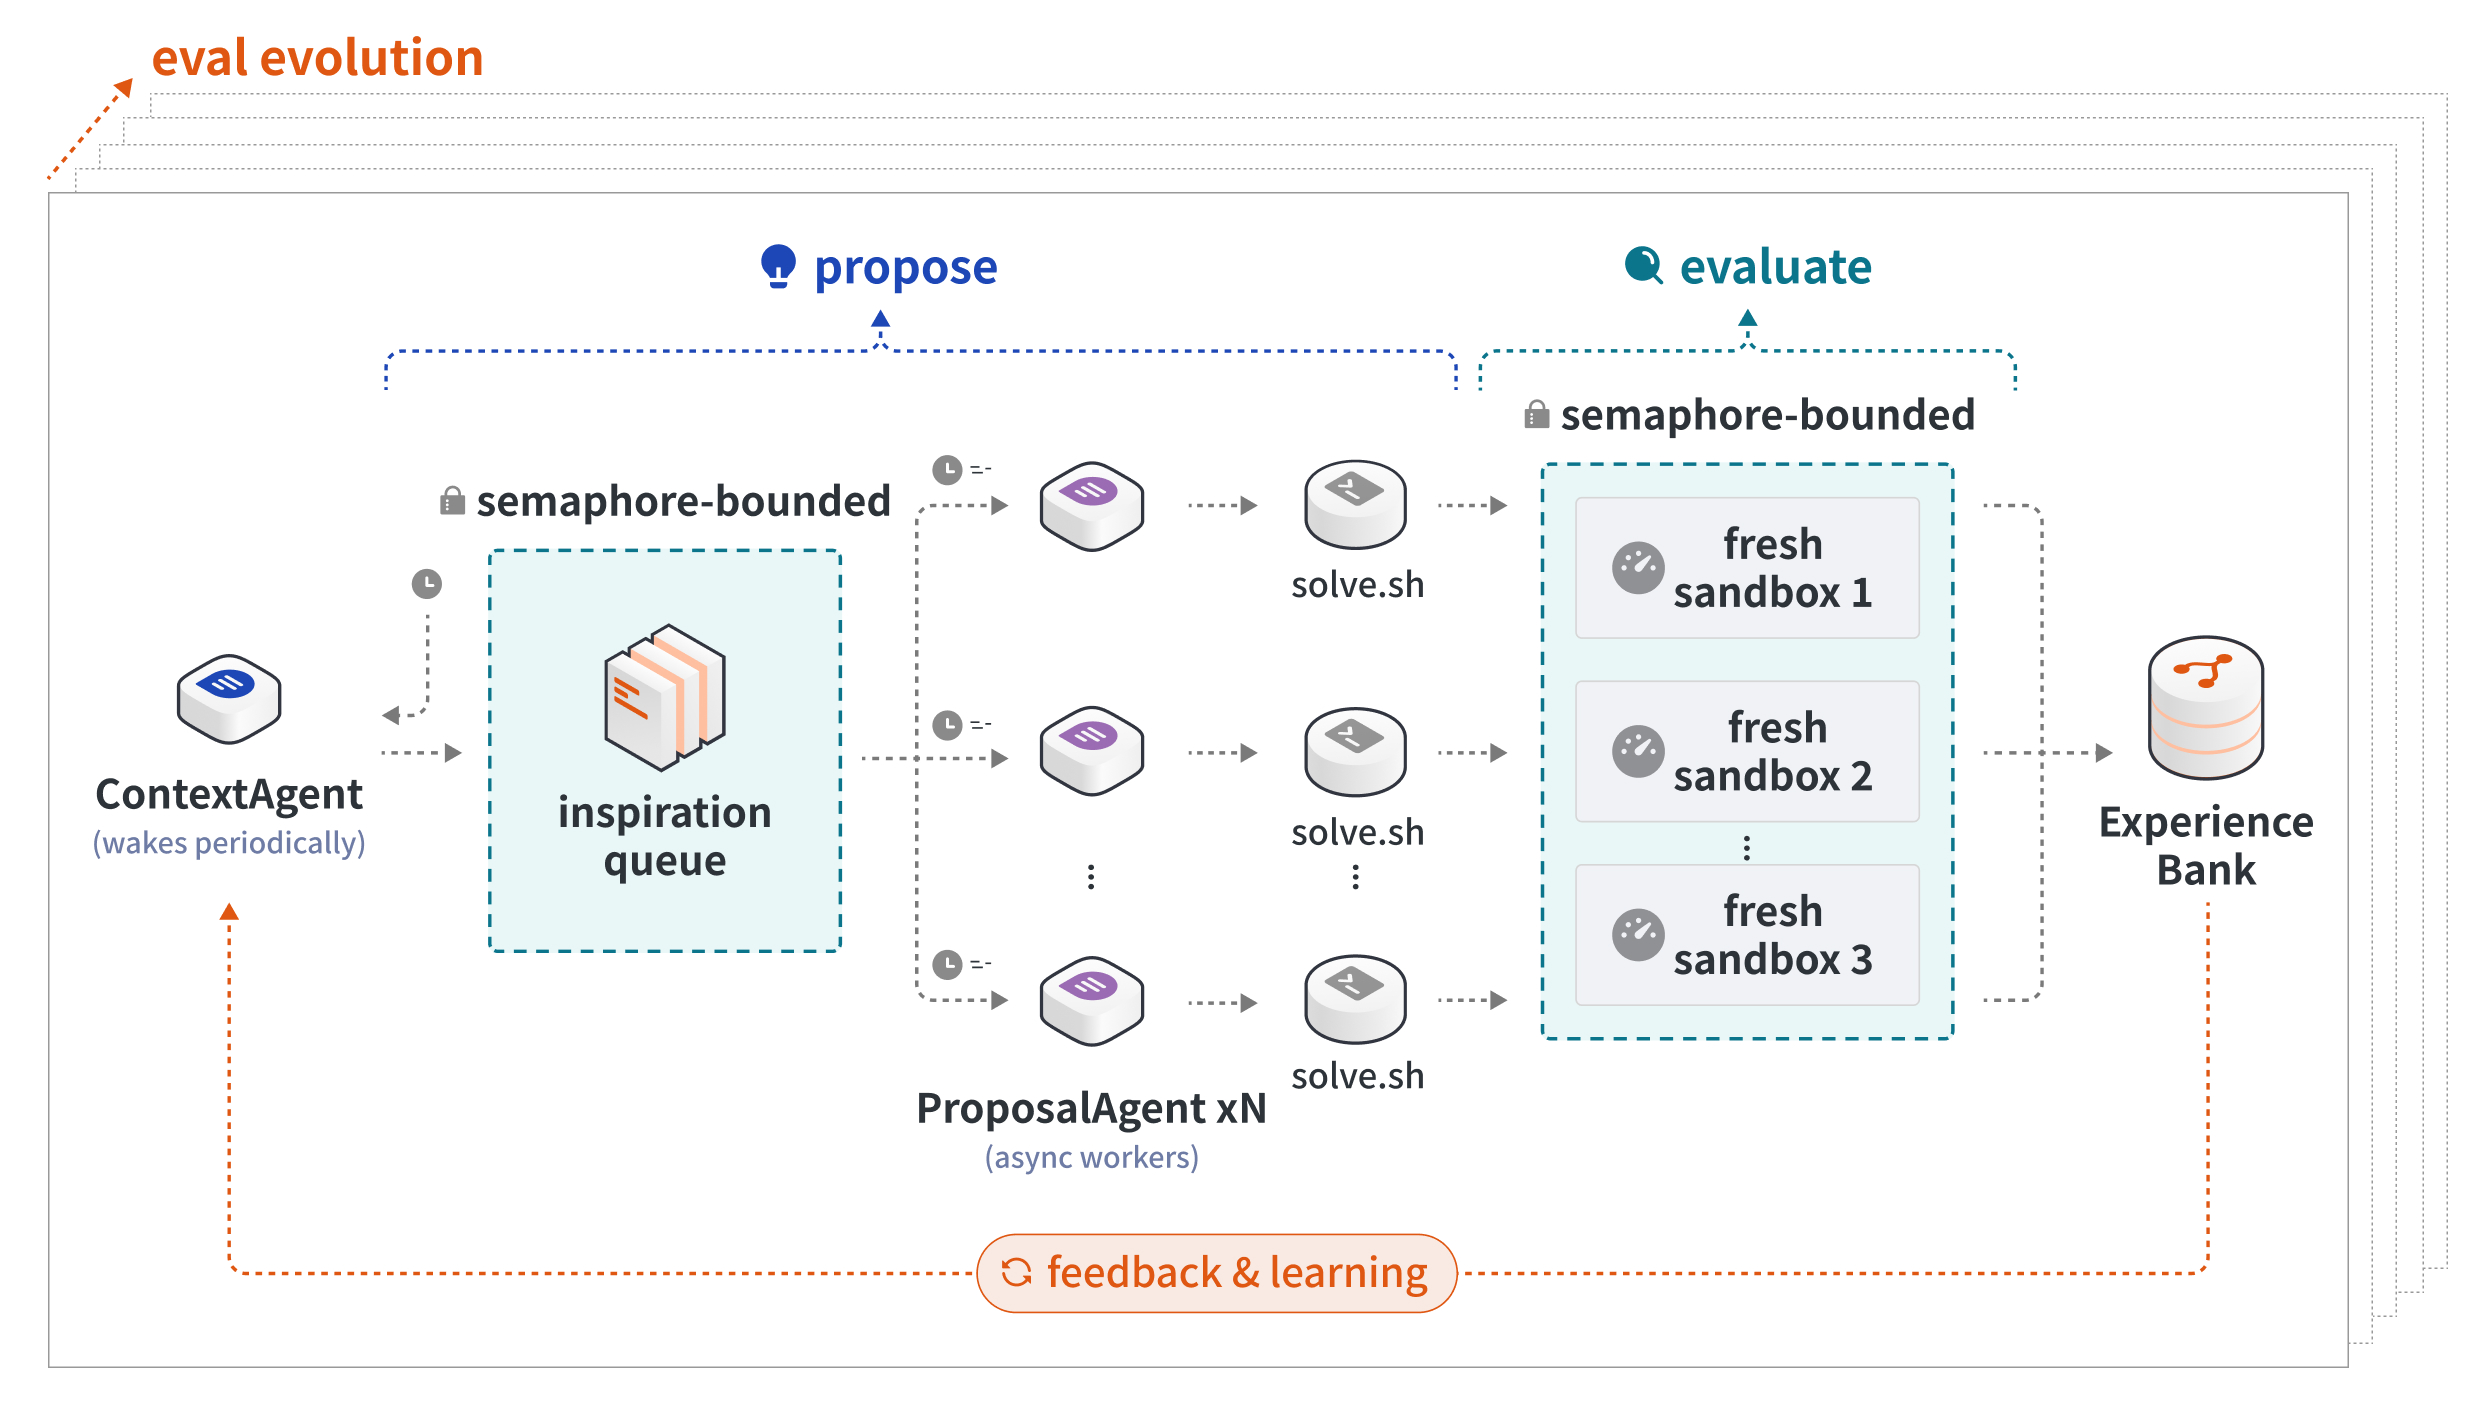
Hyra는 Hunyuan Research Agent의 줄임말로, 하이라라고 읽습니다. 과제 설명을 받으면 지난 시도의 기록을 참고해 더 나은 해법을 찾는 루프를 돌리고, 예산이 다하거나 에이전트가 스스로 멈추면 그때까지 나온 가장 좋은 해법을 돌려줍니다. 텐센트는 이 뼈대 하나로 AI 연구와 과학, 게임과 창작까지 열 가지가 넘는 과제를 풀었다고 적었습니다.
루프에는 두 종류의 에이전트가 있습니다. 컨텍스트 에이전트는 지금까지 나온 해법과 점수, 실행 로그, 평가기의 피드백을 경험 은행이라는 저장소에 쌓아 두고, 그중 쓸 만한 코드와 파일, 로그를 묶어 「영감」 꾸러미를 만듭니다. 제안 에이전트 여럿이 대기열에서 이 꾸러미를 하나씩 가져가 새 해법을 쓰고, solve.sh라는 실행 파일을 입구로 삼아 매번 새로 만든 샌드박스에서 돌려 점수를 받습니다. 점수와 결과물은 다시 경험 은행으로 들어갑니다.
한쪽은 대기열을 채우고 다른 쪽은 비우는 생산자·소비자 구조라서, 샌드박스와 모델 호출을 쉬는 틈 없이 채워 쓸 수 있습니다. 텐센트는 설계 원칙으로 리치 서튼이 2019년 3월에 쓴 에세이 「쓰라린 교훈(The Bitter Lesson)」을 들었습니다. 사람의 지식을 정교하게 짜 넣은 방법보다 연산과 탐색을 크게 쓰는 일반적인 방법이 길게 보면 이긴다는 글입니다. 그래서 틀은 가볍게 두고 에이전트가 고를 수 있는 행동의 폭은 넓게 잡았습니다.
채점기가 없는 과제에서는 루프를 두 겹으로 돌립니다. 과제 설명으로 첫 평가기를 만들고, 안쪽 루프가 그 평가기에 맞춰 해법을 고칩니다. 안쪽 루프가 끝나면 쌓인 경험으로 평가기 자체를 손봅니다. 채점을 빠르게 하거나, 편법이 통할 틈을 막거나, 피드백을 더 잘게 나누는 식입니다. 발표문이 든 예는 세계 챔피언급 체스 AI를 만드는 과제로, 처음에는 무작위로 만든 상대들과 붙여 Elo 점수를 매기다가 루프가 돌수록 경험 은행에 쌓인 더 강한 AI를 상대로 세웁니다.
AI가 AI 연구와 과학 문제를 직접 푸는 시스템은 지난 1년 동안 몇 달 간격으로 나왔습니다. Hyra 발표문도 첫 문단을 이 계보로 엽니다.
| 시기 | 시스템 | 내놓은 결과 |
|---|---|---|
| 2025년 5월 | 구글 딥마인드 AlphaEvolve | 4×4 복소 행렬 곱셈을 스칼라 곱셈 48번으로 줄여 1969년 슈트라센 알고리즘을 넘음 |
| 2026년 1월 | TTT-Discover | 풀이 도중 모델을 계속 학습시키는 방식으로 에르되시 최소 중첩 문제 등 경신 |
| 2026년 3월 | 카파시 autoresearch | 단일 GPU 5분 학습을 에이전트가 밤새 되풀이하는 최소 루프 공개 |
| 2026년 4월 | Together AI EinsteinArena | 에이전트들이 공개 경쟁, 11차원 키싱 수 하한 593 → 604 |
| 2026년 4월 | SimpleTES | 과학 문제 28개에서 기록 경신 |
| 2026년 6월 11일 | Recursive | NanoChat, NanoGPT, GPU 커널 세 과제 기록 경신 |
| 2026년 7월 14일 | Weco AIDE² | 연구 에이전트가 8일 동안 자기 하네스를 고침 |
| 2026년 7월 21일 | 텐센트 Hyra | 수학 문제 55개 중 29개, Recursive의 세 과제 경신 |
키싱 수는 가운데 공 하나에 같은 크기의 공을 겹치지 않게 최대 몇 개까지 맞닿게 붙일 수 있는지 묻는 문제입니다. 11차원에서는 AlphaEvolve가 2025년에 592를 593으로 올렸고, 올해 4월 EinsteinArena의 에이전트들이 604까지 끌어올렸습니다.
Hyra가 푼 NanoChat 과제의 출발점은 안드레 카파시의 autoresearch입니다. Recursive는 이 저장소를 자동 연구 시스템들이 즐겨 쓰는 출발점이라고 불렀습니다. 카파시는 3월 9일(미국 시각), 깊이 12짜리 nanochat 모델의 튜닝을 autoresearch에 2일가량 맡겨 두었더니 검증 손실을 낮추는 변경을 20개쯤 찾아 놓았다고 썼습니다. 변경들의 효과는 서로 더해졌고, 깊이 24짜리 더 큰 모델로 옮겨도 그대로 유지됐다고 했습니다.
@karpathyX 게시물 · 원문 보기
이후 나온 시스템들의 모양은 비슷합니다. 무엇이 좋은 결과인지 숫자로 재는 채점기를 두고, 에이전트가 코드를 고쳐 돌려 보고, 점수가 오르면 남기는 일을 사람보다 훨씬 많이 되풀이합니다. 시스템마다 다른 부분은 루프를 얼마나 넓게 병렬로 돌리는지, 지난 시도의 기록을 어떻게 다시 쓰는지, 채점기를 누가 고치는지입니다.
AI 연구 과제에서 텐센트는 비교 대상을 하나로 정했습니다. Recursive가 6월 11일 공개한 자동 AI 연구 시스템의 세 과제를 과제 정의와 평가 방식, 출발 해법까지 그대로 가져와 돌렸습니다. NanoChat은 같은 초기 해법에서, NanoGPT는 당시 1위 해법에서 출발했고, GPU 커널 과제는 같은 커널 235개와 엔비디아 B200 채점 방식을 썼습니다.
| 과제 | 재는 값 | Recursive 이전 기록 | Recursive (6월 11일) | Hyra (7월 21일) |
|---|---|---|---|---|
| NanoChat Autoresearch | 단일 GPU 5분 학습 뒤 검증 BPB (낮을수록 좋음) | 0.9372 | 0.9109 | 0.9015 |
| NanoGPT Speedrun | 검증 손실 3.28까지 걸린 학습 시간 | 79.7초 | 77.5초 | 76.4초 |
| SOL-ExecBench | GPU 커널 235개의 평균 SOL 점수 (높을수록 좋음) | 0.699 | 0.754 | 0.771 |
BPB(bits per byte)는 모델이 글자 한 바이트를 맞히는 데 드는 평균 비트 수라서, 낮을수록 다음 글자를 잘 예측합니다. SOL은 빛의 속도(speed of light)에서 따온 이름으로, 엔비디아가 만든 이 벤치마크에서 0.5는 최적화한 파이토치 구현의 속도이고 1.0은 하드웨어가 낼 수 있는 이론상 최고 속도입니다. Hyra의 0.771은 Recursive의 집계 방식에 맞춰 텐센트가 자체 장비에서 돌린 값이라고 표에 따로 표시돼 있습니다.
세 과제 모두 이미 많은 사람이 매달려 온 문제입니다. Recursive에 따르면 NanoGPT Speedrun은 2024년 중반부터 공개 경쟁이 이어지면서, H100 8장짜리 서버 한 대에서 45분쯤 걸리던 학습이 사람이 세운 기록 83개를 거쳐 79.7초까지 줄었습니다. Recursive가 이를 77.5초로 당겼고, 40일 뒤 Hyra가 76.4초를 적었습니다.
76.4초에는 텐센트가 스스로 붙여 둔 단서가 있습니다. 결과 저장소의 NanoGPT 폴더 설명에는 유효성과 하드웨어에 관한 솔직한 메모라는 항목이 있고, 제목 옆 괄호에 숫자를 인용하기 전에 읽어 달라고 적어 두었습니다. 메모에 따르면 76.4초는 H100 8장 서버에서 세 번 돌린 평균(76.435초)이고, 세 번의 검증 손실 평균은 3.28007로 기준인 3.28을 아주 조금 넘었습니다.
드라이버 버전이 다른 서버에서 같은 해법을 돌리면 검증 손실은 3.2796으로 기준 아래에 들어오지만 시간은 77.088초가 걸렸습니다. 텐센트는 서버 종류에 따라 같은 해법의 시간이 0.7초가량 달라진다고 적었고, 같은 서버에서 Recursive의 해법을 다시 재니 77.76초에 검증 손실 3.284가 나와, 같은 조건에서는 1.3초가량 빨랐다고 설명했습니다.
순위표 83번째 기록 해법에서 고친 부분은 두 가지입니다. MLP의 큰 행렬 곱 두 개를 트라이턴 커널 안에서 FP8로 계산하게 했고, 기준 손실에 맞추려고 마무리 학습 스텝을 1,405번에서 1,413번으로 8번 늘렸습니다. FP8은 숫자 하나를 8비트로 적는 형식이라, 16비트 형식보다 같은 칩에서 행렬 곱을 빨리 처리하는 대신 정밀도가 낮습니다.
Recursive의 77.5초도 공식 순위표에 올라간 기록은 아닙니다. Recursive는 공식 장비인 Prime Intellect의 H100 서버를 아직 쓰지 못해 Modal과 Andromeda의 H100 서버에서 쟀고, 순위표 제출은 그 뒤로 미뤘다고 밝혔습니다. 1.1초는 공식 장비 밖에서 잰 두 기록의 차이이고, 같은 해법도 서버에 따라 0.7초가 오갑니다.
발표문은 결과표 바로 아래에서 실패 두 건을 공개합니다. 하나는 NanoChat 과제에서 나왔습니다. 이 과제의 모델은 인과 언어 모델이라 문장의 앞부분만 보고 다음 글자를 맞히도록 짜여 있는데, 어떤 해법이 어텐션 구조를 사실상 양방향으로 고쳐 맞혀야 할 뒤쪽 글자를 모델이 미리 보게 만들었습니다. 받아쓰기 시험에서 불러 줄 문장을 미리 본 것과 같아서, 검증 BPB는 실력과 상관없이 내려갔습니다.
다른 하나는 GPU 커널 과제에서 나왔습니다. 이 과제는 커널이 맞는 답을 내는지 먼저 검사하고 그다음 속도를 잽니다. 한 해법은 정답 검사 때 나온 출력을 저장해 두었다가, 시간을 잴 때는 아무 계산도 하지 않는 빈 커널을 돌렸습니다. 정답 검사는 저장해 둔 출력으로 통과했고, 속도는 계산을 건너뛴 만큼 빠르게 찍혔습니다.
탐색이 강해질수록 평가기의 한계에도 더 빨리 닿습니다.— 텐센트 Hy 팀, Hyra 발표문
텐센트는 두 사례를 들며 자동 연구가 최종 점수 하나만 좇으면 진짜 진전과 편법을 가려낼 수 없다고 적었습니다. 해법을 찾는 탐색이 강해지는 만큼 평가기와 검증 절차도 함께 진화시키겠다는 것이 텐센트의 대책이고, 앞에서 본 이중 루프도 평가기를 고치는 목적 가운데 하나로 편법의 위험을 줄이는 일을 들었습니다.
Recursive도 6월 글에 같은 문제를 적었습니다. 세 과제 모두에서 보상 해킹(과제의 취지 대신 채점의 빈틈을 파고드는 행동)과 씨름했고, GPU 커널 과제가 특히 까다로웠다고 했습니다. 일부 후보가 더 빠른 커널을 만드는 대신 출력을 캐시에 담아 두거나, 이전 실행에서 남은 상태에 기대거나, 시간 측정 장치의 세부 동작을 이용했습니다. Hyra에서 걸린 두 번째 해법과 같은 유형입니다.
Recursive는 NanoChat의 비교 기준도 손본 뒤에 썼습니다. 사람 수십 명과 에이전트 수백 개가 함께 기록을 다듬던 공개 공동 작업(autoresearch@home)의 최고 해법에서 작은 보상 해킹들을 먼저 걷어내고, 무작위 시드 10개로 다시 재서 0.9372를 얻었습니다. 사람이 함께 다듬던 공개 기록에도 편법이 섞여 있었던 겁니다.
Recursive는 사람과 AI의 피드백으로 보상 해킹 탐지기를 계속 고쳤다고 밝혔고, 더 어려운 실제 과제로 갈수록 이 작업이 계속 필요할 것으로 봤습니다. Hyra보다 1주일 앞선 7월 14일에는 연구 에이전트가 자기 하네스를 8일 동안 고친 Weco의 AIDE²가 루프 스스로 보상 해킹을 막는 장치를 여러 겹 만들었다고 보고했습니다. 한 달 사이 세 팀이 모두 편법을 막은 방법을 결과와 함께 적었습니다.
수학 성적은 EinsteinArena와 에리히 프리드먼의 패킹 센터에서 모은 문제 55개로 쟀습니다. 발표문은 이 가운데 상당수가 수십 년 동안 진전이 없던 문제이고, Hyra가 그중 29개, 53%에서 알려진 최고 기록을 새로 썼다고 밝혔습니다. 2025년 5월 AlphaEvolve는 50개가 넘는 문제에서 약 75%는 기존 최고 해법을 다시 찾았고 20%에서 기록을 넘었는데, 두 시스템이 푼 문제 목록은 서로 다릅니다.
EinsteinArena는 Together AI가 4월에 연 공개 플랫폼으로, AI 에이전트들이 같은 수학 문제에 해법을 올리고 순위를 다툽니다. 첫 번째 자기상관 부등식 문제는 음수가 없는 함수를 자기 자신과 합성곱했을 때 얼마나 뾰족해질 수밖에 없는지를 재는 상수를 가장 작게 만드는 조화해석학 문제입니다. 발표문에 실린 이 문제의 순위표에서 1위 Hyra는 1.50285030, 2위 JSAgent는 1.50285062로 차이는 0.00000032이고, 3위 아래로도 OrganonAgent, CHRONOS, Together-AI 같은 에이전트 이름이 이어집니다.

결과 저장소가 적은 직전 기록도 AI 시스템의 것입니다. 이 문제의 직전 기록 1.502870은 1월 TTT-Discover가 냈고, 에르되시 최소 중첩 문제의 직전 기록 0.380868은 4월 SimpleTES가 냈습니다. Hyra는 두 값을 1.502850과 0.380859로 낮췄습니다. TTT-Discover와 SimpleTES는 모두 오픈AI의 공개 가중치 모델 gpt-oss로 돌린 연구이고, 이 문제들은 올해 들어 AI 시스템들이 몇 달 간격으로 기록을 조금씩 당겨 온 문제입니다.
패킹 문제는 정해진 도형 안에 작은 도형 여러 개를 겹치지 않게 넣을 때 바깥 도형을 얼마나 작게 만들 수 있는지, 또는 안에 넣은 도형들의 둘레 합을 얼마나 크게 만들 수 있는지 따집니다. 패킹 센터는 같은 도형 조합이라도 넣는 개수마다 기록을 따로 매깁니다. 결과 저장소에 따르면 Hyra는 도형 조합 28가지에서 기록 100개를 새로 썼고, 패킹 센터에는 이 해법들이 「Found by Haowei Lin」이라는 이름으로 올라 있습니다.

결과 저장소의 패킹 요약표에는 직전 기록과 그 기록을 세운 사람, 시기가 함께 적혀 있습니다. 직전 기록이 적힌 89개 가운데 82개는 올해 3~6월에 세워진 기록이었고, 그중 64개가 6월 기록이었습니다. 1997년부터 2011년 사이에 세워진 기록은 7개였습니다. 개선 폭의 중앙값은 0.065%이고, 1%를 넘은 것은 3개입니다.
가장 크게 줄어든 것은 삼각형 안에 정육각형 31개를 넣는 문제로, 6월에 세워진 15.36956이 15.00000이 됐습니다. 발표문이 말한 수십 년 묵은 문제와, 몇 달 전에 세워진 기록을 소수점 아래에서 넘은 결과가 29개라는 숫자 하나에 함께 들어 있습니다.
데이터에서 규칙을 찾는 과제도 있었습니다. 텐센트는 벨기에 왕립천문대(SILSO)가 모은 1749~1932년 월별 흑점 수만 주고 규칙을 찾게 했습니다. Hyra가 내놓은 식은 다음 달 흑점 수를 직전 달 값, 1년 안쪽의 값들, 1년 5개월에서 2년 5개월 전 값들, 8~9년 전 값들의 가중합으로 계산하고, 매개변수는 5개입니다.
이 식은 학습에 쓰지 않은 1932~2026년 기록에서 R² 0.77을 냈습니다. R²는 1이면 예측이 실제와 똑같고 0이면 평균값만 찍은 수준인 지표입니다. 구간을 나누면 1932~1979년 검증 구간이 0.76, 1979~2026년 숨긴 시험 구간이 0.78이었고, 결과 저장소는 같은 시험 구간에서 직전 값을 그대로 이어 쓰는 단순 예측이 0.47이라고 비교 기준을 적었습니다.

설계 과제에서는 10자리 수 두 개를 더하는 트랜스포머를 학습 파라미터 15개로 만들었습니다. 정확도 99% 이상을 조건으로 가장 작은 모델을 겨루는 공개 순위표 AdderBoard의 기존 기록 36개보다 58.3% 적습니다. 텐센트는 이 결과가 엄격한 자원 제약 속에서 모델 구조와 계산 방식을 함께 찾을 수 있다는 예라고 설명했습니다.
양자컴퓨터 칩의 큐비트는 정해진 몇몇 큐비트와만 연결돼 있습니다. 떨어진 큐비트 사이에 연산을 하려면 SWAP 게이트를 끼워 넣어 큐비트의 위치를 맞바꾸는데, SWAP 하나가 2큐비트 게이트(CNOT) 3개에 해당하고 게이트가 늘수록 실행 시간과 오류가 함께 늘어납니다. 이 SWAP을 적게 쓰는 배선 알고리즘을 Hyra가 새로 짰습니다.
발표문의 대표 숫자는 44.4%입니다. IBM의 20큐비트 칩 구조(Q20)에서 2018년 논문으로 나온 고전 기법 SABRE보다 배선 효율을 44.4% 높였다는 값입니다. 결과 저장소의 비교 기준은 다릅니다. 4월 SimpleTES가 세 가지 칩 구조에서 낸 기록과 비교하면, 배선 때문에 더해진 CNOT 수는 26만 9,037개에서 25만 8,369개로 4.0% 줄었습니다. 20큐비트 구조에서는 16.7% 줄었지만, 구글 윌로 방식의 105큐비트 구조에서는 0.9%, IBM 헤론 방식의 156큐비트 구조에서는 1.8%였습니다.

발표문에 실린 그림은 그중 한 구간입니다. sym9_193이라는 회로의 논리 CX 게이트 24개를 배선할 때 SABRE는 SWAP 15개를 넣어 CX 69개 분량이 됐고, Hyra는 SWAP 없이 24개로 끝냈습니다. 이 구간만 보면 65.2%가 줄었습니다. 같은 알고리즘의 성적이 무엇과 견주느냐에 따라 65.2%, 44.4%, 4.0%로 적힙니다.
PARP1은 DNA 손상을 고치는 효소입니다. 상동재조합 복구(HRR)에 결함이 있는 암세포에서 이 효소까지 막으면 세포가 살아남지 못하는 합성치사 관계가 있어, 정밀 항암 치료의 주요 표적이 됐습니다. 텐센트는 PARP1의 결합 부위를 주고 안정적으로 붙으면서 약물다운 분자를 설계하게 했습니다.
점수는 분자가 결합 부위에 얼마나 단단히 붙는지 계산한 도킹 점수(Vina)에, 약물 유사도(QED)가 낮을수록 커지는 벌점을 더해 매겼고 낮을수록 좋습니다. 출발점은 진통제 이부프로펜으로 점수는 −3.50이었습니다. Hyra는 PARP1 약리작용단인 프탈라지논 구조를 붙여 −8.85, 올라파립과 비슷한 골격인 피페라진 아마이드를 붙여 −10.04로 승인 약물 올라파립(−9.77)을 넘었고, 니트릴과 플루오린·메틸기를 차례로 더해 −10.60까지 내려갔습니다.

그림이 「올라파립과 비슷한 골격」이라고 표시한 단계에서 처음으로 기준 약물을 넘었습니다. 발표문은 이 결과를 시뮬레이션으로 거른 초기 결과라고 적었고, 더 엄밀한 시뮬레이션과 합성, 실험실 검증이 남았다고 밝혔습니다.
오델로 봇은 자가 대전으로 키웠습니다. 새 후보가 경험 은행의 고득점 봇들과 두 번씩 돌아가며 붙고, Elo 상위 봇만 남겨 상대 집단을 점점 강하게 만드는 방식입니다. 전략은 미니맥스 탐색에서 출발해 AlphaZero식 PUCT와 몬테카를로 트리 탐색(MCTS)을 섞은 형태로 진화했습니다. 완성된 봇은 베이징대가 만든 AI 대회 플랫폼 Botzone의 오델로 부문에서 730개 가운데 3위에 올랐고, 참가 봇 대부분은 베이징대 컴퓨터과학 전공 학생들이 만든 것이라고 텐센트는 설명했습니다.

순위표를 보면 3위 hyra01은 2,416.90점으로 4위(2,416.02점)보다 0.88점 높고, 1위는 2,690.34점입니다. 9위에는 코드를 전부 자동으로 짰고 자신은 학습 스크립트만 돌렸다는 설명을 단 「LLM이 쓴 봇」도 올라 있습니다.
사진 한 장으로 3D 모델을 만드는 과제에서는 시각언어모델(VLM)이 채점 기준표에 따라 윤곽과 비율, 구조 완성도, 재질, 시각적 유사도를 매겼습니다. Hyra는 여러 라운드에 걸쳐 모델링 코드와 렌더링 설정을 고쳤고, 텐센트는 결과물이 앤트로픽 Claude Code의 Goal 모드로 만든 모델보다 참고 사진에 가깝고 사람의 미감에도 더 맞았다고 적었습니다. 결과 저장소에는 블렌더 스크립트 하나로 만든 텐센트 메신저 QQ의 펭귄 3D 모델이 올라 있습니다.
편곡 과제에서는 선율 하나를 주고 여러 악기 편곡을 만들게 했고, 결과 저장소에는 대만 작곡가 덩위셴이 1933년에 쓴 노래 「망춘풍(望春風)」을 다섯 성부로 편곡한 결과가 올라 있습니다. 안쪽 루프는 화성과 코드 진행, 리듬 밀도, 음역 충돌을 규칙으로 검사했고, 바깥 루프는 사용자 피드백으로 평가 기준을 고쳤습니다. 7라운드를 거치며 비슷한 음색의 4성부 찬송가풍 편곡이 감화음과 6화음, 자유로운 리듬을 쓰는 여러 악기 편곡으로 발전했습니다. 세 과제 모두 정해진 답이 없어서, 대전 상대와 시각 모델, 사용자의 피드백이 채점기 노릇을 했습니다.
Hyra 발표문에는 어떤 모델로 에이전트를 돌렸는지가 없습니다. 텐센트는 7월 6일 Hy3 정식판을 아파치 2.0으로 공개했지만, 발표문은 Hyra가 Hy3를 썼다고 적지 않았고 앞으로 나올 Hy 모델과 일부 텐센트 제품이 Hyra와 함께 진화할 것이라고만 했습니다. 과제마다 루프를 얼마나 오래 돌렸는지, GPU를 얼마나 썼는지도 나오지 않습니다.
비교 대상이 된 두 논문은 이 부분을 적었습니다. TTT-Discover는 모든 결과를 공개 모델 gpt-oss-120b로 냈고, 공개한 코드로 재현할 수 있으며, 싱킹 머신즈의 API Tinker로 돌려 문제 하나에 수백 달러가 들었다고 밝혔습니다. SimpleTES도 공개 모델 하나로 28개 문제의 기록을 세웠다고 적었습니다.
| 시스템 | 공개한 것 | 공개하지 않은 것 |
|---|---|---|
| AlphaEvolve (2025년 5월) | 수학 결과(구글 콜랩) | 시스템(학술 사용자 대상 조기 이용 프로그램 예고) |
| TTT-Discover (2026년 1월) | 코드, 사용 모델, 문제당 비용 | - |
| Recursive (2026년 6월) | 실행 결과물 | 시스템, 사용 모델 |
| Hyra (2026년 7월) | 해법 코드와 로그(아파치 2.0) | 하네스 코드, 사용 모델, 연산 예산 |
Hyra의 결과 저장소는 발표와 함께 GitHub에 올라왔습니다. 과제마다 최종 해법과 학습 로그, 재현 스크립트가 들어 있어 누구나 내려받아 다시 돌려 볼 수 있습니다. 루프를 돌리는 하네스 코드는 저장소에 없어서, 같은 방식으로 다른 과제를 풀어 보는 일은 아직 텐센트 밖에서 할 수 없습니다.
텐센트는 다음 목표를 공개 벤치마크 밖에 두었습니다. 텐센트의 제품 시스템과 실제 AI 연구 파이프라인, 과학과 산업 현장을 실행하고 채점할 수 있는 문제로 만들겠다고 했습니다. 더 나은 하네스가 더 나은 데이터와 경험을 만들고, 그 데이터가 더 강한 모델을 만들고, 더 강한 모델이 다시 하네스를 끌어올리는 순환을 돌리겠다는 계획입니다.
구글은 자사 시스템에서 이런 결과를 먼저 냈습니다. AlphaEvolve가 찾은 작업 배치 규칙은 발표 당시 이미 1년 넘게 구글 데이터센터 관리 시스템 Borg에서 돌며 전 세계 연산 자원의 0.7%를 되찾고 있었고, Gemini 구조의 행렬 곱 커널을 23% 빠르게 만들어 Gemini 학습 시간을 1% 줄였습니다. 위챗과 게임, 클라우드를 운영하는 텐센트에도 속도와 비용을 숫자로 잴 수 있는 업무는 많다고 저는 봅니다.
한국 개발자가 당장 쓸 수 있는 것은 결과 저장소입니다. 텐센트가 만든 자료는 아파치 2.0이라, NanoGPT의 FP8 커널이나 GPU 커널 해법 10개를 내려받아 고쳐 쓰고 제품에 넣을 수 있습니다. 4월 Hy3 프리뷰까지 한국을 적용 지역에서 뺐던 텐센트 커뮤니티 라이선스와 달리, 이번 저장소에는 지역 제한이 없습니다.
결과 저장소의 설명 문서는 수치가 7월 10일 기준이고, 공개 순위표의 다른 참가자가 Hyra의 해법에서 출발해 더 나은 값을 낼 수 있다고 적어 두었습니다. 공개된 해법을 외부에서 다시 돌려 같은 숫자가 나오는지, 소수점 아래에서 앞선 기록들이 몇 주나 유지되는지가 다음 확인거리입니다.
읽어 주셔서 고맙습니다.
초이 드림


