이 글 어땠어요?
런웨이는 지금 Noble Machines, Standard Bots, Ultra 같은 초기 파트너와 시험 중이고, 가중치는 몇 달 안에 공개하겠다고 밝혔습니다. 출시 전에 써 보려는 회사는 런웨이 로보틱스 팀에 접근을 신청할 수 있고, 라이선스와 가격은 나오지 않았습니다.
런웨이가 2월 27일 낸 평가 연구에서 나온 숫자입니다. 로봇 정책 8개를 월드 모델 안에서 돌린 성공률과 실제 로봇 성공률 사이의 상관계수이고, Praxis-1의 성공률은 공개되지 않았습니다.
사전학습 영상을 10시간에서 1,000시간까지 늘려 가며 파인튜닝 뒤 물체를 내려놓은 위치의 오차를 잰 실험입니다. 1,000시간에서 웹 영상은 16.1cm, 원격 조종 로봇 영상은 16.0cm였고, 런웨이는 오차 막대보다 작은 차이는 유의하지 않다고 적었습니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
미스트랄이 10월 6일 1조 파라미터 Mistral Large 4 프리뷰를 공개했습니다. 아티피셜애널리시스 지수 38점으로 중국 밖 오픈 모델 1위이고, 사이버 방어를 앞세워 가중치는 레드팀 시험 뒤 10월 말 풉니다.
리플렉션 AI가 10월 5일(미국 시각) 첫 모델 Beam을 공개했습니다. GLM-5.2급 추론 점수를 3~4배 적은 연산으로 냈다고 밝혔지만, 자사 비교표에서도 GLM-5.3과 DeepSeek V4.1-Flash가 더 높습니다.
AMD가 9월 28일(미국 시각) 페이페이 리의 월드 모델 회사 월드랩스를 약 82억 달러에 사기로 했습니다. 대금은 전액 주식이고, 2월 10억 달러 라운드에는 엔비디아도 투자했으며, 거래는 규제 승인을 거쳐 연말 마무리가 목표입니다.
미스트랄이 10월 6일 1조 파라미터 Mistral Large 4 프리뷰를 공개했습니다. 아티피셜애널리시스 지수 38점으로 중국 밖 오픈 모델 1위이고, 사이버 방어를 앞세워 가중치는 레드팀 시험 뒤 10월 말 풉니다.

리플렉션 AI가 10월 5일(미국 시각) 첫 모델 Beam을 공개했습니다. GLM-5.2급 추론 점수를 3~4배 적은 연산으로 냈다고 밝혔지만, 자사 비교표에서도 GLM-5.3과 DeepSeek V4.1-Flash가 더 높습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@runwaymlX 게시물 · 원문 보기
런웨이 공식 계정이 한국 시각 10월 1일 오전 3시 6분에 올린 발표 글입니다. 로봇 시연 데이터는 한정돼 있지만 영상 데이터는 무한하다는 두 문장으로 문제를 세우고, 가장 좋은 정책 모델은 영상에서 배우게 된다는 회사의 내기를 Praxis-1이 잇는다고 적었습니다. 함께 올린 2분 가까운 영상은 2023년 런웨이가 내놓은 영상 모델 Gen-1에서 이야기를 시작해, 영상 생성 모델을 만들며 배운 것을 이제 물리 지능과 로봇에 쓰겠다는 내레이션으로 이어집니다. 저는 같은 날 저녁 스레드에서 이 발표를 런웨이가 영상 생성 AI에서 로봇으로 넘어가는 일로 소개했습니다.
지금까지 로봇 학습 데이터는 한 시간 한 시간을 직접 벌어야 했습니다. 어딘가에서 누군가가 과제 하나를 몇 번이고 되풀이해 보여 줘야 했습니다.— 런웨이, Praxis-1 발표 영상 내레이션
로봇의 정책(policy)은 카메라 화면과 관절 상태를 받아 다음 동작을 고르는 모델입니다. 컵을 알아보는 데서 끝나지 않고 팔을 어디로 뻗고 언제 집게를 오므릴지까지 정해야 하므로, 학습 자료에는 화면과 함께 그때 로봇이 실제로 한 동작 값이 붙어 있어야 합니다. 이런 자료는 대개 사람이 로봇을 원격으로 조종하며 하나씩 시연해서 모읍니다.
그 비용은 공개된 데이터셋의 크기로 가늠할 수 있습니다. 2024년 3월 공개된 DROID는 데이터 수집자 50명이 북미·아시아·유럽에서 12개월 동안 장소 564곳, 과제 84가지를 시연해 모은 자료인데, 다 합쳐 궤적 7만 6,000개, 약 350시간입니다. 2023년 10월에는 21개 기관이 로봇 22종의 자료를 모아 Open X-Embodiment를 냈고, 이 논문은 그때까지 로봇 학습이 응용마다, 로봇마다, 심지어 환경마다 모델을 따로 훈련해 왔다고 적었습니다.
구글 연구진은 10년 전인 2016년 로봇 팔 6~14대를 두 달 동안 돌려 물건 집기 시도 80만 번을 모았고, 그 자료로 카메라 화면만 보고 집게를 움직이는 신경망을 학습시켰습니다. 로봇 데이터를 늘리는 길은 그때나 지금이나 로봇을 더 많이, 더 오래 돌리는 것이었습니다.
Praxis-1 발표문은 사람들이 날마다 찍어 올리는 일상 영상이 어떤 로봇 연구실이 원격 조종 시연으로 모을 수 있는 양보다 많고, 생성 모델이 화질과 속도에서 실제 영상을 따라잡으면서 영상은 사실상 끝없이 늘어난다고 적었습니다. 영상에는 로봇의 관절 값이 없지만, 물체가 닿았을 때 어떻게 움직이는지, 과제가 절반쯤 진행되면 어떤 모습인지는 담겨 있습니다. 런웨이는 영상으로 물리적 그럴듯함과 물체의 움직임을 먼저 익힌 정책이 동작 데이터로만 배운 정책보다 크게 앞서 출발한다고 적고, 언어 모델이 구할 수 있는 글로 세상의 구조를 배운 것과 같은 전제라고 설명했습니다.
발표 영상의 내레이션은 여기서 더 나가, 월드 액션 모델을 쓰면 사람이 과제를 하는 모든 영상이 시연 자료가 되고 비교적 적은 양의 1인칭 영상과 로봇 데이터만으로 그 이해를 제어로 바꿀 수 있다고 말합니다. 런웨이는 월드 액션 모델의 구조를 따로 설명하지 않았는데, 일주일 앞서 같은 이름의 모델을 낸 블랙 포레스트 랩스(BFL)는 이 말을 앞으로의 화면과 동작을 함께 예측하는 모델로 풀었습니다.
발표문에 실린 숫자 실험은 하나로, 런웨이는 사전학습 영상을 10시간, 100시간, 1,000시간으로 달리해 모델을 처음부터 사전학습하고 파인튜닝한 뒤 로봇이 물체를 마지막에 내려놓은 위치가 목표에서 얼마나 벗어났는지를 쟀습니다. 한쪽은 웹에서 모은 영상, 다른 쪽은 사람이 원격 조종한 로봇 영상이었습니다.
그래프의 두 결과는 10시간 지점에서 오차 18cm대로 출발해 1,000시간 지점에서 웹 영상 16.1cm, 로봇 영상 16.0cm로 끝납니다. 오차 막대는 평가 쌍 93개에 대한 표준오차(±1 SEM)이고, 런웨이는 막대보다 작은 차이는 유의하지 않다고 적었습니다. 0.1cm 차이는 막대 길이보다 훨씬 작고, 회사는 이 그림에 「웹 영상이 원격 조종 로봇 영상과 맞먹는다」는 제목을 붙였습니다.
| 사전학습 영상 | 1,000시간 학습 뒤 놓은 위치 오차 | 모으는 방법 |
|---|---|---|
| 웹 영상 | 16.1cm | 인터넷에 올라온 영상 |
| 원격 조종 로봇 영상 | 16.0cm | 사람이 로봇을 조종하며 시연 |
결과가 이대로 맞는다면 로봇 회사의 데이터 셈법이 크게 달라집니다. 1,000시간은 DROID 전체의 3배 가까운 분량인데, 원격 조종 장비와 사람 없이 웹에서 구한 영상으로 로봇 영상과 같은 효과를 냈다는 주장이기 때문입니다. 런웨이는 3인칭 시점 영상을 늘릴수록 정책 성능이 좋아졌다는 관찰을 근거로, 쓸 만한 정책을 막는 병목이 이제 모델이 학습할 수 있는 일반 영상의 양이라고 적었습니다.
다만 이 그림에는 빠진 정보가 많습니다. 어떤 로봇으로 어떤 과제를 했는지, 평가 쌍 93개가 무엇끼리 짝지은 것인지, 실험한 모델이 Praxis-1 자체인지가 발표문에 없습니다. 영상을 100배 늘리는 동안 줄어든 오차는 2cm 남짓으로, 그래프에 그린 오차 막대 하나와 비슷한 크기입니다.
발표문에서 가장 크게 내세운 0.95는 런웨이가 2월 27일 낸 정책 평가 연구에서 나왔습니다. 런웨이 로보틱스 팀 4명은 Gen-4.5 영상 모델의 변형인 GWM-Robotics 안에서 로봇 정책 8개를 돌리고, 실제 로봇에서 나온 결과와 견줬습니다. 정책은 모두 시각·언어·행동 모델(VLA, 화면과 지시문을 받아 동작을 내는 모델)로, 여러 대학이 같은 로봇 구성으로 정책들을 나란히 시험해 온 벤치마크 RoboArena에서 가져왔고 과제는 프랑카 판다 로봇 팔로 탁자 위 물건을 다루는 일이었습니다.
월드 모델이 만든 화면을 보고 정책이 동작을 고르면, 월드 모델이 그 동작의 결과로 다음 화면을 만드는 식입니다. 이렇게 만든 실행 영상 1,450개를 사람 평가자들이 보고 과제가 얼마나 진행됐는지 점수를 매겼는데, 영상 하나에 10명 안팎이 붙어 점수가 1만 6,000개를 넘었습니다.
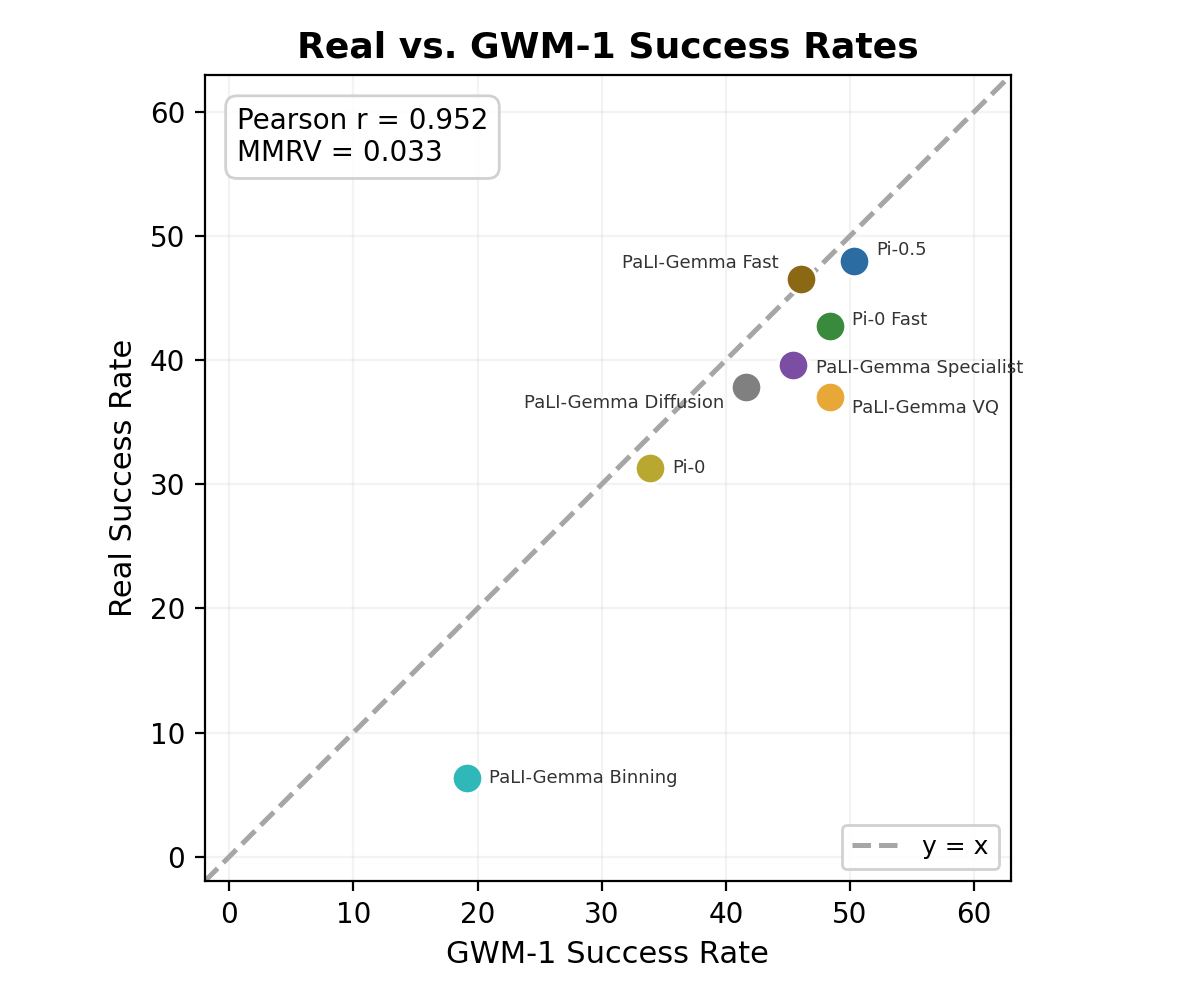
결과는 피어슨 상관계수 0.95, 정책 두 개씩 짝지어 순위가 얼마나 뒤집혔는지 재는 MMRV(평균 최대 순위 위반) 0.033이었습니다. 실제로 가장 잘한 정책인 π0.5(피지컬 인텔리전스가 공개한 모델의 DROID 판)와 가장 못한 PaLI-Gemma Binning은 시뮬레이션에서도 맨 위와 맨 아래였습니다. 비교 대상으로 든 PolaRiS는 실제 장소를 스캔해 3D 가우시안 스플래팅으로 재구성하는 방식인데, 두 방법이 함께 평가한 정책만 놓고 보면 GWM-Robotics 0.986, PolaRiS 0.98이었습니다. 정확도는 비슷했고, 스캔과 재구성 없이 시작 이미지만 있으면 된다는 점이 달랐습니다.
그래프에서 여덟 정책 가운데 일곱은 실제 성공률 30%대 초반에서 40%대 후반 사이에 모여 있고, PaLI-Gemma Binning 하나만 실제 6%대, 시뮬레이션 19%대로 멀리 떨어져 있습니다. 상관계수는 이렇게 홀로 떨어진 점 하나에 크게 끌려갑니다. 모여 있는 일곱 정책 사이에서는 순위가 흔들려, 시뮬레이션에서 Pi-0 Fast와 나란히 2위권이던 PaLI-Gemma VQ가 실제 성공률로는 여섯 번째였습니다. 런웨이도 나머지 여섯 정책 사이에 성능이 비슷한 모델끼리 작은 순위 역전이 있었다고 적었습니다.
연구진이 직접 적은 한계에 따르면 이 연구는 정책들의 상대 순위가 실제와 같은지를 본 것이고, 실제 성공률을 정확히 맞히는 보정은 아직 풀고 있는 과제이며, 범위도 로봇 팔 한 종류의 탁상 조작에 그칩니다. 그래서 0.95가 쓸모 있는 곳은 후보 정책 여럿 가운데 실제 장비에 먼저 올릴 것을 고르는 일입니다. Praxis-1이 실제로 몇 번 중 몇 번 과제를 끝내는지는 이 숫자로 알 수 없습니다.
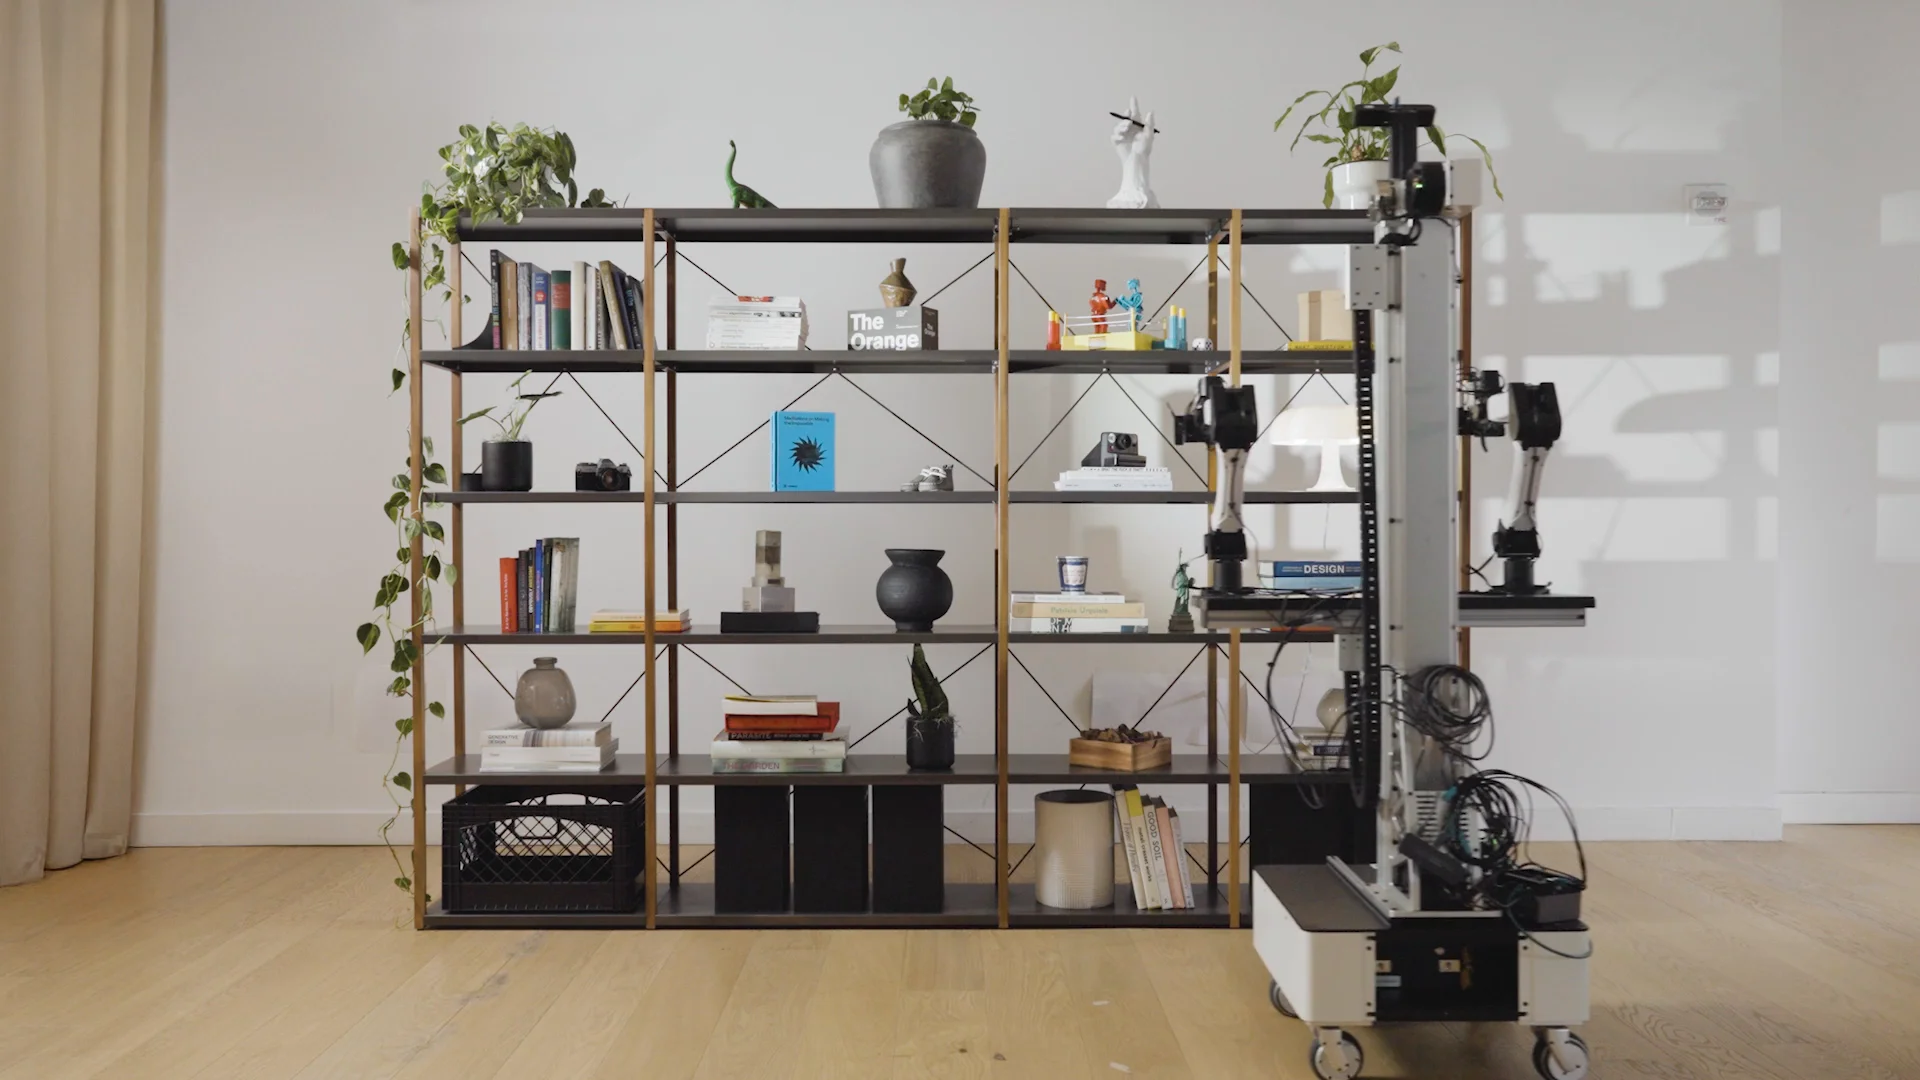
발표문의 나머지를 채운 시연 영상 가운데 그림 1에서는 바퀴 달린 양팔 로봇이 책장으로 다가가 책을 살피고 꺼내 치우는 과정을 4단계로 나눠 보여 주고, 그림 4에서는 조명과 장비가 고정된 스튜디오에서 쓰던 정책을 재학습 없이 조명이 섞인 가정 부엌 조리대로 옮겼습니다. 이 두 그림의 영상은 실제 속도로 붙었습니다.
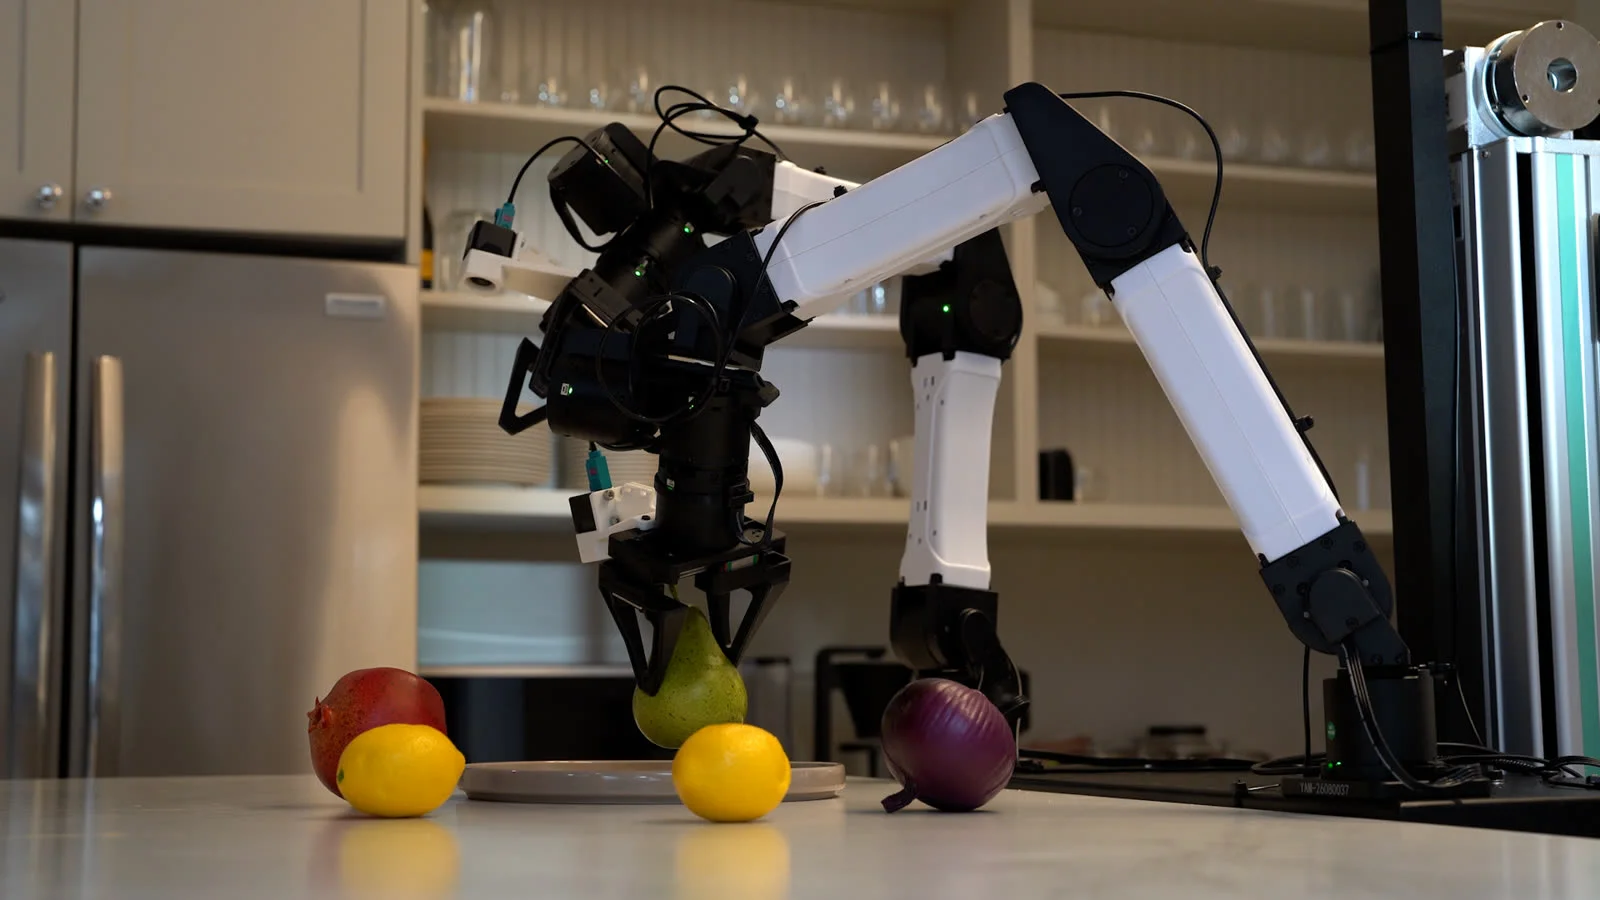
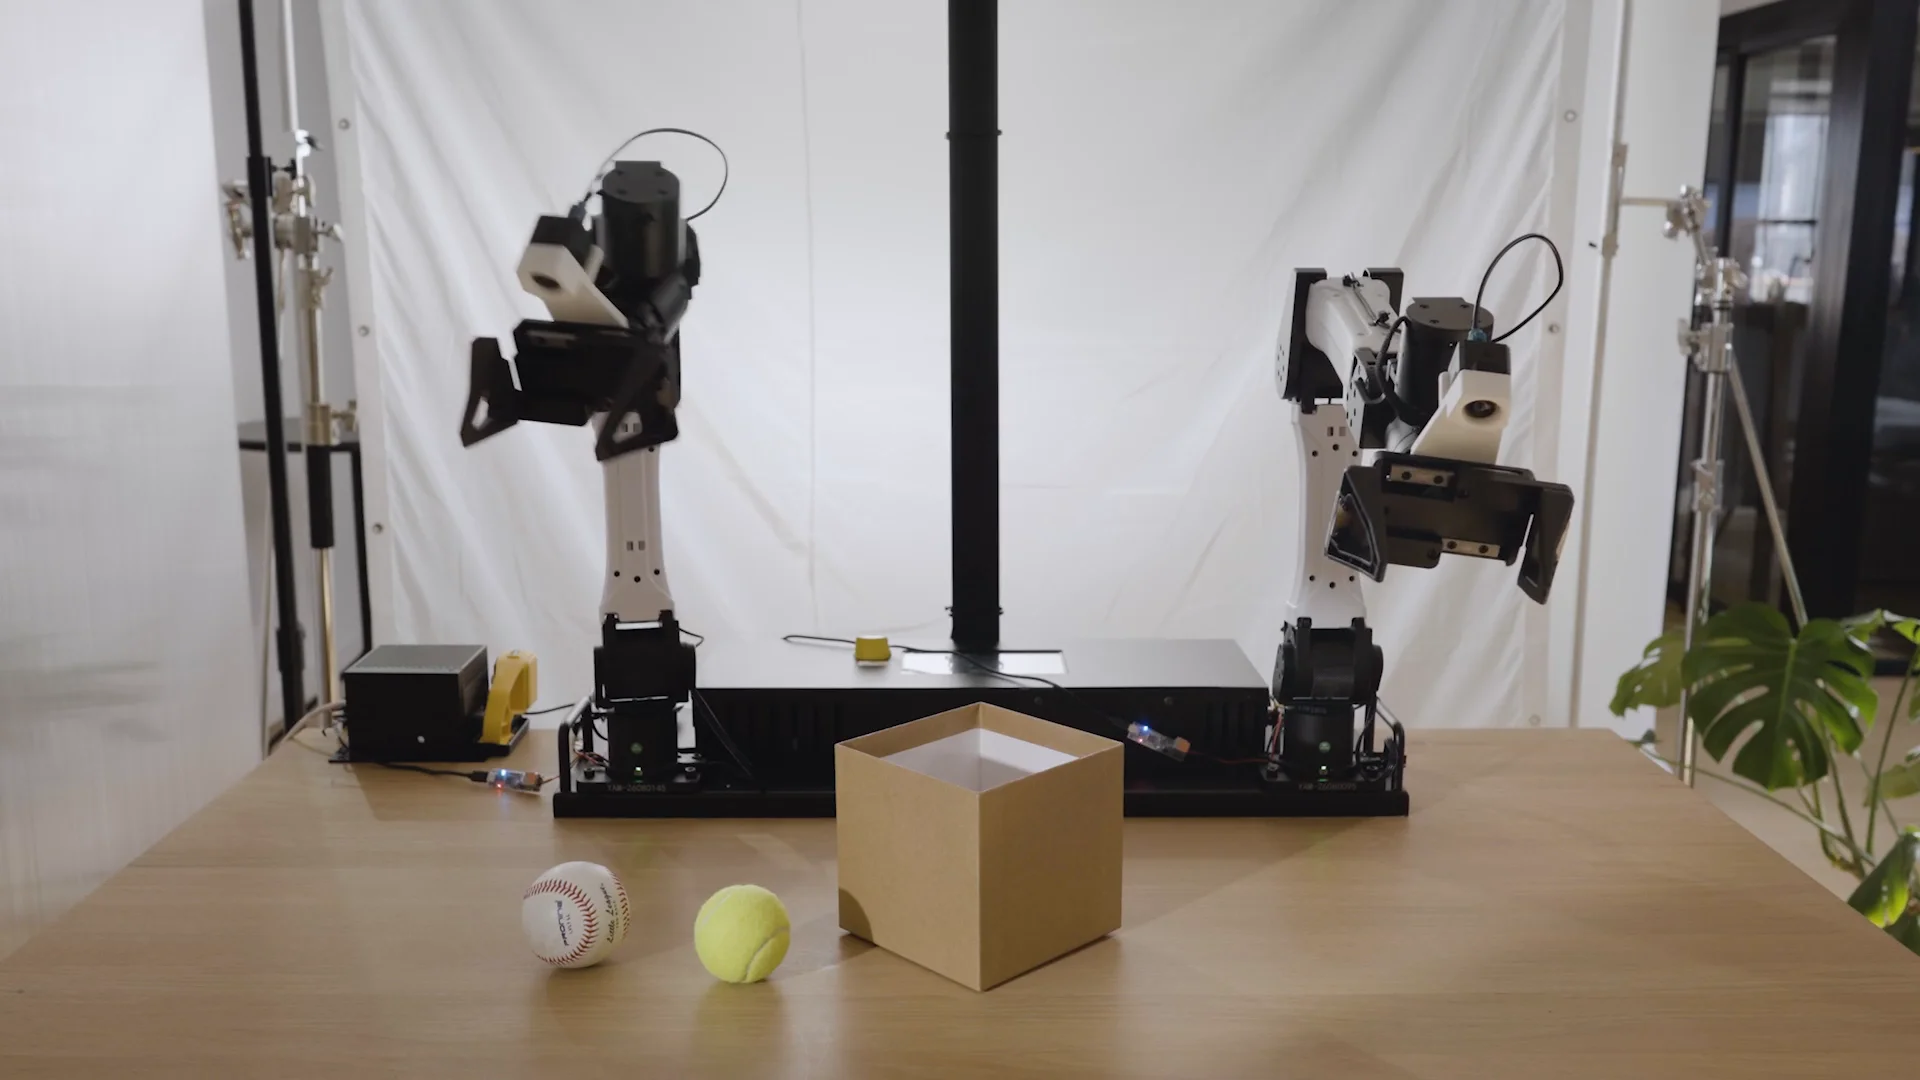
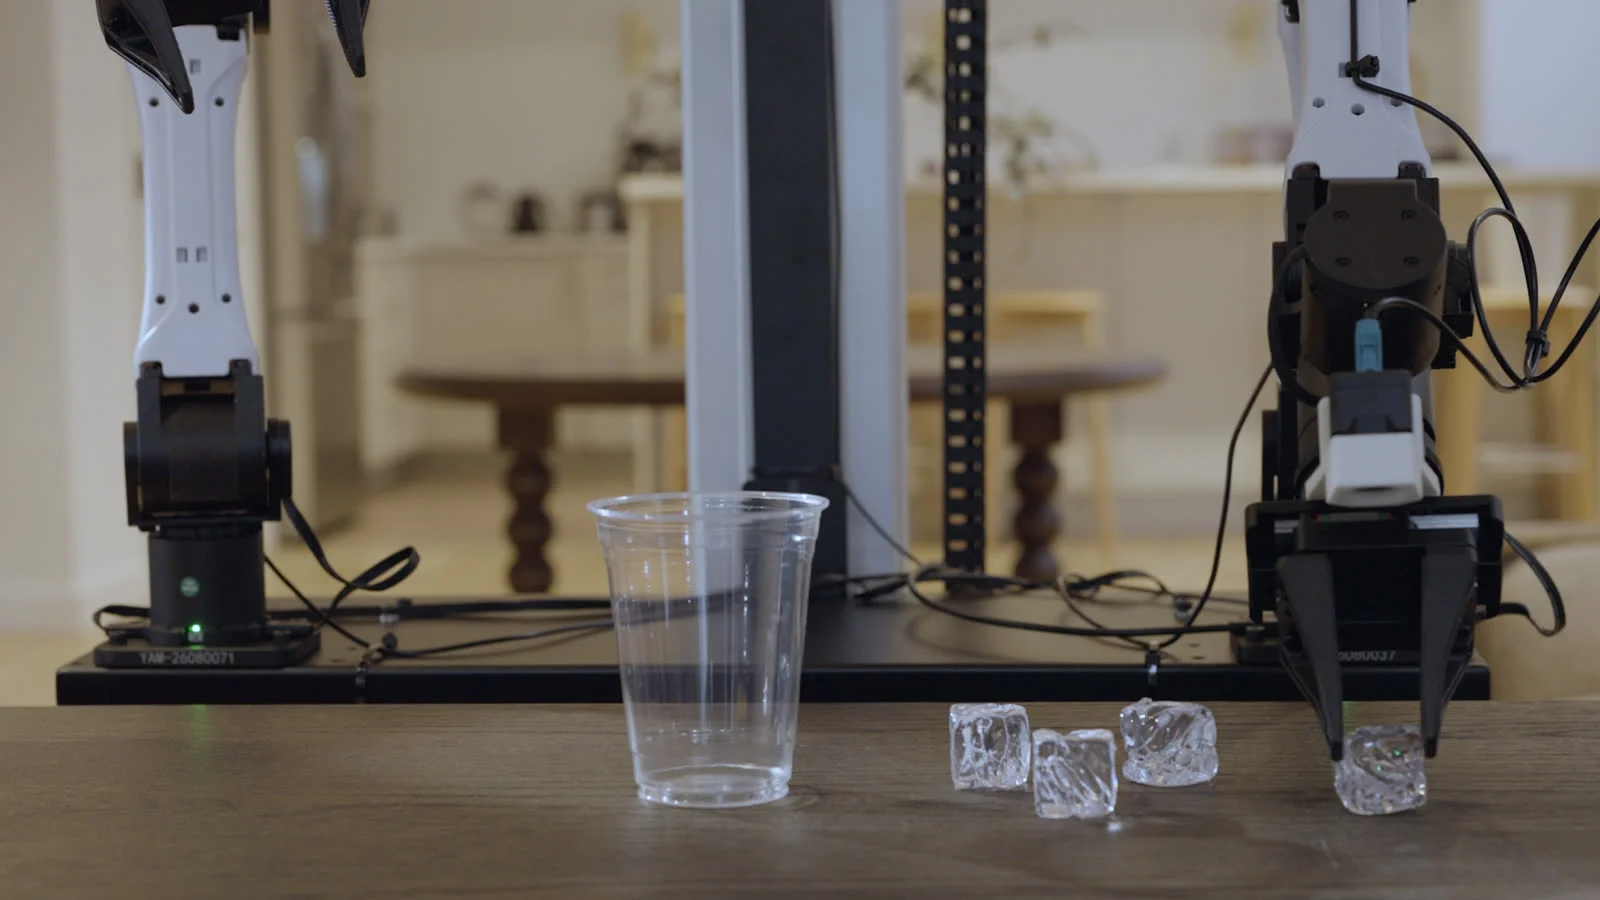
그림 3은 반대로 시연 데이터만으로 학습한 정책이 자주 무너지는 네 경우를 모았습니다. 거의 똑같은 물체 여럿 가운데 하나만 골라야 하는 경우, 그릇이 겹쳐 서로를 가리는 어수선한 식탁, 깊이를 가늠할 단서가 약한 얼음과 투명 플라스틱 컵, 잡을 곳이 정해져 있지 않은 천입니다. 런웨이는 네 경우의 영상을 실었지만, Praxis-1이 각 경우에서 몇 번 성공했는지는 내놓지 않았습니다.
이 네 경우는 로봇이 사람의 일을 넘겨받지 못하는 이유와 겹칩니다. 같은 날 새벽 앤트로픽이 공개한 로봇 노출 지수는 로봇이 아직 못 하는 물리 과업의 이유를 Claude로 따졌는데, 물건을 만지고 다루는 손재주가 모자라 대규모 자동화가 막힌 과업이 물리 과업의 절반이었습니다. 계획·추론 능력이 걸림돌인 과업은 8%였습니다.
| 초기 파트너 | 런웨이가 적은 로봇 | 회사 |
|---|---|---|
| Noble Machines | 양팔 조작, 시연 영상 2배속 | 위험하고 힘든 산업 현장 일을 돕는 범용 로봇 |
| Standard Bots | 6축 로봇 팔 RO1, 시연 영상 2배속 | 산업용 로봇 팔 |
| Ultra | 이동형 베이스(런웨이 표기) | 미국 창고에서 전자상거래 주문 포장을 맡는 로봇 |
세 회사는 각자 자기 하드웨어에서 Praxis-1을 돌리고 있고, 런웨이는 출시 전에 파트너를 더 받겠다고 했습니다. 이번 시험의 목적으로는 효과와 안전을 함께 들었고, 여러 형태의 로봇과 환경에서 빈틈을 찾아 메운 뒤 일반 공개로 가겠다고 적었습니다. 발표 영상에는 몇 분 분량의 시연만으로 어떤 로봇에도 맞출 수 있는 모델 하나라는 내레이션이 나오지만, 그 몇 분이 몇 번의 시연이고 어떤 로봇에서 잰 것인지는 발표문의 실험에 없습니다.
영상 모델을 로봇의 뼈대로 쓰는 시도는 올해 들어 잇따랐습니다. 엔비디아는 5월 31일 GTC 타이베이에서 글·이미지·영상·소리·행동을 한 모델로 다루는 Cosmos 3를 공개 모델로 내놓으며 월드 액션 모델의 뼈대로 쓸 수 있다고 밝혔고, 같은 날 꾸린 Cosmos 연합의 창립 회원 6곳에 런웨이와 BFL이 나란히 이름을 올렸습니다.
BFL은 7월 23일 로봇 스타트업 mimic과 함께 영상 모델 FLUX 3 위에 로봇 동작 예측을 얹은 FLUX-mimic을 공개했습니다. mimic은 앞선 연구 mimic-video에서 영상 생성 모델 위에 동작 예측을 얹은 방식이 기존 VLA 방식보다 표본 효율이 10배 높고 학습 수렴이 2배 빨랐다고 밝혔고, 구조는 FLUX 3 글에 정리했습니다. 이어 BFL은 9월 23일(미국 시각) 70억 파라미터 월드 액션 모델 FLUX 3 Action의 가중치를 풀었습니다. 카메라 화면과 지시문을 받아 앞으로 2초 동안의 동작을 내놓는 모델로, DROID로 파인튜닝해 RoboLab-120 벤치마크에서 성공률 42.92%를 냈습니다.
| 모델 | 회사 | 공개(미국 시각) | 가중치 | 발표 때 낸 성적 |
|---|---|---|---|---|
| Cosmos 3 | 엔비디아 | 5월 31일 | 공개 | RoboLab·RoboArena 오픈 모델 1위(회사 발표) |
| FLUX-mimic 프리뷰 | BFL·mimic | 7월 23일 | 미공개 | 연질 부품 키팅 성공률 95%(π0.5 응용판 55%) |
| FLUX 3 Action | BFL | 9월 23일 | 공개 | RoboLab-120 성공률 42.92% |
| Praxis-1 | 런웨이 | 9월 30일 | 몇 달 안 공개 예정 | 성공률 없음, 사전학습 오차 비교 1건 |
FLUX 3 Action이 낸 RoboLab-120 표에서 Cosmos 3 Nano 기반 정책은 36.8%, π0.5는 28.0%였고, 상위 세 모델이 모두 월드 액션 모델 계열이었습니다. 런웨이의 2월 연구에서 1위였던 π0.5가 이 표에서는 여섯 번째였으니, 벤치마크와 과제가 바뀌면 순위도 함께 움직입니다. 두 회사는 사람으로도 이어져 있어, 런웨이가 2023년 2월 낸 Gen-1 논문의 제1저자 파트리크 에서는 지금 BFL 소속으로 FLUX 3 Action 소개 글의 저자 명단에 있습니다. 영상 생성 모델을 함께 연구했던 사람들이 일주일 간격으로 각자의 로봇 모델을 내놓았습니다.
9월 28일(미국 시각) AMD가 82억 달러에 사기로 한 월드랩스는 월드 모델을 화면을 그리는 렌더러, 기하와 물리를 맞추는 시뮬레이터, 관찰과 목표를 받아 다음 행동을 내는 플래너로 나눴습니다. 이 분류로 보면 Praxis-1은 플래너 쪽 모델이고, 월드랩스는 시뮬레이터 쪽에서 출발해 시뮬레이션에서만 학습한 정책을 실제 로봇에 옮기는 실험을 내놨습니다.
오픈AI는 2019년 10월 사람 손 모양의 로봇 손으로 루빅스 큐브를 맞추는 연구를 공개했습니다. 시뮬레이션에서 쌓은 경험이 1만 3,000년 치였지만 가장 좋은 시스템의 성공률은 20~60%였고, 오픈AI는 2020년 10월 로봇 연구를 더 하지 않기로 했습니다. 이 결정은 2021년 7월 공동창업자 보이치에흐 자렘바의 팟캐스트 발언으로 알려졌습니다.
데이터를 구할 수 있을 때마다 우리는 엄청난 진전을 낼 수 있습니다. 로봇에서는 바로 그 점이 우리 발목을 잡았습니다.— 보이치에흐 자렘바, 오픈AI 공동창업자 (2021년 7월, 벤처비트 보도)
그때 오픈AI가 모자라다고 본 것이 로봇 데이터였고, 런웨이는 그 부족을 사람이 찍은 영상으로 채우겠다고 나섰습니다. 런웨이도 처음부터 로봇을 염두에 둔 회사는 아니었습니다. 공동창업자 아나스타시스 게르마니디스는 2023년 12월 영상 생성 모델을 아주 이르고 제한된 형태의 일반 월드 모델로 보고 장기 연구를 시작한다고 밝혔고, 2025년 9월 테크크런치 인터뷰에서는 영상이 사실처럼 좋아지자 로봇·자율주행 회사들이 먼저 연락해 왔다고 말했습니다. 2018년 창업 때는 생각하지 못한 시장이었고, 실제 환경에서 로봇을 학습시키는 일은 비싸고 오래 걸리고 규모를 키우기 어렵다는 설명이었습니다.
| 날짜(미국 시각) | 런웨이가 한 일 |
|---|---|
| 2023년 2월 | 영상 모델 Gen-1 논문 공개 |
| 2023년 12월 11일 | 일반 월드 모델 장기 연구 시작 발표 |
| 2025년 9월 | 로봇 전담 팀을 꾸린다고 밝힘 |
| 2025년 12월 11일 | 첫 월드 모델 GWM-1 공개, 로봇용 GWM Robotics와 파이썬 SDK 접근 신청 시작 |
| 2026년 2월 27일 | 로봇 정책 8개 평가 연구, 상관계수 0.95 |
| 2026년 5월 31일 | 엔비디아 Cosmos 연합 창립 회원 |
| 2026년 8월 31일 | 인터페이스 월드 모델 Solaris 공개 |
| 2026년 9월 3일 | 실시간 월드 모델 GWM Worlds 2 공개 |
| 2026년 9월 8일 | 파리의 3D 인체 동작 연구팀 Kinetix 합류 |
| 2026년 9월 30일 | Praxis-1 공개 |
발표 영상은 Praxis-1이 Solaris와 GWM Worlds 2를 돌리는 것과 같은 월드 모델 연구와 실시간 인프라에서 나왔다고 설명합니다. 앞의 두 모델이 세상을 생성하며 배웠다면 Praxis-1은 그 이해로 세상 안에서 움직인다는 내레이션이고, 3주 전 Kinetix 합류를 알리던 게르마니디스의 말과 같은 방향입니다.
로봇은 월드 모델의 가장 큰 쓰임새 가운데 하나가 될 겁니다. 다음 단계는 모델에게 세상 안에서 행동하는 법을 가르치는 일입니다.— 아나스타시스 게르마니디스, 런웨이 공동 CEO (9월 8일)
Praxis-1 발표문은 가중치를 공개하는 이유에 한 단락을 따로 썼습니다. 런웨이는 미국이 제조업에서 다시 앞서고, 경제 전반의 생산성을 끌어올리고, 미국과 동맹국의 안보를 지키려면 피지컬 AI에서 미국이 앞서야 한다고 적었습니다. 이를 위해 하드웨어와 소프트웨어 투자가 크게 늘어야 하고, 물리 세계에 쓰는 미국 모델에는 지금 없는 수준의 상호 운용성과 개방성이 필요하다는 주장입니다. 공개 월드 모델이 하드웨어 개발자에게 지금 갖지 못한 유연성과 통제권을 주고 그 이점이 쌓여 간다는 것이 회사의 설명입니다.
로봇 몸체 시장의 숫자는 미국에 유리하지 않습니다. 테크크런치에 따르면 2025년 전 세계에 출하된 휴머노이드는 약 1만 5,000대였고 그 절반 넘게를 중국 상위 두 제조사가 냈습니다. 미국 연방통신위원회(FCC)는 7월 28일(미국 시각) 외국에서 만든 휴머노이드와 로봇 개의 신규 수입을 금지했고, 이 일은 Gemini Robotics ER 2 글에도 적었습니다. 공개 모델에서도 중국 회사가 먼저 움직였습니다. 유니트리는 2025년 9월 15일 월드 모델과 행동 예측을 묶은 UnifoLM-WMA-0의 가중치와 학습 코드를 공개했고, 9월 말 스탠퍼드·칼텍 연구진이 GPT-6 Astra로 조종한 HomeBody의 몸도 유니트리 G1이었습니다.
국제로봇연맹(IFR)에 따르면 2023년 한국 제조업의 노동자 1만 명당 산업용 로봇은 1,012대로 세계 1위였고, 미국은 295대로 10위였습니다. IFR이 세는 로봇은 공장에서 일하는 산업용 로봇이고, Praxis-1은 런웨이 설명대로라면 몇 분 분량의 시연으로 어떤 형태의 로봇에도 맞추는 범용 정책을 겨냥합니다.
엔비디아는 Cosmos 3 발표에서 Cosmos 위에 로봇을 만드는 회사로 두산로보틱스, LG전자, 삼성전자를 꼽았습니다. Praxis-1 가중치가 나오면 국내 로봇 회사도 자기 로봇의 시연 자료로 모델을 맞춰 볼 수 있지만, 라이선스와 상업적 이용 조건은 아직 나오지 않았습니다.
지금 써 보는 길은 런웨이 로보틱스 팀에 출시 전 접근을 신청하는 것뿐입니다. 런웨이가 이미 팔고 있는 로보틱스 플랫폼(정책 모델, 오프라인 정책 평가, 데이터 증강, 영상 모델 라이선스)은 고객의 하드웨어에 맞춰 런웨이와 함께 조정하는 방식이고, 그 가운데 정책 모델은 고객의 시연 자료로 GWM-1을 파인튜닝한 뒤 파이썬 SDK로 카메라 화면과 관절 상태를 클라우드 API에 보내 동작을 돌려받습니다. 배치마다 범위를 런웨이 팀과 따로 정하고, 가격은 공개돼 있지 않습니다.
Praxis-1의 파라미터 수, 과제별 성공률, 동작 하나를 내는 데 걸리는 시간과 필요한 연산 장비, 가중치 라이선스, 공개 날짜는 발표문에 없습니다. 로봇 위에서 바로 돌 수 있는지는 실제 배치의 조건이고, mimic도 영상 모델은 지연이 길고 연산을 많이 먹는 것으로 알려져 있다고 적었습니다. mimic은 FLUX-mimic이 생산 현장 로봇의 RTX 5090 한 장에서 돈다고 밝혔고, BFL은 FLUX 3 Action의 젯슨 배포를 엔비디아와 함께 준비했다고 적었습니다. 런웨이의 기존 정책 모델은 클라우드 API로 동작을 받는 구조였습니다.
웹 영상을 어디서 얼마나 모았는지도 나오지 않았습니다. 그림 2의 웹 영상이 어떤 영상이었는지, Praxis-1 본 학습에 쓴 영상이 몇 시간인지 밝히지 않아 1,000시간 실험과 실제 모델 사이의 거리를 잴 수 없습니다.
런웨이는 몇 달 안에 가중치를 내놓고, 그 전까지 파트너를 더 받아 여러 로봇과 환경에서 효과와 안전을 점검하겠다고 했습니다. 공개 때 성공률과 라이선스가 함께 나오면 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림