이 글 어땠어요?
부품을 모두 GPU에 올리면 38GiB대 메모리를 씁니다. SGLang은 RTX 4090(24GB)에서 인코더를 CPU 메모리로 돌려 1024×1024 생성 18.68초, 최대 22.7GiB로 돌렸고, Unsloth는 4비트 GGUF라면 12~16GB VRAM에서도 1024×1024를 만들 수 있다고 안내했습니다. Unsloth의 메모리 수치는 추정치입니다.
무료 라이선스는 연구와 평가 목적으로만 쓸 수 있고, 상업 이용에는 항저우 퉁이실험실의 별도 라이선스가 필요합니다. 조건과 가격은 공개되지 않았습니다. 2025년에 나온 Qwen-Image-Layered와 Qwen-Image-Edit-2511은 Apache 2.0이라 지금도 상업 이용이 허용됩니다.
알리바바 자체 채점표에서는 Nano Banana 2.0보다 0.46점 높지만 29개 모델 가운데 7위입니다. 시험을 낸 회사와 채점 모델을 만든 회사도 모두 알리바바입니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
딥시크가 9월 10일 552B MoE 모델 V4.1-Flash를 MIT 라이선스로 공개했습니다. 토큰당 KV 캐시는 V4-Flash의 약 4분의 1이고, 오프피크 요금은 캐시 적중 입력 0.003달러, 출력 0.6달러로 8월보다 내렸습니다.

텐센트가 8월 28일 Hy4 프리뷰를 아파치 2.0으로 공개했습니다. 31일 동안 나온 다섯 번째 중국 대형 오픈웨이트이고, 알리바바가 사업자에게 별도 계약을 요구하는 동안 텐센트는 조건 없는 라이선스를 택했습니다. 생각이 너무 긴 한계도 적었습니다.
9월 18일 공개된 Qwen3.8-Omni-Flash는 입력을 종류와 상관없이 100만 토큰당 0.15달러로 받아, 이전 세대가 11달러를 받던 음성 입력이 0.15달러가 됐습니다. 시간당 가격은 회사 추정치이고 출력 비용은 따로 붙습니다.
딥시크가 9월 10일 552B MoE 모델 V4.1-Flash를 MIT 라이선스로 공개했습니다. 토큰당 KV 캐시는 V4-Flash의 약 4분의 1이고, 오프피크 요금은 캐시 적중 입력 0.003달러, 출력 0.6달러로 8월보다 내렸습니다.

텐센트가 8월 28일 Hy4 프리뷰를 아파치 2.0으로 공개했습니다. 31일 동안 나온 다섯 번째 중국 대형 오픈웨이트이고, 알리바바가 사업자에게 별도 계약을 요구하는 동안 텐센트는 조건 없는 라이선스를 택했습니다. 생각이 너무 긴 한계도 적었습니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@Alibaba_QwenX 게시물 · 원문 보기
발표는 Qwen 공식 X 계정에 한국 시각 밤 10시쯤 올라왔습니다. Qwen-Image 시리즈에서 가장 균형 잡히고 비용 대비 효율이 높은 모델이라는 소개와 함께, 생성과 편집을 체크포인트(학습을 마친 가중치 파일 묶음) 하나로 처리하고 가벼운 크기에 최상위권 품질을 담았다고 적었습니다. 같은 날 허깅페이스 Diffusers와 ComfyUI, vLLM, SGLang이 이 모델의 실행을 지원했습니다.
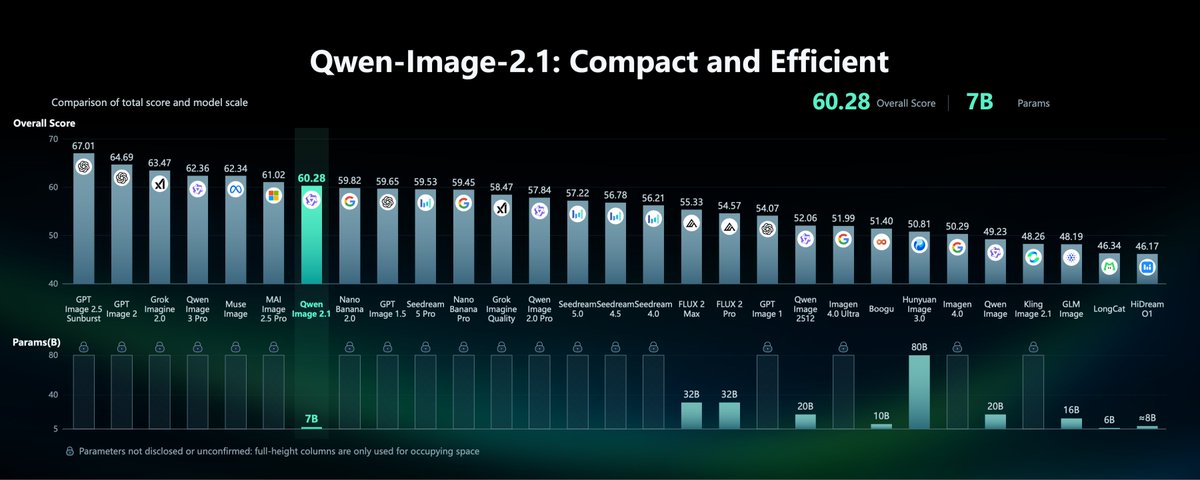
Qwen 팀은 자체 평가 Qwen-Image-Bench의 총점을 모델 크기와 함께 그린 도표를 발표에 붙였습니다. 도표에 오른 모델은 29개이고, Qwen-Image-2.1은 60.28점으로 7위입니다. 1위는 오픈AI가 9월 8일 내놓은 GPT-Image-2.5의 Sunburst(67.01점)이고, GPT Image 2와 xAI의 Grok Imagine 2.0, 알리바바 자신의 Qwen Image 3 Pro, 메타의 Muse Image, 마이크로소프트의 MAI Image 2.5 Pro가 뒤를 잇습니다. 이 여섯 모델은 모두 파라미터 수를 밝히지 않았습니다.
| 순위 | 모델 | 총점 | 파라미터 |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67.01 | 비공개 |
| 4 | Qwen Image 3 Pro | 62.36 | 비공개 |
| 7 | Qwen-Image-2.1 | 60.28 | 7B |
| 8 | Nano Banana 2.0 | 59.82 | 비공개 |
| 11 | Nano Banana Pro | 59.45 | 비공개 |
| 13 | Qwen Image 2.0 Pro | 57.84 | 비공개 |
| 17 | FLUX 2 Max | 55.33 | 32B |
| 20 | Qwen-Image-2512 | 52.06 | 20B |
| 23 | Hunyuan Image 3.0 | 50.81 | 80B |
| 25 | Qwen-Image (2025년 8월) | 49.23 | 20B |
바로 아래가 구글의 Nano Banana 2.0(59.82점)이고, Nano Banana Pro(59.45점)는 11위입니다. 저는 공개 당일 스레드에서 이 모델을 「나노바나나급」이라고 소개했는데, 그 근거가 이 0.46점과 0.83점 차이였습니다. 채점표 전체를 펼치면 그 위에 모델이 여섯 개 더 있습니다.
파라미터 수를 밝힌 모델끼리 보면 순서가 달라집니다. 7B인 Qwen-Image-2.1이 가장 높고, 블랙포레스트랩스의 FLUX 2 Max(32B)는 55.33점, 텐센트 Hunyuan Image 3.0(80B)은 50.81점입니다. 같은 회사의 첫 Qwen-Image(20B)는 49.23점이라, 생성부를 3분의 1로 줄이는 1년여 동안 총점이 11.05점 올랐습니다.
점수가 60점 안팎에 모인 이유는 채점 방식에 있습니다. Qwen-Image-Bench는 알리바바가 5월에 논문과 함께 공개한 평가로, 프롬프트 1,000개로 만든 이미지를 품질·미감·지시 반영·현실 충실도·창작 다섯 영역의 세부 항목으로 나눠 채점합니다. 항목마다 실패는 0점, 통과는 60점, 뛰어남은 100점을 주고 평균을 내므로, 총점 60점은 평균적으로 모든 항목을 통과한 수준에 해당합니다.
채점은 알리바바가 Qwen3.6-27B에 추가 학습을 시킨 심사 모델 Q-Judger가 맡습니다. 알리바바는 이 심사 모델이 매긴 순위가 모델 18개에 대한 전문가 순위와 0.92의 상관(스피어만 순위 상관계수)을 보였다고 밝혔습니다. 심사 모델과 프롬프트는 Apache 2.0으로 공개돼 누구나 같은 채점을 다시 돌릴 수 있지만, 시험을 낸 회사와 채점 모델을 만든 회사, 7위에 오른 모델을 만든 회사가 모두 알리바바입니다.
Qwen-Image-2.1은 부품 세 개로 돌아갑니다. 사용자의 문장과 참고 이미지를 읽는 인코더는 알리바바의 시각·언어 모델 Qwen3-VL-8B이고, 노이즈를 조금씩 걷어 내며 그림을 그리는 생성부는 레이어 32개짜리 디퓨전 트랜스포머(7B)입니다. 마지막으로 이미지 변환부(VAE)가 결과를 픽셀로 풀어내는데, 빨강·초록·파랑에 투명도까지 네 채널을 그대로 다뤄 투명 배경이 중간에 사라지지 않습니다.
허깅페이스에 올라온 파일 크기로 보면 그리는 부품보다 읽는 부품이 큽니다. 인코더가 17.53GB, 생성부가 14.23GB, 변환부가 1.35GB로 모두 33.13GB입니다. 이 조합은 2월 Qwen-Image-2.0에서 먼저 나왔는데, 알리바바는 그때 8B Qwen3-VL 인코더와 7B 디퓨전 디코더 구성을 소개하고도 가중치는 내놓지 않았습니다. 같은 채점표에서 Qwen Image 2.0 Pro는 57.84점으로 2.1보다 2.44점 낮습니다.
속도를 끌어올린 장치는 어텐션 배치입니다. 디퓨전 모델은 그림 한 장을 만들 때 비슷한 계산을 수십 번(스텝) 되풀이하는데, 2.1은 시스템 문구와 참고 이미지, 편집 지시를 첫 스텝에서 한 번만 계산해 저장해 두고(프리픽스 KV 캐시) 나머지 스텝에서는 꺼내 씁니다. 스텝마다 새로 계산하는 부분은 지금 그리고 있는 이미지뿐입니다.
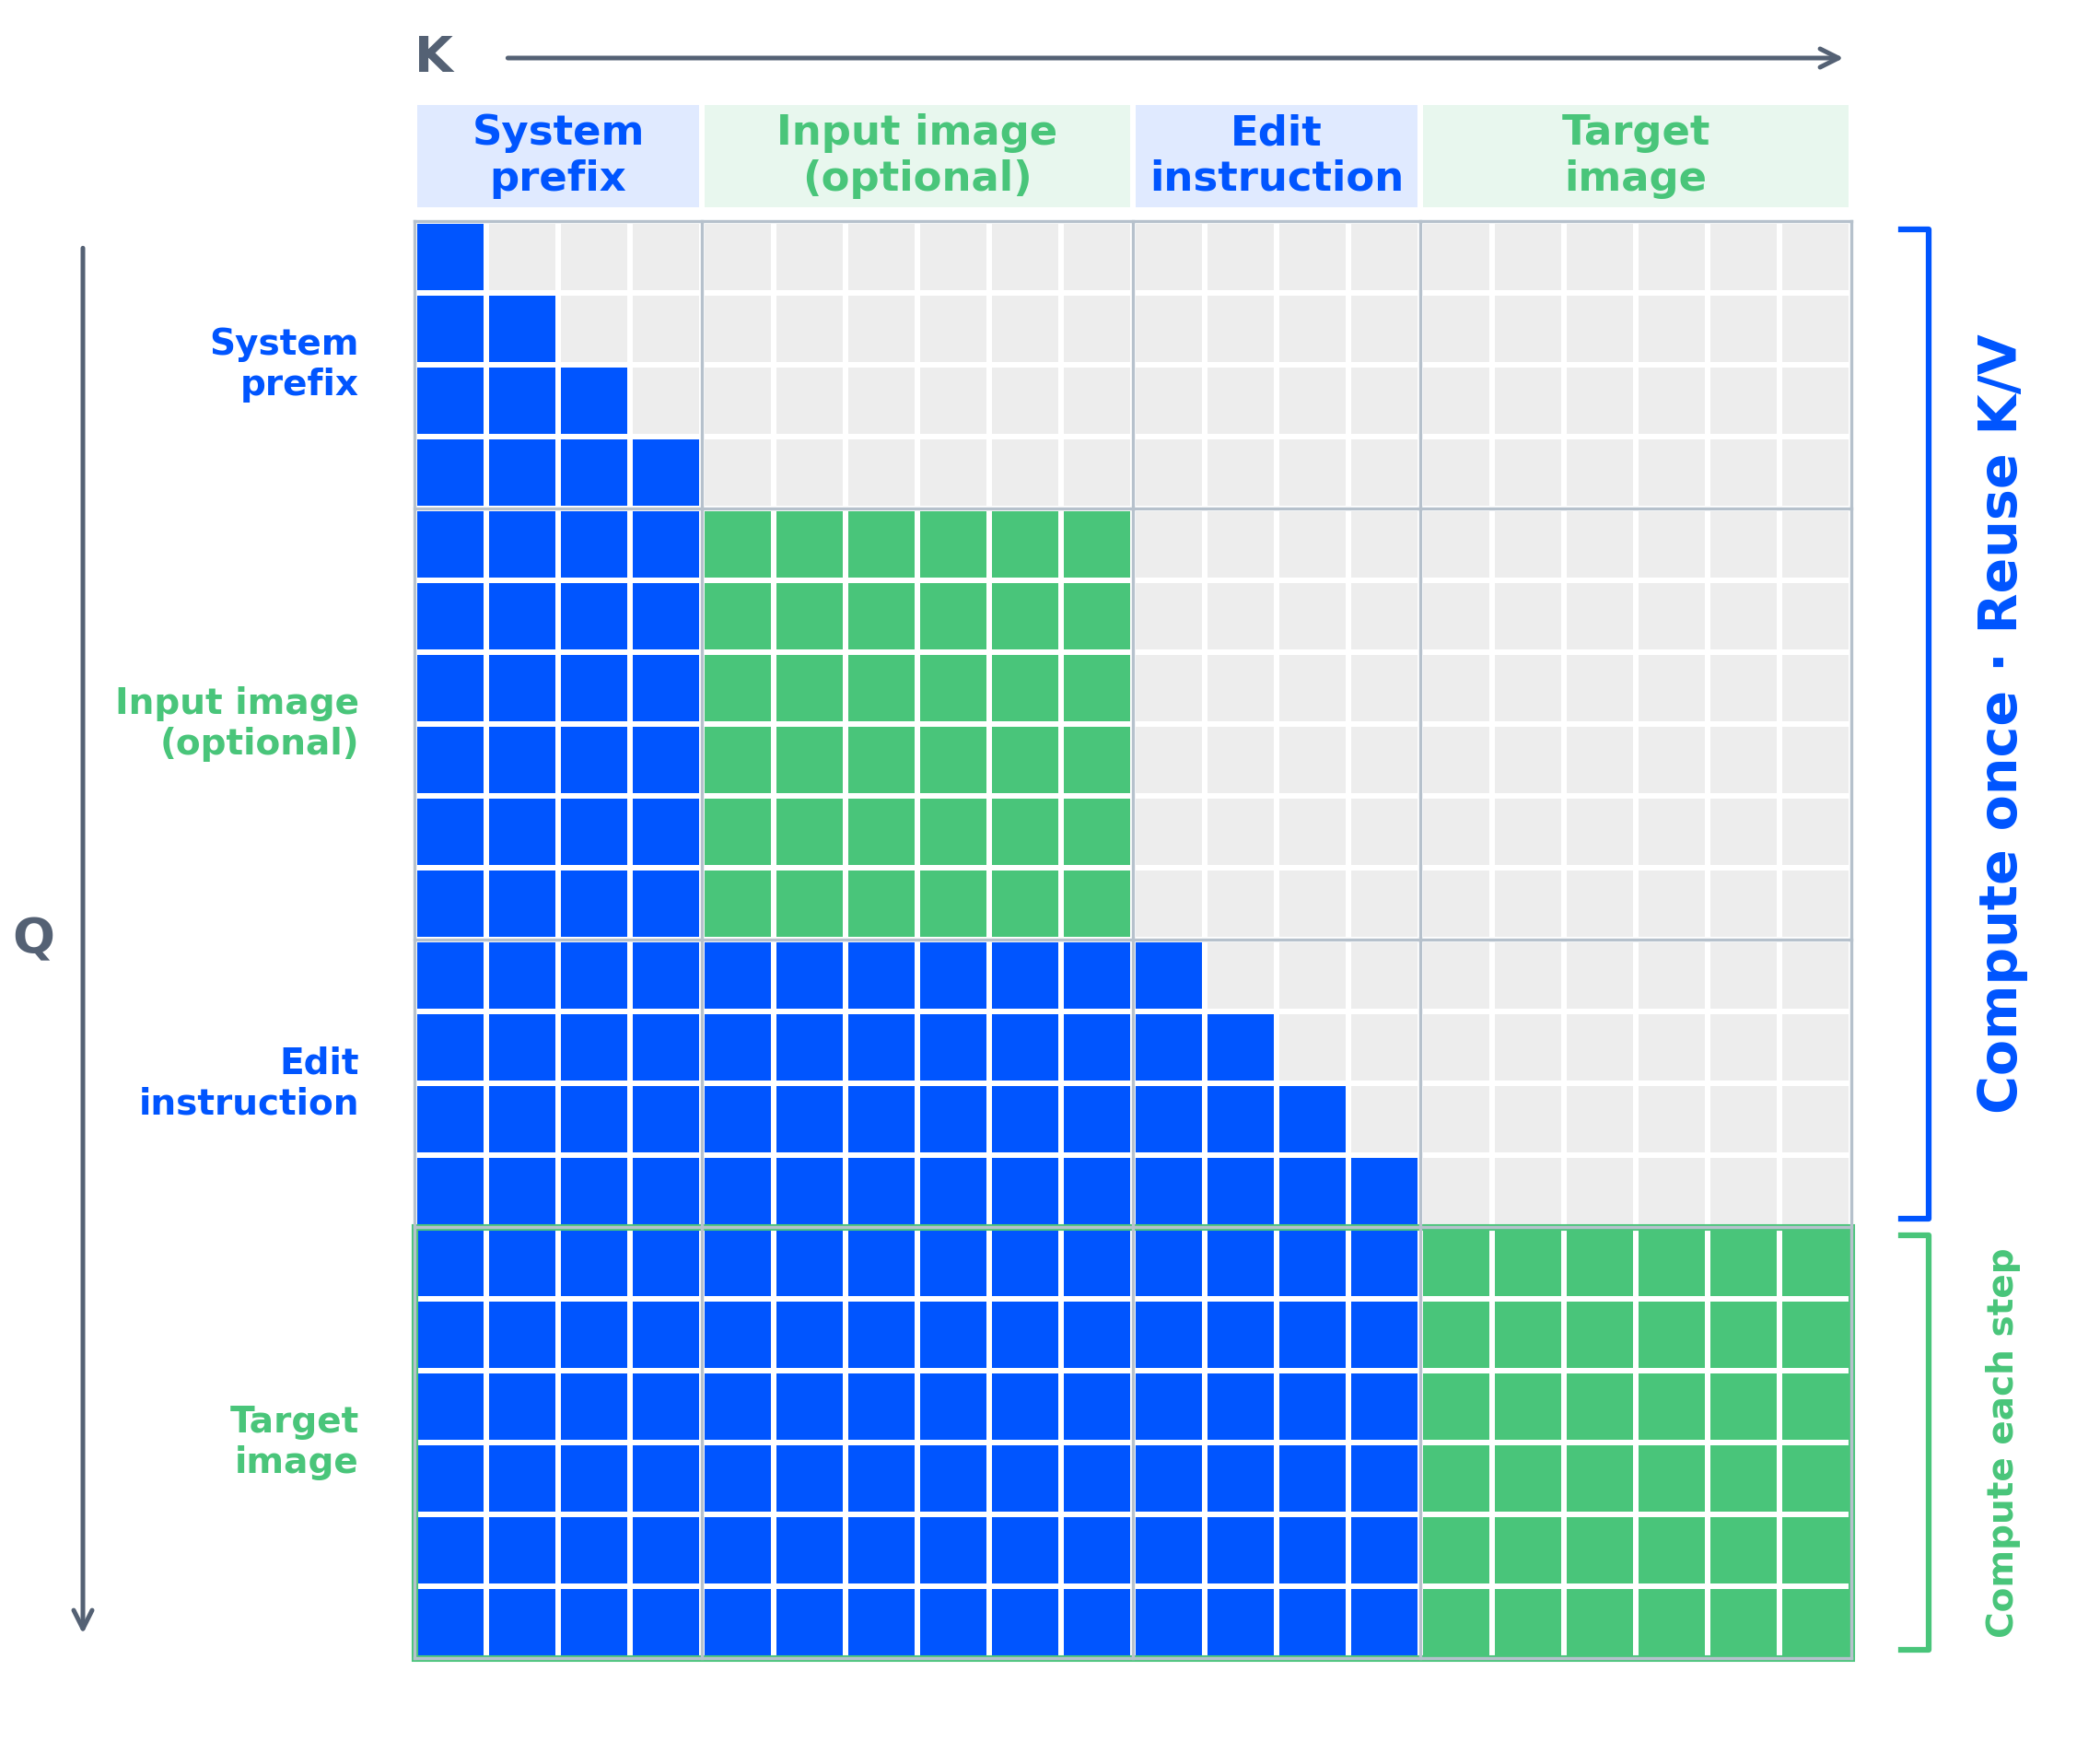
효과는 앞에 붙는 입력이 길수록 커집니다. vLLM 레시피에는 같은 프롬프트를 다시 보내면 처음 계산량의 3분의 1 정도가 들고, 참고 이미지 네 장을 넣으면 스텝마다 다시 계산할 부분이 전체의 5분의 1 정도로 줄어든다고 적혀 있습니다. 짧은 문장 하나로 그리는 요청은 저장해 둘 앞부분이 거의 없어서 이득도 작습니다.
가중치를 받은 사람이 가장 먼저 부딪히는 숫자는 메모리입니다. SGLang 팀은 공개 당일 여러 GPU에서 생성과 편집 시간을 재서 공개했는데, 부품을 모두 GPU에 올려 두면 최대 38GiB대 메모리를 씁니다.
| GPU | 부품 배치 | 생성 | 편집 | 최대 GPU 메모리 |
|---|---|---|---|---|
| B200 192GB | 모두 GPU에 | 2.46초 | 3.02초 | 38.5GiB |
| H200 141GB | 모두 GPU에 | 4.48초 | 5.29초 | 38.4GiB |
| RTX PRO 6000 96GB | 모두 GPU에 | 8.03초 | 9.63초 | 38.4GiB |
| RTX 4090 24GB | 인코더만 레이어별로 CPU 메모리에서 | 18.68초 | 21.68초 | 22.7GiB |
| DGX Spark 128GB | 모두 통합 메모리에 | 35.36초 | 42.23초 | 통합 메모리 |
측정 조건은 1024×1024 한 장, 40스텝, 투명도를 담은 PNG 출력입니다. 서버를 켜 둔 상태에서 요청을 받아 PNG를 내보내기까지 걸린 시간의 중앙값이고, 서버를 처음 띄우는 시간은 빠져 있습니다.
24GB짜리 RTX 4090에는 38GiB가 한 번에 들어가지 않습니다. 그래서 SGLang은 생성부와 변환부는 GPU에 두고, 가장 큰 인코더만 레이어 단위로 CPU 쪽 메모리에서 불러와 쓰는 방식으로 22.7GiB에 맞췄습니다. 이 조건의 18.68초로 계산하면 카드 한 장이 한 시간에 약 190장을 만듭니다.
@sgl_projectX 게시물 · 원문 보기
다만 모델의 기본 출력은 2048×2048입니다. 공식 예제 코드도 2K를 기본값으로 두는데, SGLang이 잰 값은 1K 한 장이라 2K 출력이나 참고 이미지를 여러 장 넣은 요청의 시간과 메모리는 이 표에 없습니다.
더 작은 카드를 위한 파일도 나왔습니다. Unsloth는 생성부를 4비트로 줄인 GGUF 파일을 올렸는데, Q4_K_M 판이 4.20GB이고 함께 쓰는 Qwen3-VL-8B 인코더의 4비트 판이 5.15GB입니다. Unsloth는 12~16GB VRAM이면 이 조합으로 1024×1024를 만들 수 있고, 6GB VRAM에서도 FP8 파일과 오프로딩(당장 쓰지 않는 부품을 CPU 메모리로 내려 두는 방식)을 쓰면 두 배 미만으로 느려진 채 돌아간다고 안내했습니다. 이 메모리 수치는 추정치라고 덧붙였습니다.
메모리를 줄일 때도 효과가 큰 쪽은 인코더입니다. vLLM 레시피가 GB300 한 장에서 잰 결과로는 인코더를 8비트(FP8)로 줄이자 최대 메모리가 약 6GB 줄었고, 생성부를 줄였을 때는 약 2GB 줄었습니다. 두 경우 모두 속도가 빨라지지는 않았습니다. 공식 저장소가 권하는 프롬프트 재작성 모델(짧은 요청을 긴 묘사로 늘려 주는 Qwen3.5-VL 9B 기반 모델)까지 붙이면, 7B 생성부 옆에서 돌아가는 언어 모델이 두 개로 늘어납니다.
Qwen-Image-2.1은 투명도 채널을 담은 RGBA 이미지를 처음부터 만듭니다. Qwen은 2025년 12월 이미지를 투명 레이어로 나누는 Qwen-Image-Layered를 따로 냈는데, 이번에 그 기능을 생성·편집 모델 안으로 넣었습니다. 투명 이미지 속 표정이나 글자를 고치는 편집, 일반 사진에서 대상만 떼어 내 투명 레이어로 만드는 작업도 같은 모델이 합니다. 국내 커머스에서 '누끼 따기'라고 부르는 배경 제거 작업이 생성 단계 안으로 들어온 겁니다.
참고 이미지는 한 번에 10장까지 넣을 수 있습니다. 공식 예시는 인물 사진 6장으로 한 공간의 단체사진을 만들고, 모델·옷·신발·가방·모자 사진 5장으로 착장 한 벌을 입히고, 가구와 소품 사진 10장으로 방 하나를 꾸몄습니다.
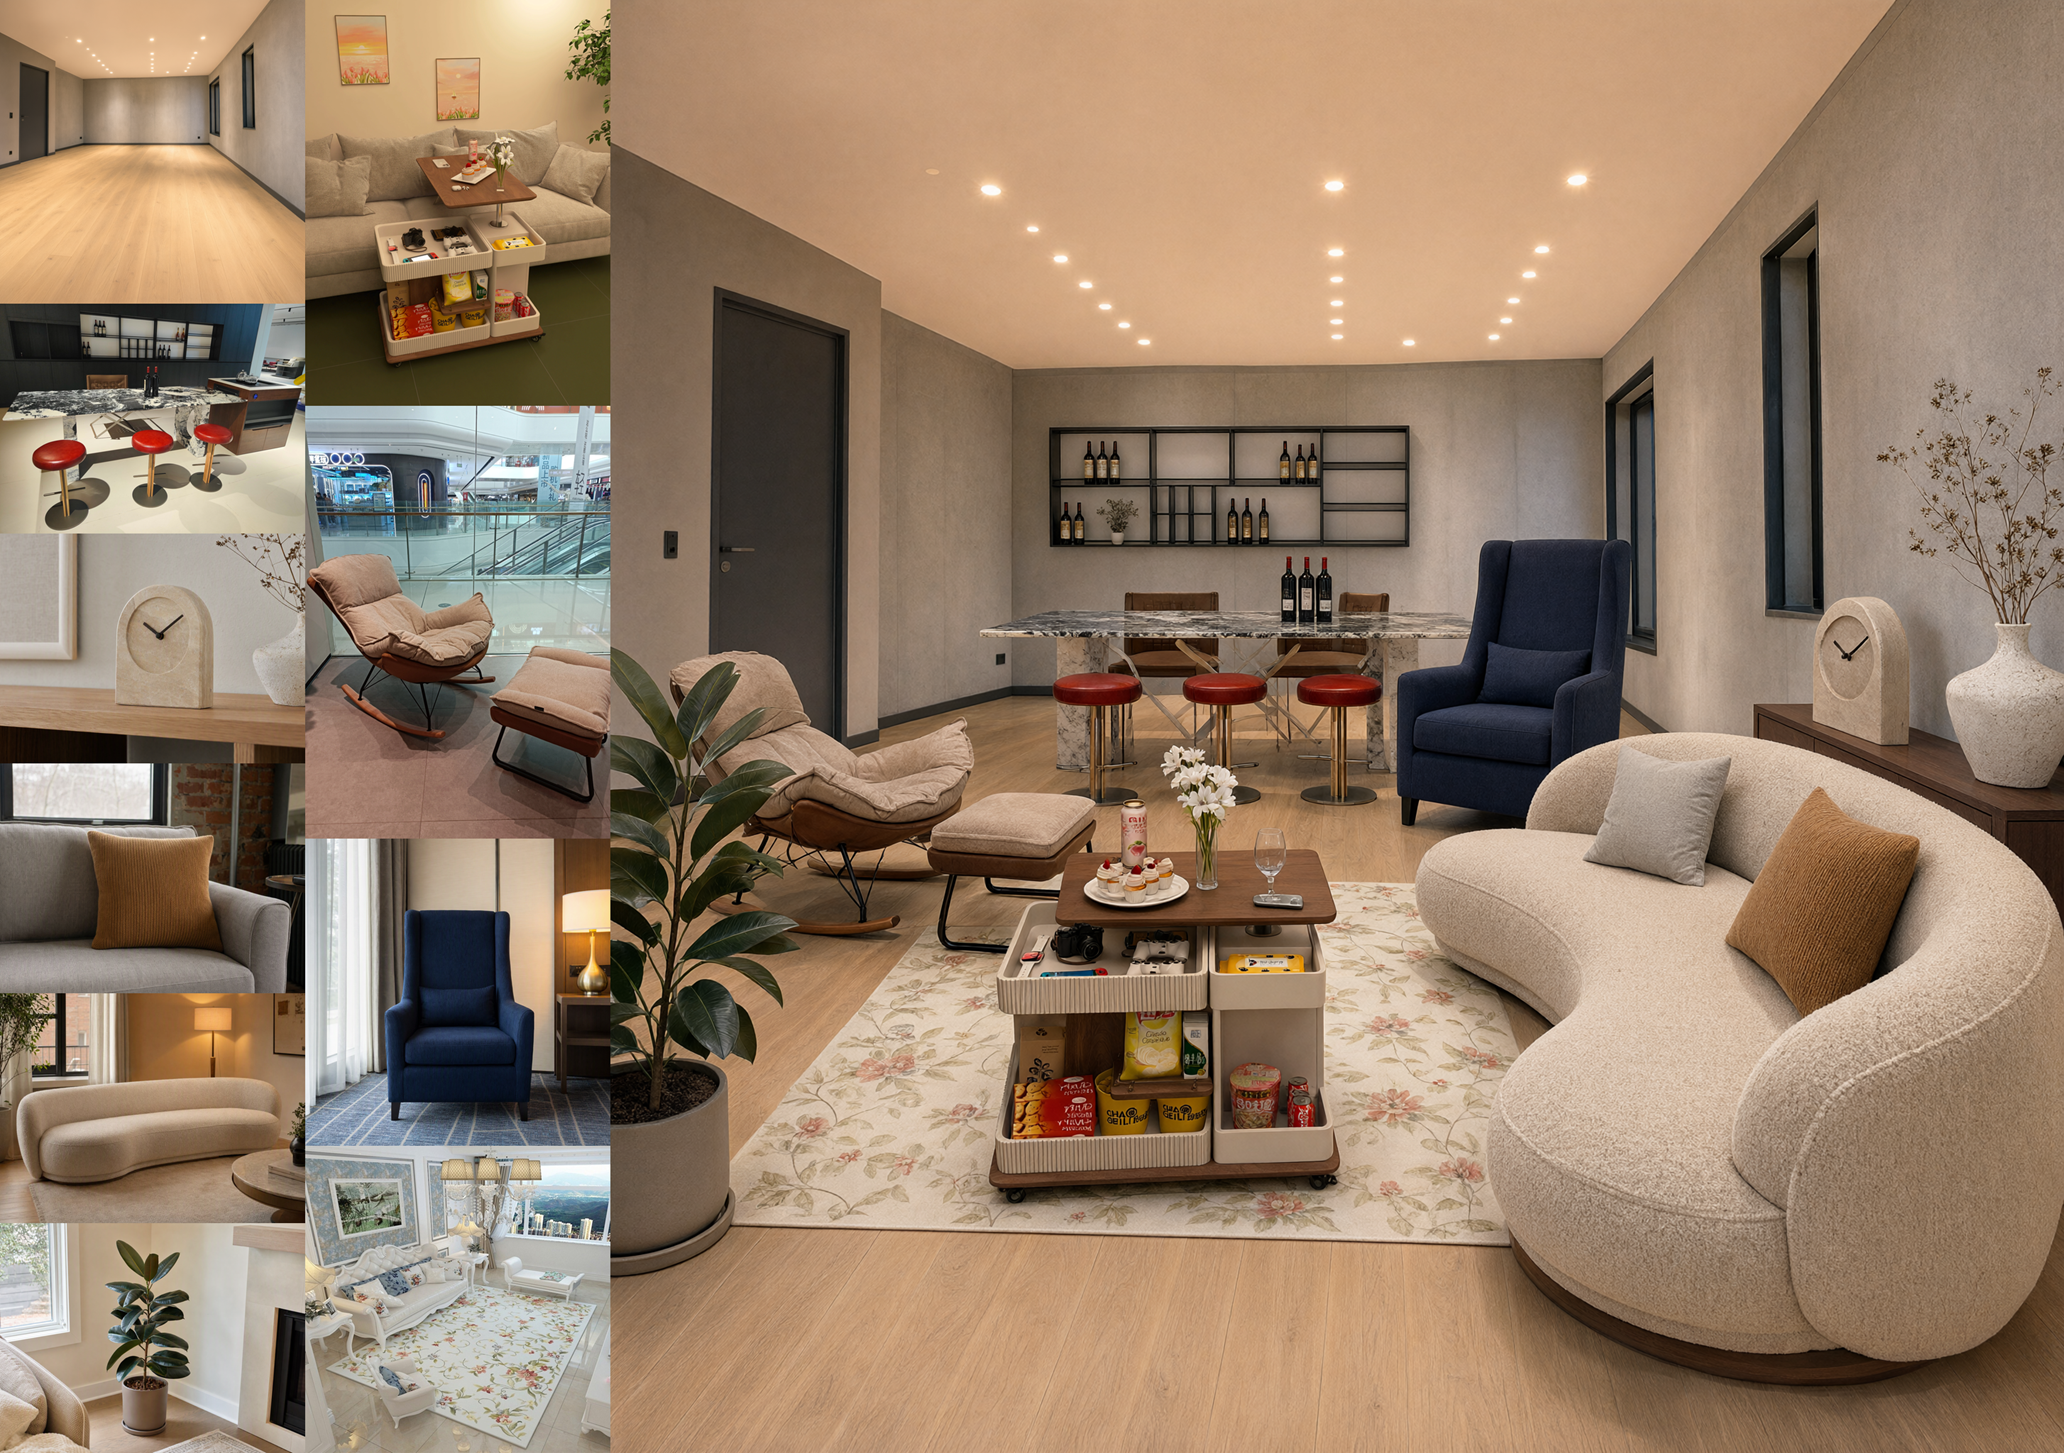
실행 엔진에 따라 받는 장수는 다릅니다. vLLM-Omni의 현재 구현은 요청 한 번에 참고 이미지를 4장까지 받고 다섯 번째부터는 오류를 돌려보냅니다. 각 이미지는 따로 약 1024×1024 넓이로 줄여 넣고, 들어온 순서대로 이미지1, 이미지2처럼 번호가 붙어 문장 속 「첫 번째 사진」이 어느 파일인지 정해집니다.
고칠 곳을 직접 표시하는 편집도 됩니다. 공식 시연은 사진 위에 색깔 원 세 개를 그려 놓고, 파란 원의 금속 시계는 지우고 빨간 원의 머리는 검게, 초록 원은 회색 반소매 리넨 잠옷으로 바꿔 달라고 한 문장으로 요청했습니다. 원이나 붓 칠이 원본을 가릴 때는 원본과 마스크(고칠 영역만 표시한 이미지)를 따로 넣을 수 있습니다.
@Alibaba_QwenX 게시물 · 원문 보기
글자 표현도 손봤다고 밝혔지만 공식 예시 네 장은 영어 논문 도판, 중국어 성곽 안내도, 영어 여행 앱 화면, 중국어 시험지입니다. 한글 문구가 들어간 예시는 공식 자료에 없습니다.
Qwen-Image 계열의 공개 이력을 날짜순으로 놓으면 이번 라이선스가 어디서 달라졌는지 보입니다. 2025년에 나온 여섯 모델은 모두 Apache 2.0이었고, 올해 나온 2.0과 3.0은 가중치 없이 Qwen Chat으로만 나왔습니다.
| 공개일 | 모델 | 가중치 | 라이선스 |
|---|---|---|---|
| 2025년 8월 4일 | Qwen-Image (20B) | 공개 | Apache 2.0 |
| 2025년 8월 18일 | Qwen-Image-Edit | 공개 | Apache 2.0 |
| 2025년 9월 22일 | Qwen-Image-Edit-2509 | 공개 | Apache 2.0 |
| 2025년 12월 19일 | Qwen-Image-Layered | 공개 | Apache 2.0 |
| 2025년 12월 23일 | Qwen-Image-Edit-2511 | 공개 | Apache 2.0 |
| 2025년 12월 31일 | Qwen-Image-2512 | 공개 | Apache 2.0 |
| 2026년 2월 | Qwen-Image-2.0 | 비공개(Qwen Chat) | 없음 |
| 2026년 7월 16일 | Qwen-Image-3.0 | 비공개(Qwen Chat) | 없음 |
| 2026년 9월 20일 | Qwen-Image-2.1 | 공개 | Qwen 연구용 라이선스 |
Apache 2.0은 누구나 내려받아 고치고 상업 서비스에 넣을 수 있는 라이선스입니다. 9월에 다시 파일로 풀린 2.1에는 이 라이선스 대신 Qwen 연구용 라이선스가 붙었습니다.
라이선스 문서는 비상업을 연구 또는 평가 목적으로만 정의하고, 상업적으로 쓰려면 라이선스를 내준 항저우 퉁이실험실에서 별도 라이선스를 받으라고 적었습니다. 2.1이나 그 출력으로 만든 모델을 배포할 때는 문서에 「Built with Qwen」을 표시하는 조건이 붙고, 분쟁은 중국법에 따라 항저우 인민법원이 맡습니다. 채점표 4위로 자사 모델 중 가장 높은 Qwen Image 3 Pro(62.36점)는 서비스 안에 두고, 한 세대 아래 7B 설계는 파일로 풀되 돈이 오가는 쓰임에는 계약을 걸어 둔 구성입니다.
당장 할 수 있는 일은 평가입니다. 가중치를 사내 GPU에 올리면 미공개 신제품 사진이나 초상권 계약이 걸린 모델 사진을 회사 밖으로 내보내지 않고 품질을 잴 수 있고, RTX 4090 한 장이면 1K 기준 한 시간에 190장 안팎을 뽑아 볼 수 있습니다. 그 결과물을 고객사 상세페이지나 광고에 쓰는 순간부터는 상업 이용에 해당해, 알리바바와 라이선스 계약을 맺은 뒤에야 쓸 수 있습니다.
상업 서비스에 바로 넣을 모델이 필요하다면 전작들이 남아 있습니다. 투명 레이어는 Qwen-Image-Layered가, 여러 장을 섞는 편집은 Qwen-Image-Edit-2511이 맡고, 두 모델 모두 Apache 2.0이라 상업 이용이 허용됩니다.
2K 출력의 속도와 메모리, 한글 글자 표현, 4비트 판과 원본의 품질 차이, 상업용 라이선스의 조건과 가격은 공개된 자료가 없습니다. 심사 모델과 프롬프트 1,000개가 공개돼 있으니, 다른 팀이 같은 채점을 돌린 결과가 나오면 60.28점이 어디까지 맞는지 확인할 수 있습니다.
읽어 주셔서 고맙습니다.
초이 드림


