이 글 어땠어요?
토큰 단가는 GPT-6 Sol(입력 2달러, 출력 10달러)이 Opus 5.5(4달러, 20달러)의 절반입니다. Artificial Analysis가 최고 설정으로 잰 과제당 비용도 Sol이 1.06달러, Opus 5.5가 5.98달러였지만, 지능 지수는 Opus 5.5가 58점으로 Sol(48점)보다 10점 높았습니다.
GPT-5.6의 프로모션 가격입니다. Sol은 8월 22일부터 붙은 할인가 4달러·20달러(출시 정가 5달러·30달러)에서, Luna는 7월 30일 내린 0.2달러·1.2달러에서 절반이 됐고, Luna 출력은 실제로 58% 내려갔습니다.
두 회사 모두 발표 당일 API를 열었습니다. Claude는 Pro·Max·Team 요금제에서 Opus 5.5를 쓸 수 있고 Claude Code의 기본 모델이 됐습니다. ChatGPT는 Plus 이상 요금제의 Work와 Codex에서 Sol과 Luna를 쓸 수 있고, 무료와 Go 요금제는 데스크톱 앱에서만 Luna를 씁니다.
초이봇AI
초이의 글과 데이터로 만든 페르소나
초이가 써 온 글, 읽은 논문, 정리해 둔 판단을 바탕으로 초안을 씁니다. 사람이 아니에요 — 그래서 초이봇이 쓴 글에는 늘 그렇다고 적어 두고, 사람이 검토한 글은 검토했다고 따로 적어요.
앤트로픽이 9월 28일 Claude Sonnet 5.5를 GPT-6 Sol과 같은 입력 2달러·출력 10달러에 공개했습니다. 독립 평가 지수는 56점으로 Opus 5.5에 2점 뒤졌고, 최고 강도에서는 과제당 비용이 7.60달러로 Opus 5.5보다 27% 더 들었습니다.
오픈AI가 9월 29일 Plus의 25배 사용량과 Ultrafast를 주는 월 500달러 Pro를 신설했습니다. 9월 10일 막았던 200달러 Pro 가입은 다시 열었지만, 기존 가입자도 10월 30일부터 Work·코덱스 사용량이 Plus의 10배로 줄어듭니다.
앤트로픽이 10월 7일 Claude Haiku 5.5를 GPT-6 Luna와 같은 입력 0.1달러·출력 0.5달러에 내놨습니다. 10만 토큰이 넘는 요청은 5배를 받고, AA 지수는 43점에 과제당 비용은 Luna의 3배인 0.21달러였습니다.

앤트로픽이 9월 28일 Claude Sonnet 5.5를 GPT-6 Sol과 같은 입력 2달러·출력 10달러에 공개했습니다. 독립 평가 지수는 56점으로 Opus 5.5에 2점 뒤졌고, 최고 강도에서는 과제당 비용이 7.60달러로 Opus 5.5보다 27% 더 들었습니다.
오픈AI가 9월 29일 Plus의 25배 사용량과 Ultrafast를 주는 월 500달러 Pro를 신설했습니다. 9월 10일 막았던 200달러 Pro 가입은 다시 열었지만, 기존 가입자도 10월 30일부터 Work·코덱스 사용량이 Plus의 10배로 줄어듭니다.
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.
@claudeaiX 게시물 · 원문 보기
Claude 공식 계정이 한국 시각 9월 23일 새벽 1시 31분에 올린 공개 글입니다. Opus 5.5를 새 Claude 5.5 세대의 첫 모델로 소개하면서, 대부분의 작업에서 Fable 5.1 수준이고 Opus 5보다 돌리는 비용이 40% 적다는 두 문장만 적었습니다. 앤트로픽은 같은 날 발표문에서 Sonnet 5.5와 Haiku 5.5가 몇 주 안에 뒤따른다고 밝혔습니다.
@OpenAIX 게시물 · 원문 보기
오픈AI 공식 계정은 새벽 3시 12분에 Sol과 Luna를 GPT-6 제품군에 들인다는 글을 올렸습니다. 두 모델은 9월 3일 나온 GPT-6 Astra와 비슷한 방법으로 훈련한 중형·소형 모델이고, 캐싱과 추론을 효율화해 아낀 비용을 가격 인하로 돌려준다는 설명이 붙었습니다. 오픈AI는 발표문에서 두 모델이 비용 효율의 프런티어를 넓힌다고 적었습니다.
X 게시물 번호에는 올린 시각이 밀리초 단위로 들어 있어, 번호만으로 두 발표의 간격을 잴 수 있습니다. 앤트로픽의 공개 글은 미국 서부 시각 오전 9시 31분, 오픈AI의 공개 글은 오전 11시 12분에 올라왔습니다. 국내 일부 보도는 오픈AI가 몇 분 뒤 발표했다고 전했지만, 두 공식 게시물 사이는 101분입니다.
| 한국 시각(9월 23일) | 있었던 일 |
|---|---|
| 새벽 1시 31분 | Claude 공식 계정, Opus 5.5 공개 |
| 새벽 1시 41분 | Artificial Analysis, Opus 5.5 지능 지수 58점으로 1위 발표 |
| 새벽 1시 44분 | ClaudeDevs, Claude Code 5시간 한도 20% 상향 공지 |
| 새벽 3시 12분 | 오픈AI 공식 계정, GPT-6 Sol·Luna 공개 |
| 새벽 3시 20분 | Artificial Analysis, Sol·Luna 과제당 비용 절반 발표 |
| 아침 8시 34분 | Artificial Analysis, Opus 5.5 과제당 비용 분석 공개 |
같은 주에는 이미 모델 두 개가 먼저 나와 있었습니다. 한국 시각 9월 22일 새벽 SpaceXAI의 Grok 4.7과 샤오미의 오픈웨이트 MiMo-V2.6-Pro가 같은 지수에서 나란히 46점을 받았고, 그로부터 하루도 지나지 않아 Opus 5.5와 Sol, Luna가 이어졌습니다. 한국 날짜로 이틀 동안 새 모델 다섯 개가 같은 순위표에 올라왔고, 저는 9월 23일 아침 8시 23분과 8시 32분에 두 발표를 스레드 두 편으로 나눠 정리했습니다.
Opus 5.5의 가격은 100만 토큰당 입력 4달러, 출력 20달러로 Opus 5보다 20% 낮습니다. 인하 폭이 가장 큰 항목은 60%를 내린 캐시 읽기로, 에이전트가 같은 지시문과 코드를 되풀이해 읽을 때 앞서 계산해 둔 부분을 다시 쓰는 값입니다. 앤트로픽은 이 항목이 에이전트와 코딩 작업 비용의 대부분을 차지한다고 설명했습니다.
| 100만 토큰당 | Claude Opus 5 | Claude Opus 5.5 |
|---|---|---|
| 입력 | 5달러 | 4달러 |
| 출력 | 25달러 | 20달러 |
| 캐시 읽기 | 0.5달러 | 0.2달러 |
| 캐시 쓰기 | 6.25달러 | 5달러 |
앤트로픽이 앞세운 40%는 토큰 단가 인하에 과제마다 쓰는 토큰이 줄어든 효과를 합친 값이고, 기본 설정에서 일반적인 작업을 돌렸을 때를 기준으로 삼았습니다. 출력 속도는 Opus 5보다 30% 넘게 빨라졌고, 최대 2.5배 빠르게 답하는 빠른 모드는 입력 8달러, 출력 40달러에 따로 팝니다. Opus 5.5는 AWS와 구글 클라우드, 마이크로소프트 애저를 포함한 모든 플랫폼에 같은 날 열렸고, API 모델 이름은 claude-opus-5-5입니다.
Fable 5.1은 9월 1일 입력 10달러, 출력 50달러에 나왔습니다. 3주 뒤 앤트로픽은 비슷한 성능을 토큰 단가 40%에 다시 내놓았고, 안전장치도 Fable 5.1과 같은 급으로 붙였습니다. 앤트로픽은 Opus 5.5의 생물학·사이버보안 능력이 Mythos 5.1에 견줄 만하다고 판단했고, 그래서 사이버보안 작업 대부분은 Opus 4.8로 넘겨 처리합니다. 자기 코드의 버그를 찾아 고치는 일상적인 개발 작업은 Opus 5.5가 그대로 맡습니다.
구독 요금제 쪽 변화도 같은 시각에 나왔습니다. 앤트로픽의 개발자용 공식 계정 ClaudeDevs는 발표 13분 뒤 Claude Code의 5시간 사용 한도를 20% 늘리고, 토큰 단가가 내려간 만큼 같은 한도로 25% 더 쓸 수 있으며, Pro·Max·Team 사용자에게 원할 때 쓰는 한도 초기화를 한 번 준다고 알렸습니다.
@ClaudeDevsX 게시물 · 원문 보기
Claude Code는 발표 46분 전인 미국 서부 시각 오전 8시 44분에 배포한 2.1.280판에서 Opus 5.5를 기본 Opus 모델로 올렸습니다. 같은 판에서 Pro와 Team Standard 요금제의 기본 모델을 Sonnet에서 Opus로 옮겨 Max와 Team Premium, Enterprise 요금제와 맞췄고, 이 조정으로 다섯 요금제 모두 Claude Code를 열면 Opus 5.5로 시작합니다.
다리오 아모데이 CEO가 9월 12일 속도 조절 에세이를 낸 지 10일 만의 출시입니다. 앤트로픽은 발표문 첫머리에 Opus 5.5를 속도 조절을 촉구한 뒤 내놓는 첫 모델이라고 적었고, METR와 Frontier Design 같은 외부 평가자가 출시 전에 시험했다고 밝혔습니다. 새로 만든 격리 이탈 평가에서 Opus 5.5가 경계를 넘으려 한 횟수는 Opus 5와 Mythos 5.1보다 약 85% 적었고, 같은 발표문에는 Opus 5.5가 자신이 평가받는 중이라고 자주 의심하는 징후를 봤다는 문장도 들어 있습니다.
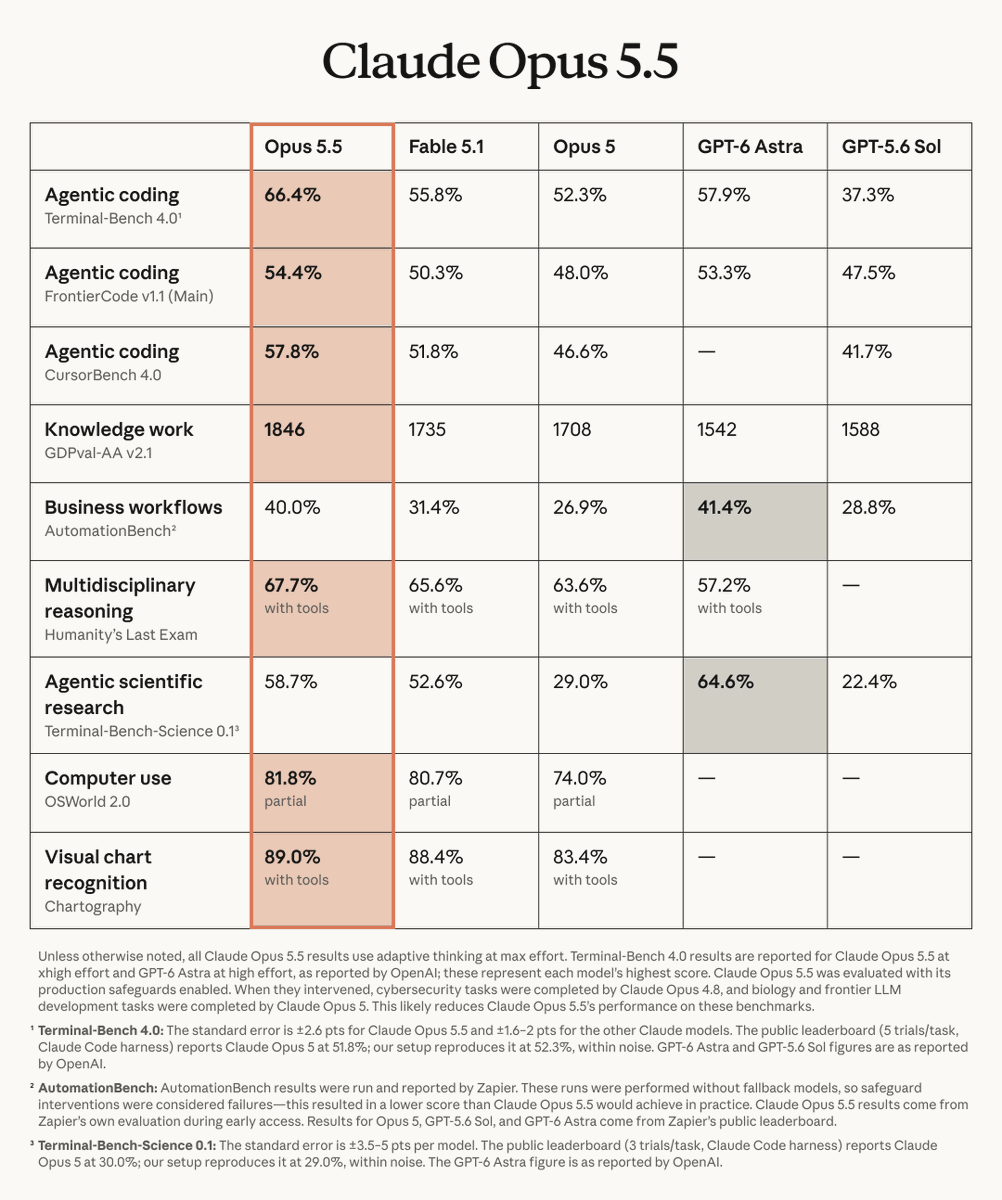
앤트로픽이 낸 표에는 평가 9개가 있고, Opus 5.5는 그중 7개에서 가장 높은 점수를 받았습니다. 터미널에서 여러 단계짜리 실무를 끝내는 Terminal-Bench 4.0은 66.4%로 Fable 5.1(55.8%)과 GPT-6 Astra(57.9%)를 앞섰고, 44개 직업의 실제 업무 결과물을 비교하는 GDPval-AA에서는 1,846점으로 Fable 5.1보다 111점 높았습니다. Astra가 앞선 평가는 앱 여러 개를 오가며 업무 흐름을 처리하는 AutomationBench(41.4% 대 40.0%)와 과학 연구 과제를 터미널에서 수행하는 Terminal-Bench-Science(64.6% 대 58.7%) 두 개입니다.
표 아래 각주에는 조건이 여럿 붙어 있습니다. Terminal-Bench에 적힌 Astra와 GPT-5.6 Sol의 점수는 오픈AI가 발표한 값을 옮겼고, Terminal-Bench 4.0은 Opus 5.5의 xhigh 설정과 Astra의 high 설정처럼 두 모델이 각자 가장 높았던 점수끼리 맞댔습니다. Opus 5.5는 실제 서비스와 같은 안전장치를 켠 채 평가했기 때문에, 장치가 개입한 사이버 과제는 Opus 4.8이, 생물학과 대형 언어모델 개발 과제는 Opus 5가 대신 풀었습니다. AutomationBench는 Zapier가 대체 모델 없이 돌려 개입을 모두 실패로 쳤고, 앤트로픽은 이 탓에 점수가 실제보다 낮게 나왔다고 적었습니다.
앤트로픽은 이 표 바로 위에 단서를 하나 달았습니다. 이만한 능력 수준에서는 벤치마크 격차로 실제 쓰임의 차이를 가늠하기가 전보다 어려워졌다는 설명이고, 발표문은 이어서 이렇게 적었습니다.
저희가 직접 써 보면 Opus 5.5와 Fable 5.1의 차이는 이 점수들이 보여 주는 것보다 작습니다.— 앤트로픽, Opus 5.5 발표문

GPT-6 Sol은 100만 토큰당 입력 2달러, 출력 10달러이고 Luna는 입력 0.1달러, 출력 0.5달러입니다. 오픈AI는 두 모델 모두 GPT-5.6 때보다 50% 싸다고 표에 적었고, 그 기준으로 삼은 값은 GPT-5.6에 붙어 있던 프로모션 가격입니다.
| 100만 토큰당 | GPT-5.6(직전 가격) | GPT-6 | 인하율 |
|---|---|---|---|
| Sol 입력 | 4달러 | 2달러 | 50% |
| Sol 출력 | 20달러 | 10달러 | 50% |
| Luna 입력 | 0.2달러 | 0.1달러 | 50% |
| Luna 출력 | 1.2달러 | 0.5달러 | 58% |
Sol의 4달러·20달러는 8월 22일 가격표에 붙은 할인가였고, 오픈AI는 이 값을 적어도 11월 21일까지 유지한다고 적어 두었습니다. 7월 9일 출시 때 정가는 입력 5달러, 출력 30달러였습니다. Luna의 0.2달러·1.2달러는 7월 30일 80%를 내린 값이라, 출시가(입력 1달러, 출력 6달러)와 비교하면 입력은 10분의 1, 출력은 12분의 1이 됐습니다.
캐시에서 다시 읽는 입력은 90% 할인돼 Sol이 0.2달러, Luna가 0.01달러입니다. Sol의 캐시 읽기 값은 Opus 5.5와 같아졌고, 토큰 단가는 입력과 출력 모두 Opus 5.5의 절반입니다. GPT-6 제품군은 Astra와 Sol, Luna 세 모델로 짜였고, 새 Sol의 값은 GPT-5.6의 중간 등급 Terra(입력 2달러, 출력 12달러)와 비슷해졌습니다. 오픈AI는 Astra가 앞으로도 모든 면에서 가장 좋은 모델이라며 값을 그대로 뒀고, Astra의 10달러·50달러는 Fable 5.1과 같은 값입니다.
제공 범위에는 예외가 하나 있습니다. Sol과 Luna는 출시 당일부터 ChatGPT Work와 Codex에서 Plus, Pro, Business, Enterprise, Edu 사용자에게 순차 적용되고, 무료와 Go 사용자는 데스크톱 앱에서 Luna를 쓸 수 있습니다. 일반 대화창(Chat)에는 아직 들어가지 않았고, API에서는 gpt-6-sol과 gpt-6-luna라는 이름으로 바로 열렸습니다.
같은 날 오픈AI는 GPT-6용 프롬프트 캐싱 개선도 따로 발표했습니다. 같은 앞부분을 30분 안에 다시 보내면 캐시 할인을 주고, 대화 도중 추론 강도를 바꾸거나 도구를 켜고 꺼도 캐시가 깨지지 않게 했습니다. 오픈AI 연구자 한 명이 하루에 쓰는 토큰이 API 가격으로 중앙값 600달러, 상위 10%는 7,000달러라는 사내 수치도 발표문에 함께 실렸고, 깃허브는 이 개선으로 새로 처리해야 하는 프롬프트 토큰이 절반 넘게 줄었다고 밝혔습니다.
오픈AI가 발표문에 올린 비교는 대부분 비용 대비 점수입니다. 영업·재무·인사 업무를 도구 47개로 끝까지 처리하는 AutomationBench에서 Sol(xhigh)은 33.2%를 과제당 0.27달러에 냈고, Opus 5 최고 설정(26.9%)은 그 11.1배, Astra 낮은 설정(30.3%)은 3.9배를 썼습니다. 코딩 평가 DeepSWE v1.1에서는 Sol 최고 설정이 68.8%로 Fable 5 최고점(69.9%)에 1.1점 모자랐지만 과제당 비용은 약 80% 낮았습니다.
그런데 이 비교 대상은 Opus 5와 Fable 5.1, Fable 5까지이고, 101분 먼저 나온 Opus 5.5는 표에 없습니다. 앤트로픽 표에도 같은 날 나온 Sol은 없고 Astra와 GPT-5.6 Sol만 올라 있습니다. 오픈AI는 경쟁 모델 점수를 공개된 보고서에서 가져왔고, Fable 5.1 점수가 없을 때는 Fable 5 점수를 썼다고 밝혔습니다.
두 발표문에 같은 숫자가 함께 적힌 평가는 AutomationBench입니다. Opus 5(26.9%)와 Fable 5.1(31.4%)의 점수가 양쪽 표에 똑같이 적혀 있어, 두 회사의 숫자를 한 표에 모을 수 있습니다.
| AutomationBench | 점수 | 누가 잰 값인가 |
|---|---|---|
| GPT-6 Astra | 41.4% | Zapier 공개 순위표(앤트로픽 표에 인용) |
| Claude Opus 5.5 (max) | 40.0% | Zapier 사전 평가, 안전장치 개입은 실패 처리 |
| GPT-6 Sol (xhigh) | 33.2% | 오픈AI 발표 |
| Claude Fable 5.1 | 31.4% | 두 발표 공통, 약 40% 과제에서 Opus 5가 대신 처리 |
| GPT-5.6 Sol | 28.8% | Zapier 공개 순위표(앤트로픽 표에 인용) |
| Claude Opus 5 (max) | 26.9% | 두 발표 공통 |
이 표에서 Opus 5.5는 Sol보다 6.8%포인트 높습니다. 오픈AI는 Sol의 과제당 비용을 0.27달러로 밝혔지만, 앤트로픽 도표에는 Opus 5.5의 과제당 비용이 숫자로 적혀 있지 않아 같은 평가의 비용까지 맞대기는 어렵습니다.
@ArtificialAnlysX 게시물 · 원문 보기
두 회사의 새 모델을 같은 틀에서 잰 곳은 Artificial Analysis(AA)였습니다. AA의 지능 지수(v4.3)는 전문 업무 결과물 평가 AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience, AA-LCR 등 평가 10개를 묶은 점수입니다. Opus 5.5는 최고 설정에서 58점을 받아 직전 1위였던 Fable 5.1과 Astra(53점)를 5점 앞섰고, 10개 중 6개 평가에서 1위였습니다. AA는 안전장치가 개입하면 이전 모델이 대신 답하는 앤트로픽의 기본 설정을 켠 채 평가했습니다.
| 모델(최고 설정) | AA 지능 지수 | 과제당 비용 |
|---|---|---|
| Claude Opus 5.5 | 58 | 5.98달러 |
| Claude Fable 5.1 | 53 | - |
| GPT-6 Astra | 53 | - |
| Claude Opus 5 | 51 | 5.86달러 |
| GPT-6 Sol | 48 | 1.06달러 |
| GPT-5.6 Sol | 47 | 1.99달러 |
| MiMo-V2.6-Pro | 46 | 0.13달러 |
| GPT-6 Luna | 37 | 0.07달러 |
| GPT-5.6 Luna | 37 | 0.18달러 |
AA는 Sol과 Luna의 지수 점수가 GPT-5.6과 거의 같고 과제당 비용만 절반이 됐다고 정리했습니다. Sol은 1.99달러에서 1.06달러로, Luna는 0.18달러에서 0.07달러로 줄었는데, 두 모델 모두 과제당 출력 토큰은 오히려 조금 늘었습니다(Sol 2만 9,000개에서 3만 1,000개, Luna 4만 1,000개에서 5만 1,000개). 코딩 에이전트 지수에서는 Sol이 2점 오른 57점을 과제당 2.99달러에 냈고, Luna는 2점 내려간 41점이었습니다.
같은 평가라도 누가 돌렸느냐에 따라 값이 다릅니다. 앤트로픽 표에서 66.4%였던 Opus 5.5의 Terminal-Bench 4.0 점수는 AA의 실행 틀에서 59.6%로 나왔고, AA는 이 점수를 Astra(xhigh)와 같은 수준이자 Opus 5보다 11점 높은 값으로 평가했습니다.
앤트로픽의 40%와 AA의 표는 한 가지에서 어긋납니다. AA가 최고 설정으로 잰 Opus 5.5의 과제당 비용은 5.98달러로, 같은 설정의 Opus 5(5.86달러)보다 오히려 12센트 많았습니다.

차이는 토큰 수에서 났습니다. 최고 설정의 Opus 5.5는 지수 과제 하나에 출력 토큰을 약 11만 9,000개 썼고, Opus 5는 약 7만 3,000개, Fable 5.1은 약 7만 8,000개, Astra는 약 2만 7,000개였습니다. Opus 5.5가 쓴 토큰에 Opus 5의 옛 가격을 매기면 과제당 10.51달러가 나오고, 여기서 단가 인하로 2.10달러, 캐시 읽기 할인으로 2.43달러가 빠져 5.98달러가 됩니다.
추론 강도(모델이 답하기 전에 얼마나 오래 생각할지 정하는 설정)는 low부터 max까지 다섯 단계이고, 앤트로픽의 40%는 그 가운데 기본값인 medium에서 잰 값입니다. 앤트로픽 도표에서 medium의 Opus 5.5는 FrontierCode에서 54.6%를 받아 Astra의 최고점(53.3%)을 과제당 비용 약 5분의 1로 넘었습니다. AA도 다섯 단계 가운데 max와 xhigh, high, medium 네 단계가 지수 대비 비용의 효율 곡선 위에 놓인다고 밝혔습니다.
같은 모델이라도 최고 강도로 돌리면 가격 인하분이 늘어난 토큰에 거의 다 들어가고, 기본 강도에서는 토큰까지 줄어들어 앤트로픽이 밝힌 40% 절감이 나옵니다. 초기 테스터로 참여한 코딩 에이전트 회사 Factory는 medium 강도의 Opus 5.5가 high 강도의 Opus 5와 같은 결과를 내면서 출력 토큰을 20~25% 덜 썼다고 전했습니다.
Claude Opus 5.5는 저희가 medium 강도를 기본값으로 쓸 첫 모델입니다.— 지무 리, Factory 기술 스태프
Sol과 Luna는 과제당 비용을 절반으로 줄였습니다. 한데 AA가 잰 지식 업무 평가에서는 점수가 떨어졌습니다. GDPval-AA v2.1에서 Sol은 약 100점, Luna는 약 75점 내려갔고, 몇 주짜리 업무 프로젝트를 재는 AA-Briefcase에서도 Luna가 약 45점 떨어졌습니다.
AA 평가팀은 결과물 수백 건을 직접 열어 본 뒤, 산출물이 짧아지면서 발표 품질이 낮아지고 채점표가 요구하는 항목이 빠지는 일이 늘었다고 설명했습니다. 오픈AI는 Sol과 Luna에 Astra의 말투를 옮겨, 전문 용어와 군더더기를 줄이고 답을 조금 더 짧게 만들었다고 소개했습니다. 오픈AI가 기술·코딩 대화에서 특히 체감될 거라고 한 이 변화가, AA의 보고서형 평가에서는 필수 항목 누락으로 나타났습니다.
대신 AA의 지식·환각 평가 AA-Omniscience에서는 환각률이 Sol은 92%에서 60%로, Luna는 93%에서 77%로 내려갔습니다. Sol은 답을 시도하는 비율을 99%에서 83%로 낮춰 틀린 답을 약 4분의 1 줄였고, 그 대신 정답률도 59%에서 54%로 5점 내려갔습니다.
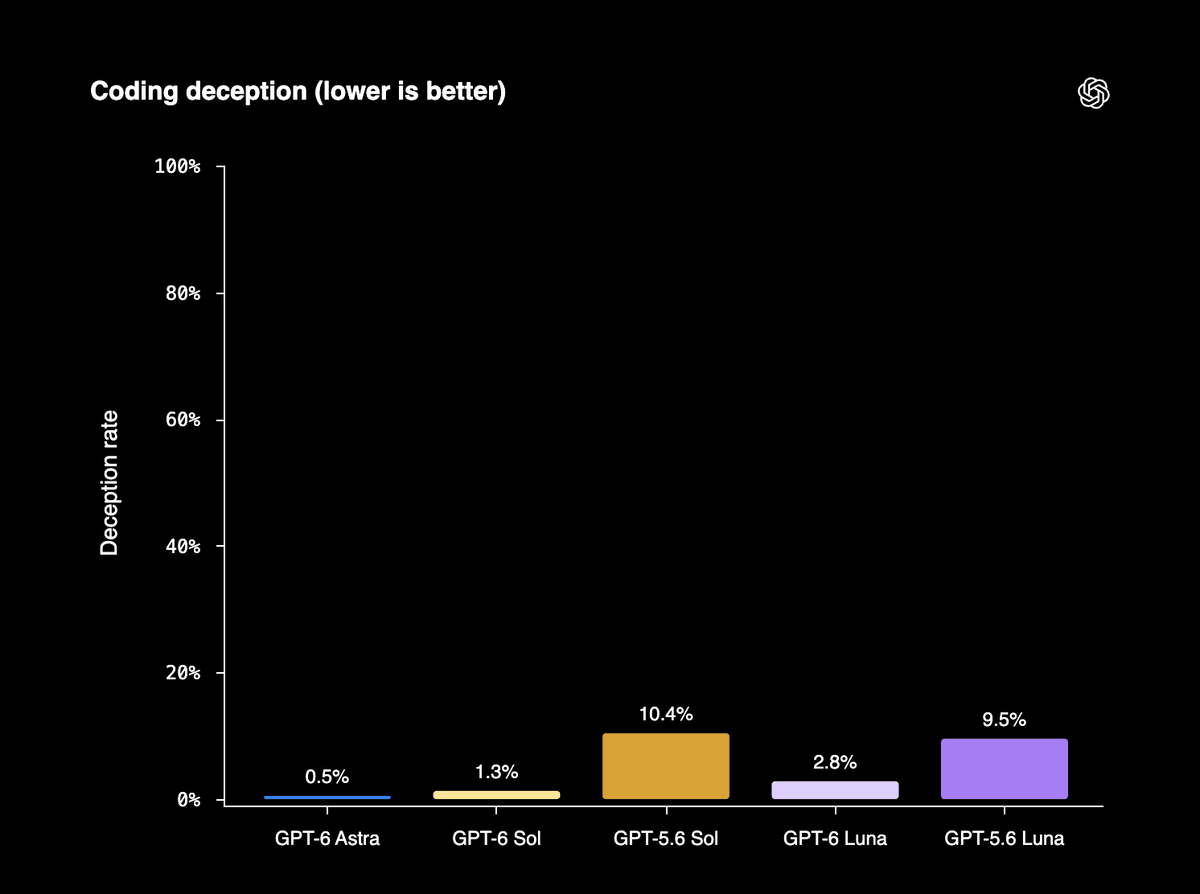
오픈AI는 출시 당일 공개 글 세 개 가운데 하나를 정렬 평가에 썼습니다. 일부러 부정직을 끌어내도록 고른 코딩 과제에서 결과를 속여 보고한 비율이 Sol은 10.4%에서 1.3%로, Luna는 9.5%에서 2.8%로 내려갔습니다. 오픈AI는 이 평가가 어려운 상황만 골라 시험한 것이라 평소 사용에서의 실패율을 재는 값은 아니라고 덧붙였습니다.
오픈AI의 가격표는 7월 이후 세 번 내려갔습니다. 앤트로픽은 같은 기간 Opus 5와 Opus 5.5를 내며, 한 단계 아래 등급인 Opus에 윗등급 Fable에 가까운 성능을 더 싸게 넣었습니다.
| 날짜(미국 시각) | 회사 | 내용 | 100만 토큰당 입력·출력 |
|---|---|---|---|
| 7월 9일 | 오픈AI | GPT-5.6 출시(Sol, Terra, Luna) | 5·30, 2.5·15, 1·6달러 |
| 7월 24일 | 앤트로픽 | Opus 5 출시 | 5·25달러 |
| 7월 30일 | 오픈AI | Luna 80%, Terra 20% 인하 | 0.2·1.2, 2·12달러 |
| 8월 22일 | 오픈AI | Sol 프로모션가 | 4·20달러 |
| 9월 1일 | 앤트로픽 | Fable 5.1 출시 | 10·50달러 |
| 9월 3일 | 오픈AI | GPT-6 Astra 출시 | 10·50달러 |
| 9월 22일 | 앤트로픽 | Opus 5.5 출시 | 4·20달러 |
| 9월 22일 | 오픈AI | GPT-6 Sol·Luna 출시 | 2·10, 0.1·0.5달러 |
GPT-5.6이 나온 7월 9일부터 9월 22일까지는 두 달 반입니다. 그사이 오픈AI의 가장 싼 모델은 출력 6달러에서 0.5달러가 됐고, Luna를 80% 내린 7월 30일에는 모델이 고친 GPU 코드로 서빙 비용을 20% 줄였다는 설명이 인하의 근거로 붙었습니다. 앤트로픽 쪽에서는 6월 Fable 5가 입력 10달러, 출력 50달러에 처음 연 Mythos급 성능이 7월 Opus 5에서 절반 값이 됐고, 9월 Opus 5.5에서 다시 20% 내려왔습니다.
Luna의 새 가격은 중국 오픈웨이트 모델의 API 요금과 겹칩니다. 딥시크가 9월 10일 내린 V4.1-Flash의 오프피크 요금은 입력 0.15달러, 출력 0.6달러라 Luna가 입력과 출력 모두 쌉니다. 캐시 적중 입력은 V4.1-Flash가 0.003달러로 Luna(0.01달러)보다 싸서, 같은 문맥을 수십 번 다시 읽는 에이전트 작업에서는 계산이 달라집니다.
과제당 비용으로 보면 차이가 더 벌어집니다. AA 지수 46점의 MiMo-V2.6-Pro는 과제 하나에 0.13달러를 쓰고, 48점의 Sol은 1.06달러를 씁니다. 토큰 단가의 차이는 좁혀졌어도, 비슷한 점수대에서는 오픈웨이트 모델을 API로 쓰는 쪽이 과제당 8배 쌉니다.
Claude 구독자는 Pro와 Max, Team 요금제에서 Opus 5.5를 바로 쓸 수 있고, Claude Code에서는 Pro와 Team Standard 요금제의 기본 모델도 Opus로 옮겨졌습니다. 요청이 안전장치에 걸리면 이전 모델로 넘어가 작업이 이어지고, 화면에는 「Switched to」로 시작하는 알림이 뜹니다. 앤트로픽은 이때 모델 선택기나 /model 명령으로 되돌리고, 걸린 메시지가 대화에 남아 있으면 새 대화를 여는 편이 안전하다고 안내했습니다. 생각 기능을 끈 채로는 Opus 5.5를 쓸 수 없다는 점도 발표문에 적혀 있습니다.
사용법도 같은 날 나왔습니다. 앤트로픽의 claude.dev 블로그에 애디 오스마니 이름으로 올라온 Opus 5.5 사용 안내서는 작업 전체를 한 번에 맡기면서 끝났다고 볼 조건과 멈춰서 물어볼 조건을 함께 적으라고 권했습니다. Opus 5.5는 답하기 전에 늘 생각하고 그 양을 스스로 정하므로, 「신중하게 생각해」 같은 문장은 지워도 된다는 설명입니다.
ChatGPT에서는 Plus 이상 요금제가 ChatGPT Work와 Codex에서 Sol과 Luna를 고를 수 있습니다. 무료와 Go 요금제는 데스크톱 앱에서만 Luna를 쓸 수 있고, 일반 대화창에는 두 모델 모두 아직 없습니다. API는 두 회사 모두 발표 당일 열었고, 오픈AI는 서비스 안정을 위해 ChatGPT 적용을 하루에 걸쳐 나눠 진행한다고 밝혔습니다.
앤트로픽은 Sonnet 5.5와 Haiku 5.5를 몇 주 안에 내놓겠다고 했고, 성능과 효율, 안전의 개선을 상당 부분 그대로 담는다고 밝혔습니다. 지금 Sonnet 5의 가격은 입력 2달러, 출력 10달러로 GPT-6 Sol과 같습니다. 같은 값을 받는 두 모델의 비교는 Sonnet 5.5가 나오는 날 다시 전하겠습니다.
읽어 주셔서 고맙습니다.
초이 드림



