
Terminal-Bench
터미널 벤치
터미널에서 여러 단계를 이어 수행하는 긴 작업을 재는 평가입니다. 단발 코드 생성과 달리 도구 사용과 오류 복구까지 포함해서, 에이전트 성능을 비교할 때 자주 인용됩니다.
‘Terminal-Bench’ 이 나오는 글8
Grok 4.7, 코딩 지수 9점 오를 때 종합은 2점, 과제당 비용은 2배
Grok Build에서 잰 Terminal-Bench 4.0 통과율이 17.7%에서 33.3%로 뛰었습니다. 같은 단가에 AA 지능 지수 과제 하나를 푸는 비용은 1.86달러에서 3.74달러로 늘어, 단가가 5배인 GPT-6 Astra(3.26달러)보다 많아졌습니다.
최저 설정이 전작 최고 설정을 따라잡은 Fable 5.1, 비용은 4분의 1
반값 Opus 5가 여러 평가에서 Fable 5를 앞서던 가운데, 앤트로픽이 9월 1일 Fable 5.1을 내놓고 비교표 모든 항목에서 1위를 되찾았습니다. 캐시 읽기 요금을 75% 내려 일반 작업 비용은 약 25%, 에이전트 작업은 최대 약 45% 줄였습니다.
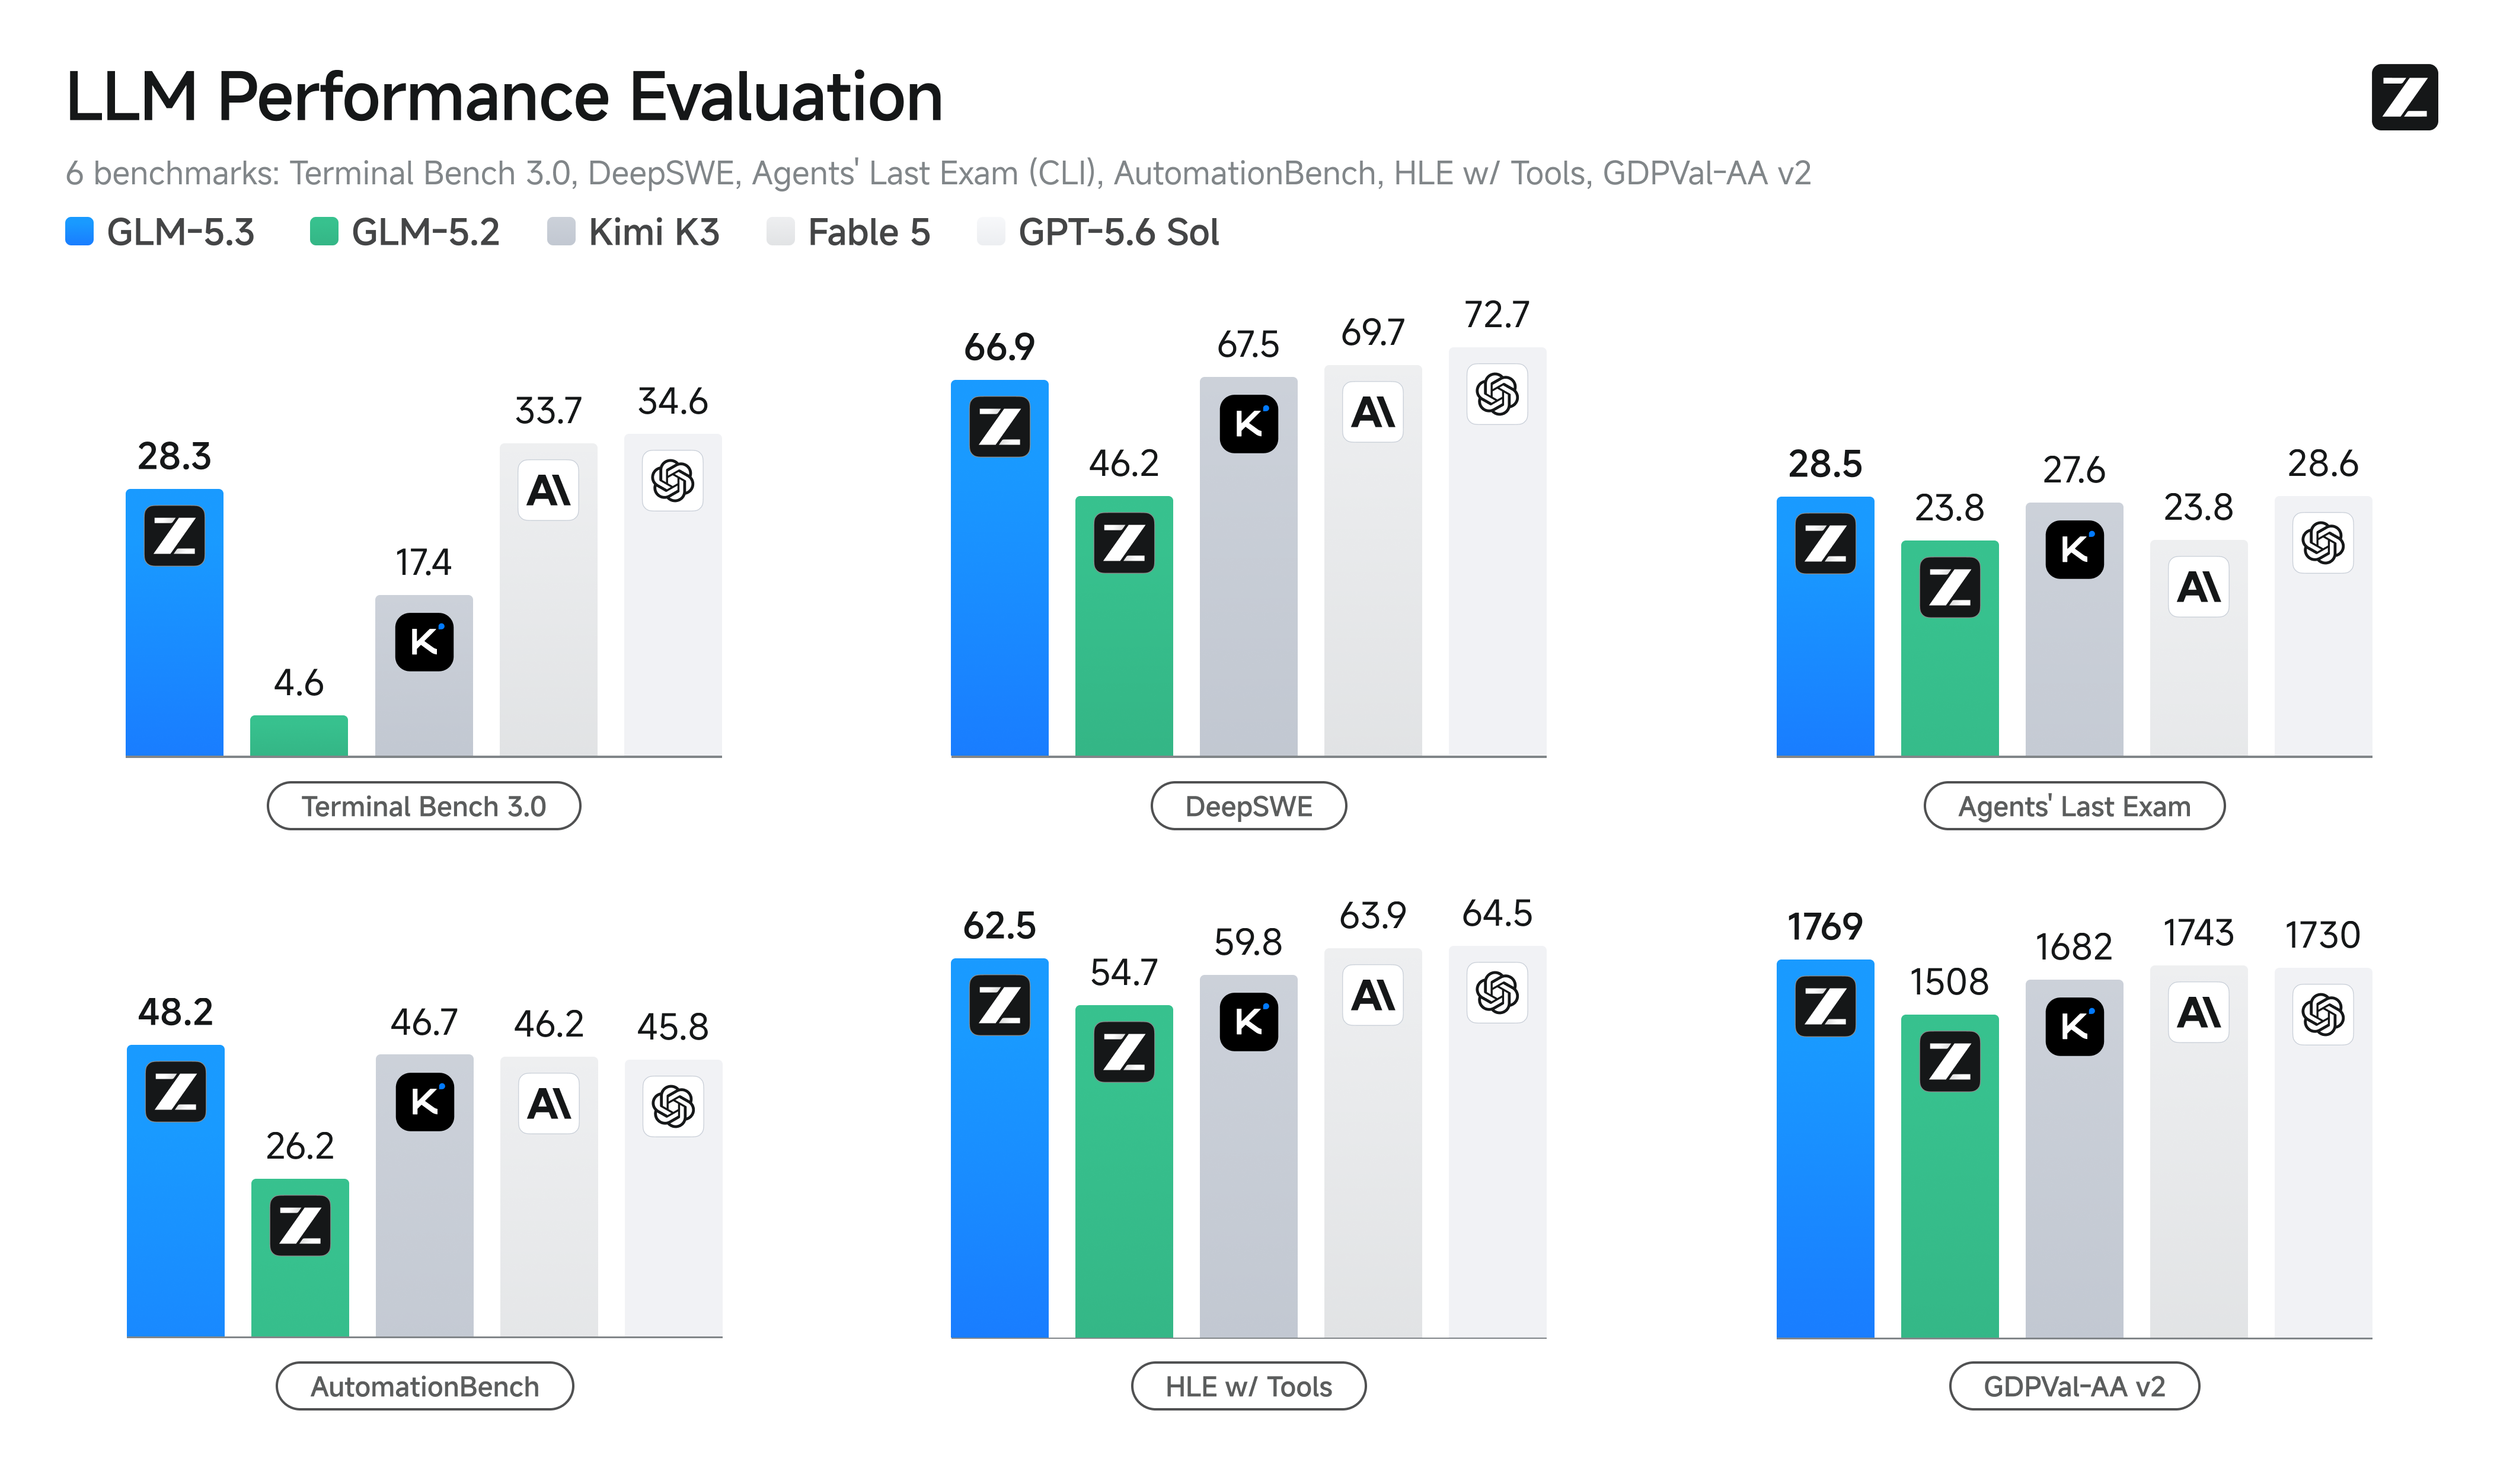
몸집은 그대로, GLM-5.3이 후속 학습만으로 터미널 점수를 6배로
Z.ai가 8월 14일 공개한 GLM-5.3은 전작과 같은 743B 기반 모델에 후속 학습만 한 달 더한 모델입니다. 코딩 에이전트 평가 DeepSWE는 46.2에서 66.9로, 취약점 탐지 CyberGym은 77.2%에서 84.5%로 올랐고, 가중치는 2주 뒤 공개하겠다고 했습니다.
자기 틀에선 6.7점, 같은 틀에선 2점, 메타 코딩 에이전트 Muse Code
메타가 8월 5일 Muse Code 베타와 Muse Spark 1.2를 내놨습니다. 메타 표에서 1.2는 Terminal-Bench 2.1 82.9%로 2위였지만, 같은 틀로 잰 독립 측정은 80.1%로 여섯 모델 중 4위였고 1.1과의 차이도 2.2점이었습니다.

한 달 실험 1만~2만 번, Poolside 칸트 "모델 회사 5곳보다 100곳"
Poolside 공동창업자 에이소 칸트가 7월 23일 Latent Space에서 연구자 70명 미만이 한 달 1만~2만 번 실험을 돌리는 모델 공장을 설명했습니다. 모델 회사가 5곳인 세상보다 100곳인 세상이 낫다며, 지금 오픈 모델을 제한하면 혁신이 다친다고 했습니다.

작은 고추가 맵다, 118B Laguna가 1.6조 딥시크를 코딩에서 앞섰습니다
Poolside가 7월 21일 공개한 Laguna S 2.1은 DeepSWE에서 40.4%를 받아 13배 큰 딥시크 V4-Pro-Max(9.0%)를 크게 앞섰습니다. DGX Spark 한 대에서 추측 디코딩 없이 초당 13~14토큰, 붙이면 최대 24토큰이 나옵니다.
함께 나오는 용어5
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 코딩 에이전트저장소를 읽고 명령을 실행하며 코드를 끝까지 고치는 에이전트입니다. 최근 모델 도약이 지식 문답 대신 이쪽에 몰려서, 딥시크 V4-Pro는 코딩 에이전트 평가 DeepSWE에서 12.8점이 62.7점이 됐습니다. 같은 모델도 어떤 하네스에 올리느냐에 따라 점수가 크게 달라집니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 하네스모델을 감싸 실제 작업을 시키는 바깥 장치입니다. 프롬프트·도구·재시도·검증 규칙이 여기 들어가서, 같은 모델도 하네스에 따라 결과가 크게 다릅니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.