
SWE-bench
SWE-bench Pro · 스위벤치
실제 깃허브 이슈를 모델이 패치로 해결하는지 재는 코딩 평가입니다. 오픈AI 감사에서 공개 과제의 약 30%가 깨진 문제로 확인되면서 점수 해석에 주의가 필요해졌습니다.
‘SWE-bench’ 이 나오는 글6
24GB 그래픽카드에 들어가는 'Opus급', 알리바바 Qwen3.8-27B
알리바바가 8월 14일 Qwen3.8-27B 가중치를 Apache 2.0으로 공개했습니다. 파라미터 수와 구조가 4월 Qwen3.6-27B와 똑같은데 DeepSWE는 13.3에서 42.2로 올랐고, 4비트 판은 24GB 그래픽카드에 들어갑니다.

80%까지 오른 코딩 시험, 오픈AI "과제 30% 깨졌다"며 추천 철회
오픈AI가 7월 8일 SWE-Bench Pro 공개 과제 731개 중 약 30%가 깨진 문제라고 추정하고 이 시험을 쓰라던 추천을 철회했습니다. 최고 점수는 8개월 남짓 만에 23.3%에서 80.3%로 올라 있었습니다.
진 점수도 실은 GPT-5.6, 같은 과제 비용은 Fable 5의 3분의 1
정부 승인 파트너 약 20곳에만 열려 있던 GPT-5.6이 7월 9일 정식 출시됐습니다. Sol은 100만 토큰당 입력 5달러·출력 30달러, Luna는 1달러·6달러입니다. 오픈AI는 Sol이 크게 진 SWE-Bench Pro 공개 과제의 약 30%가 깨진 문제라고 밝혔습니다.
Cursor와 만든 Grok 4.5, 출력 가격은 Opus 4.8의 4분의 1
SWE-Bench Pro 한 과제에 Grok 4.5는 출력 토큰 1만 5,954개, Opus 4.8은 6만 7,020개를 씁니다. CursorBench에서는 Grok 4.5가 Cursor 코드베이스의 옛 스냅샷을 학습해 유리했다고 Cursor가 직접 밝혔습니다.
모델은 그대로, 하네스만 고쳐 점수 2.5배, 릴리안 웽의 자기개선론
같은 클로드 3.5 소네트로 하네스 코드만 진화시켜 SWE-bench Verified가 20%에서 50%로 올랐습니다. 릴리안 웽은 가까운 미래의 재귀적 자기개선이 가중치보다 하네스에서 먼저 시작된다고 봤고, 평가가 느린 분야와 보상 해킹, 실패 기록을 남은 병목으로 꼽았습니다.
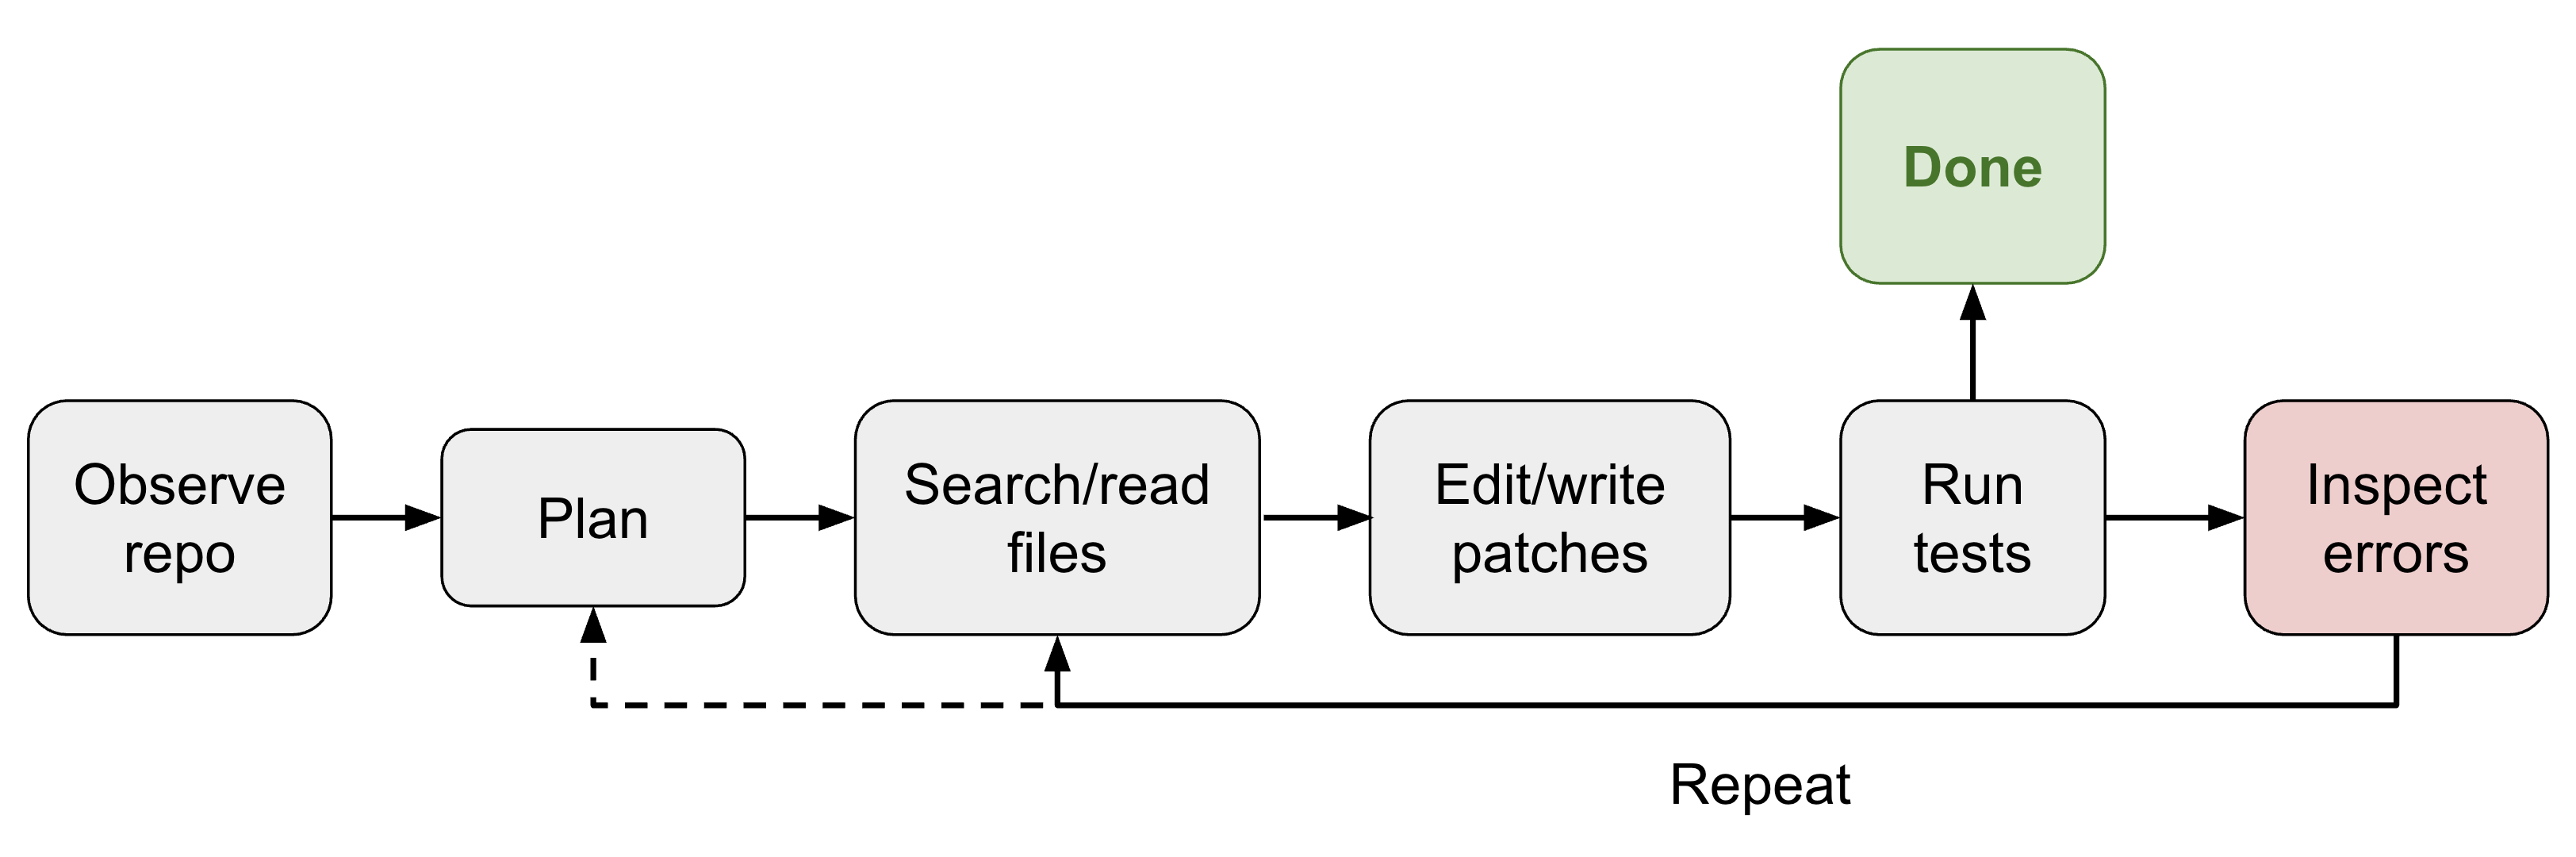
모델은 그대로 두고 SWE-bench 20%→50%, 릴리안 웽이 꺼낸 '하네스'
모델을 고정한 채 하네스만 고쳐 SWE-bench 점수가 20%에서 50%로 올랐습니다. 앤트로픽 실험에서는 단독 실행이 20분·9달러에 고장 난 게임을, 하네스가 6시간·200달러에 플레이할 수 있는 게임을 냈습니다.
함께 나오는 용어5
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 코딩 에이전트저장소를 읽고 명령을 실행하며 코드를 끝까지 고치는 에이전트입니다. 최근 모델 도약이 지식 문답 대신 이쪽에 몰려서, 딥시크 V4-Pro는 코딩 에이전트 평가 DeepSWE에서 12.8점이 62.7점이 됐습니다. 같은 모델도 어떤 하네스에 올리느냐에 따라 점수가 크게 달라집니다.
- 하네스모델을 감싸 실제 작업을 시키는 바깥 장치입니다. 프롬프트·도구·재시도·검증 규칙이 여기 들어가서, 같은 모델도 하네스에 따라 결과가 크게 다릅니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.