
추론 모델
reasoning model · 사고 모델
답을 내기 전에 중간 과정을 길게 생각하도록 학습한 모델입니다. 어려운 문제에서 정확도가 오르는 대신 응답이 느리고 토큰을 많이 씁니다.
‘추론 모델’ 이 나오는 글6
"멀티에이전트 공로는 10%도 안 된다" 밀레니엄 난제 뒤의 노암 브라운
오픈AI 연구자 노암 브라운이 9월 17일 Dwarkesh Podcast에서 에이전트 1만 개가 나비에-스토크스 문제를 푼 과정을 설명했습니다. 멀티에이전트의 기여는 10%도 안 된다고 했고, AI 연구 자동화의 가속은 3배쯤으로 봤습니다.

노엄 브라운 "AI 자기 개선이 1순위"… 박사 연구 맡긴 Astra는 실패
노엄 브라운은 9월 15일 공개된 대담에서 AI가 AI 연구를 하는 재귀적 자기 개선이 오픈AI의 1순위라고 했습니다. Astra에게 박사 연구 주제인 포커 AI를 맡겼지만 3일 동안 해내지 못했고, 발언은 Astra 공개일인 9월 3일에 녹화됐습니다.

GPT-6 공개 3일 뒤, 오픈AI 수석과학자 "안전 약속을 의무 기준으로"
오픈AI 수석과학자 야쿠프 파초키가 GPT-6 Astra 공개 3일 뒤 회사 자율 약속을 제3자·정부가 집행하는 의무 안전 기준으로 바꾸자고 썼습니다. 같은 날 오픈AI는 Astra급 GPU 배정이 59.2% 줄자 다른 모델 배정이 17.2% 늘었다고 공개했습니다.
"두뇌 하나로 어떤 로봇이든", 구글 Gemini Robotics ER 2 공개
구글 딥마인드가 7월 30일 로봇 모델 3종 Gemini Robotics 2를 발표하고, 판단을 맡는 ER 2를 Gemini API로 공개했습니다. 사람이 원격으로 몸을 대신 움직여도 성공률은 74.0%였고, 공식 연구 파트너 세 곳 가운데 보스턴다이내믹스의 최대주주는 현대차그룹입니다.

"2025년 AGI를 믿었다" 오픈AI 추론 이끈 트워렉, 트랜스포머 대체에 나서
오픈AI 추론 팀을 이끈 제리 트워렉과 제미나이 사전학습을 이끈 로한 아닐이 7월 29일 세쿼이아 팟캐스트에 나왔습니다. 트랜스포머로는 배포 뒤에도 계속 배우는 모델을 만들 수 없다며, 연구를 자동화해 대체 구조를 찾겠다고 했습니다.
같은 말 되풀이하던 추론 모델, 리퀴드AI가 토큰 하나 고쳐 반복률 1%대로
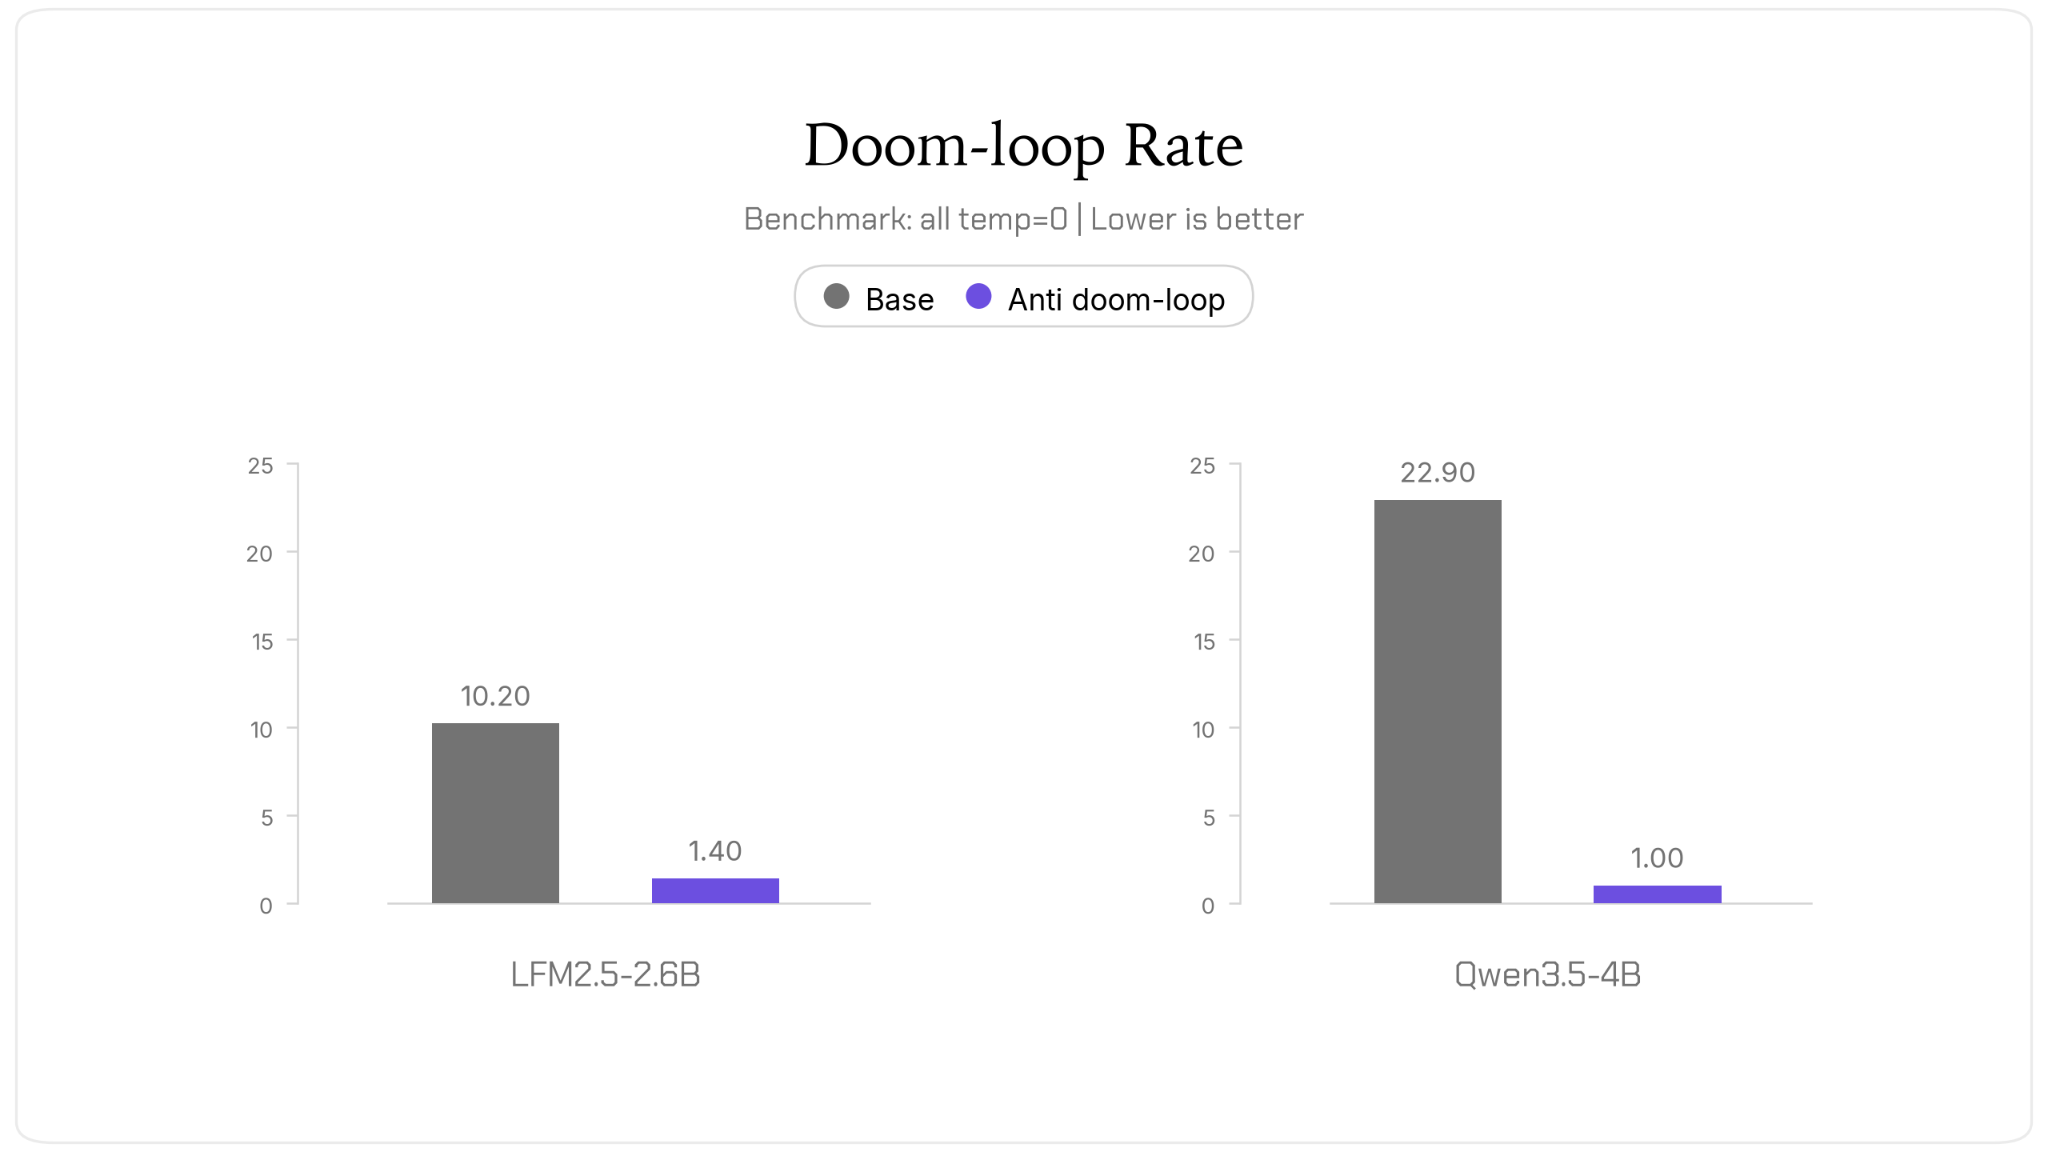
리퀴드AI가 7월 7일 공개한 Antidoom은 루프를 여는 첫 토큰 하나만 다시 학습시켜 Qwen3.5-4B의 반복률을 22.9%에서 1%로 낮췄습니다. 온도 0의 평균 점수는 약 59점에서 72점으로 올랐습니다.
함께 나오는 용어5
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 재귀적 자기개선AI가 다음 세대 AI를 만드는 일을 스스로 맡아, 개선 속도가 사람 손을 떠나 점점 빨라지는 상태입니다. 아직 일어나지 않았지만 여러 연구소가 이걸 기준으로 안전 정책을 세웁니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 정렬모델의 행동을 사람이 의도한 목표·가치에 맞추는 일입니다. 유해한 답 거부, 지시 따르기, 속이지 않기가 모두 정렬 문제입니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.