
추론 강도
reasoning effort · effort
모델이 과제에 얼마나 많은 계산과 검증을 쓰도록 할지 조절하는 설정입니다. 높은 값은 토큰 사용량과 실행 시간을 늘릴 수 있지만 정답을 보장하지 않습니다. 지원 단계와 적용 범위는 모델·제품별로 다릅니다.
‘추론 강도’ 이 나오는 글9
프롬프트 66% 지워 7% 아낀 Cursor, 검증에 토큰 3배 쓴 Claude
Cursor가 9월 23일 시스템 프롬프트 66%를 지우고 도구 설명을 필요할 때만 불러와 토큰 비용을 7% 줄였습니다. 이틀 뒤 Claude Code 팀은 추론 설정을 올리면 토큰은 3배, 통과는 1.5배가 된다는 실험을 냈습니다.
딥시크 "V4.1-Flash가 V4-Pro 앞서"… MIT 공개하고 요금 인하
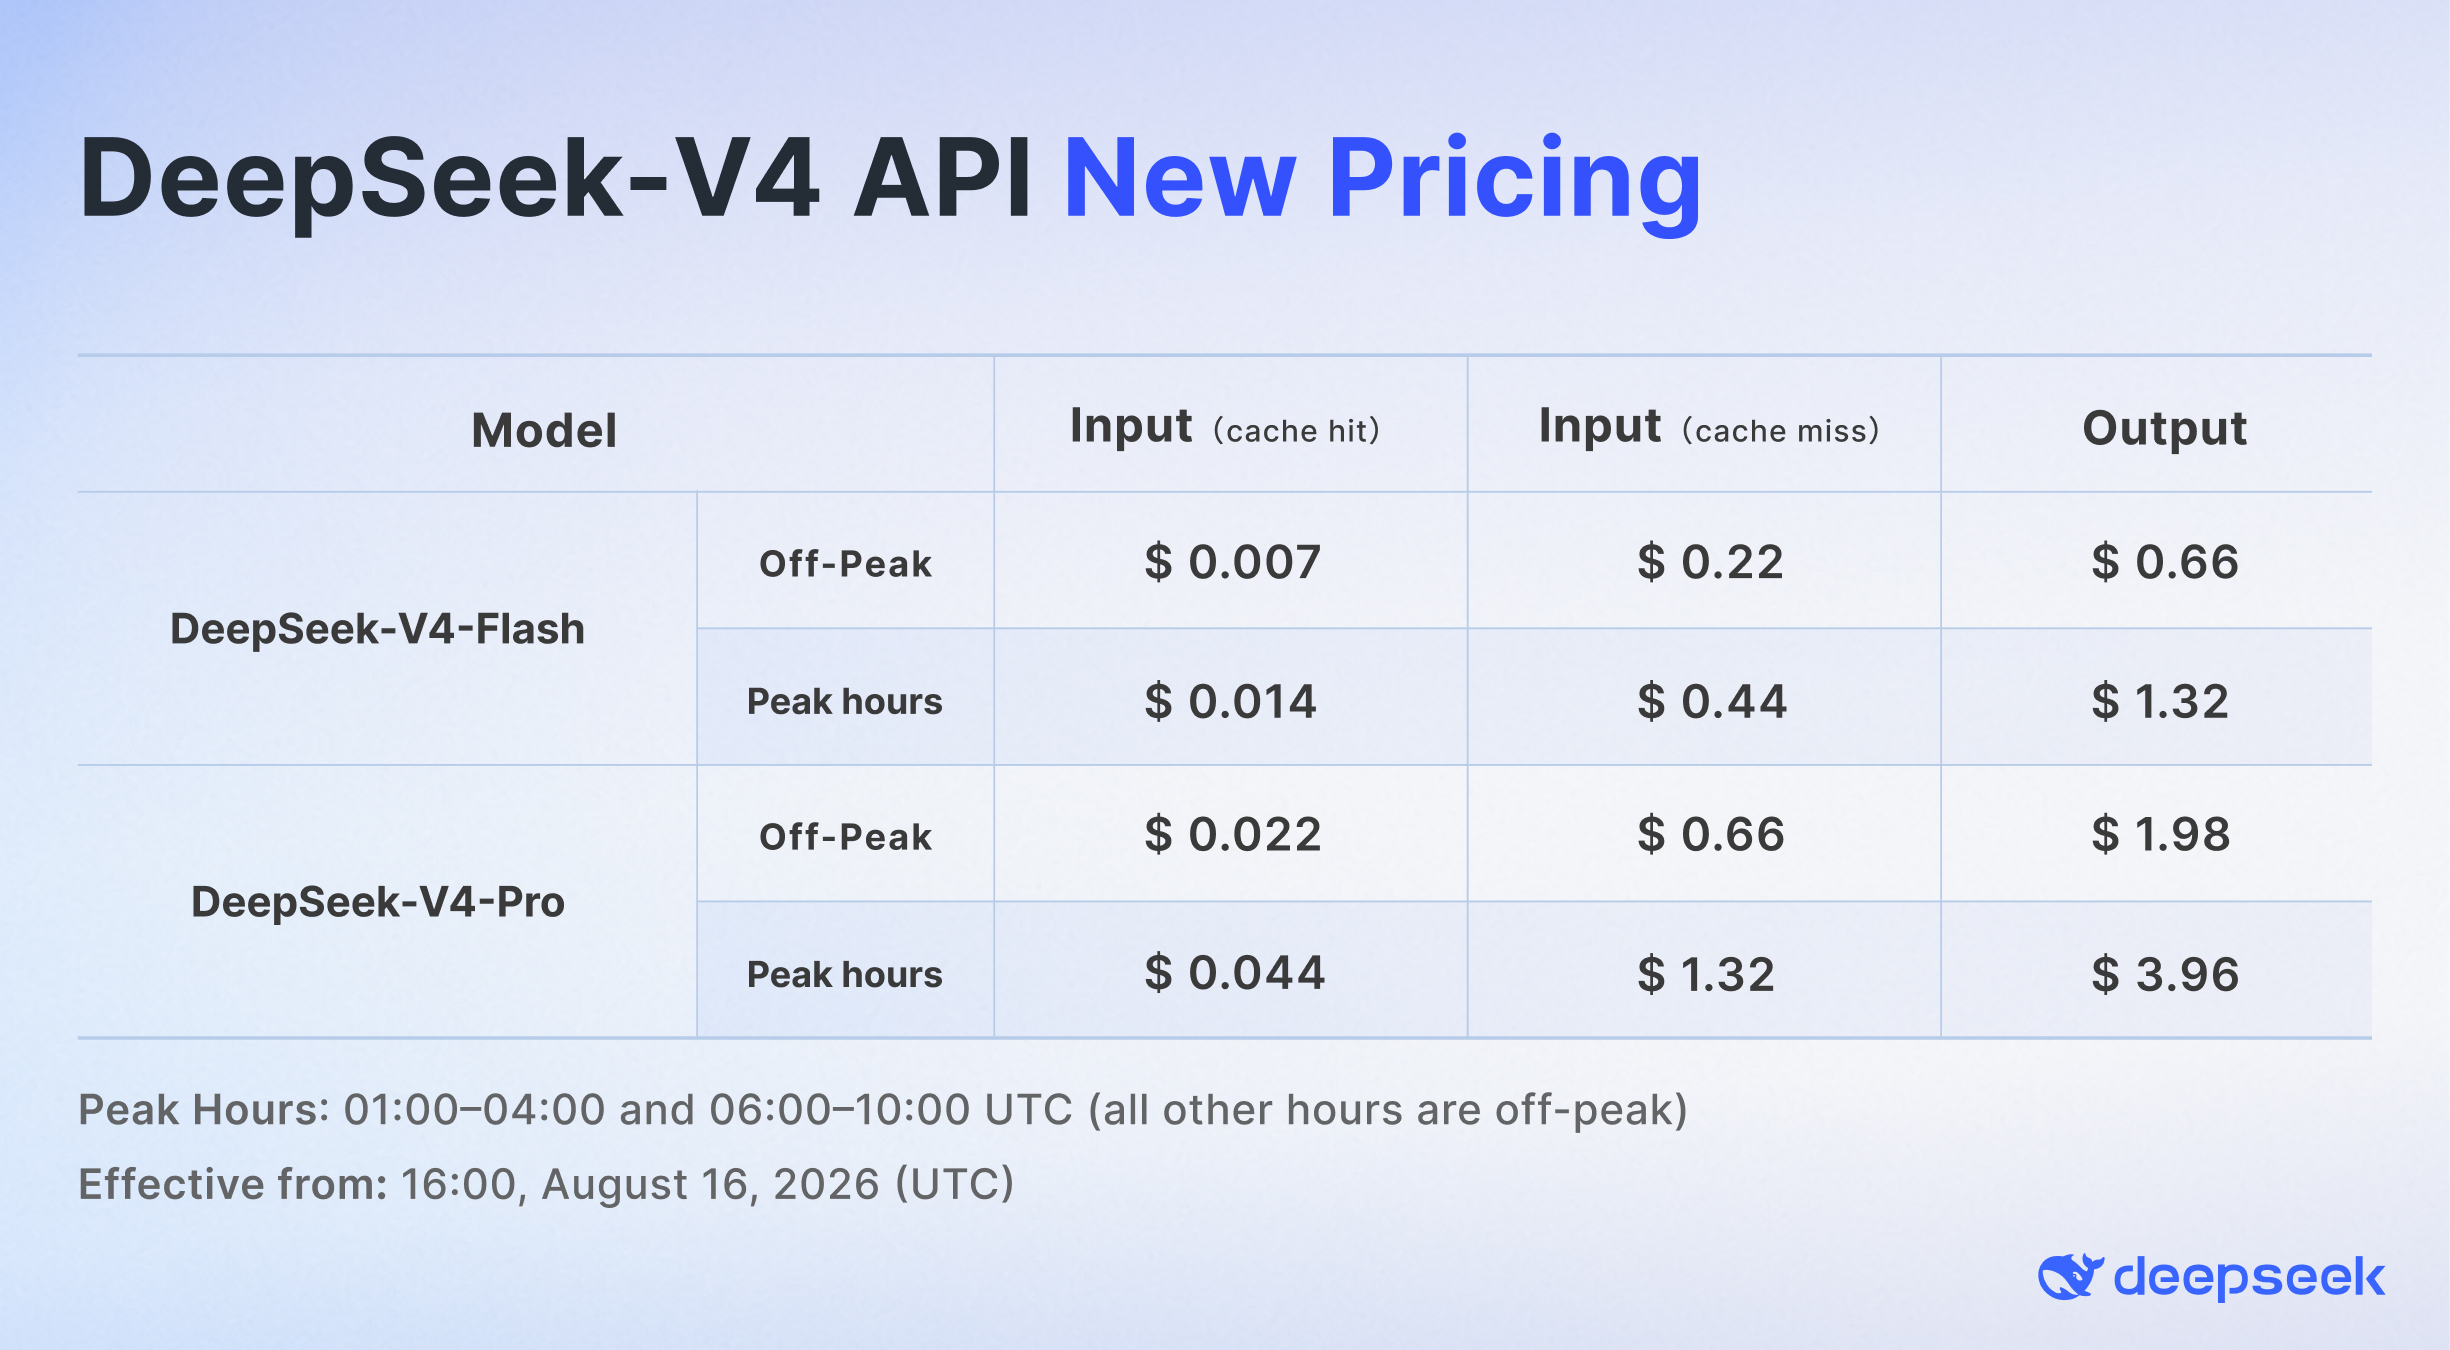
딥시크가 9월 10일 552B MoE 모델 V4.1-Flash를 MIT 라이선스로 공개했습니다. 토큰당 KV 캐시는 V4-Flash의 약 4분의 1이고, 오프피크 요금은 캐시 적중 입력 0.003달러, 출력 0.6달러로 8월보다 내렸습니다.

같은 값의 Opus 5가 36% 더 쓴 이유, 앤트로픽의 비용 줄이는 법
앤트로픽이 9월 8일 Claude 비용을 성능 손해 없이 줄이는 방법을 공개했습니다. 단가가 같은 Opus 4.8과 Opus 5 사이에서도 옛 프롬프트를 그대로 쓰자 티켓당 비용이 36% 올랐고, 29CM는 같은 캐시 원칙으로 LLM 비용을 64% 줄였습니다.
25% 싸진다던 Fable 5.1, 첫날 결과물에 218달러 청구서
Fable 5.1은 캐시 읽기 값만 100만 토큰당 1달러에서 0.25달러로 내렸습니다. 출시 반나절 만에 게임과 3D 세계 결과물이 올라왔고, 일부는 프롬프트 3번 218달러처럼 비용을 적었습니다. 최고 강도에서는 과제당 비용이 오히려 올랐습니다.
24GB 그래픽카드에 들어가는 'Opus급', 알리바바 Qwen3.8-27B
알리바바가 8월 14일 Qwen3.8-27B 가중치를 Apache 2.0으로 공개했습니다. 파라미터 수와 구조가 4월 Qwen3.6-27B와 똑같은데 DeepSWE는 13.3에서 42.2로 올랐고, 4비트 판은 24GB 그래픽카드에 들어갑니다.

덩치 5.6배에 점수 차 1점… 딥시크, V4-Pro 정식판 내며 요금 인상 예고
딥시크가 8월 13일 V4-Pro 정식판을 앱과 API에 올렸습니다. DeepSWE는 프리뷰 12.8에서 62.7로 올랐지만, 5.6배 작은 플래시 정식판과의 종합 지수 차이는 1.2점이었습니다. 출력 요금은 8월 16일부터 1.98~3.96달러로 오릅니다.
함께 나오는 용어5
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 파라미터모델 안의 숫자(가중치) 개수입니다. '7B'는 70억 개를 가리키고, 대체로 클수록 똑똑하지만 비쌉니다.
- 오픈소스 라이선스공개된 가중치를 누가 어떤 조건으로 쓸 수 있는지 정하는 약관입니다. MIT와 아파치 2.0은 조건 없이 고치고 팔 수 있게 열어 두는 반면, 사용 지역이나 상업 이용에 제한을 붙인 자체 라이선스도 흔합니다. 텐센트 커뮤니티 라이선스는 EU와 영국, 한국을 사용 가능 지역에서 빼 두었다가 아파치 2.0 전환으로 그 조항을 없앴습니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.