
추론 칩
inference chip · ASIC · 가속기
학습보다 서비스 단계의 연산에 맞춰 설계한 전용 칩입니다. 범용 GPU보다 전력당 처리량을 높이는 쪽에 초점이 있고, 모델 가중치를 회로에 새기는 극단적 설계까지 나왔습니다.
‘추론 칩’ 이 나오는 글8
"10만 칩이면 한 시간에도 여러 번 고장" 구글 AI 인프라 총괄의 굿풋론
구글 AI 인프라를 총괄하는 아민 바흐다트가 10월 6일 Training Data에서 가속기 10만 개면 한 시간에도 여러 번 고장 난다며 FLOPS 대신 굿풋을 잰다고 말했습니다. 6개월마다 두 배인 토큰 용량, TPU 8i·8t 분리, 전력망을 기다리는 이유도 설명했습니다.

엔비디아 GPU로 초당 1,107토큰, 에르몬 "더 병렬적인 해법이 이긴다"
확산 모델 연구자 스테파노 에르몬이 9월 18일 No Priors에서 한 번에 여러 토큰을 만드는 확산 언어 모델이 추론에서 유리하다고 말했습니다. 그가 이끄는 Inception의 Mercury 2.5는 엔비디아 GPU에서 초당 1,107토큰을 낸다고 회사가 밝혔습니다.

GLM이 자기를 돌릴 시스템을 짰다, 13일 만에 처리량 3.22배
첫 구동 13일 뒤 처리량은 처음의 3.22배가 됐습니다. 파이썬 GIL 하나 때문에 20% 넘게 벌어지던 성능 차이를 1% 아래로 줄였고, 에이전트가 찾은 정밀도 문제의 수정은 오픈소스 라이브러리 Flash Linear Attention에 병합됐습니다.
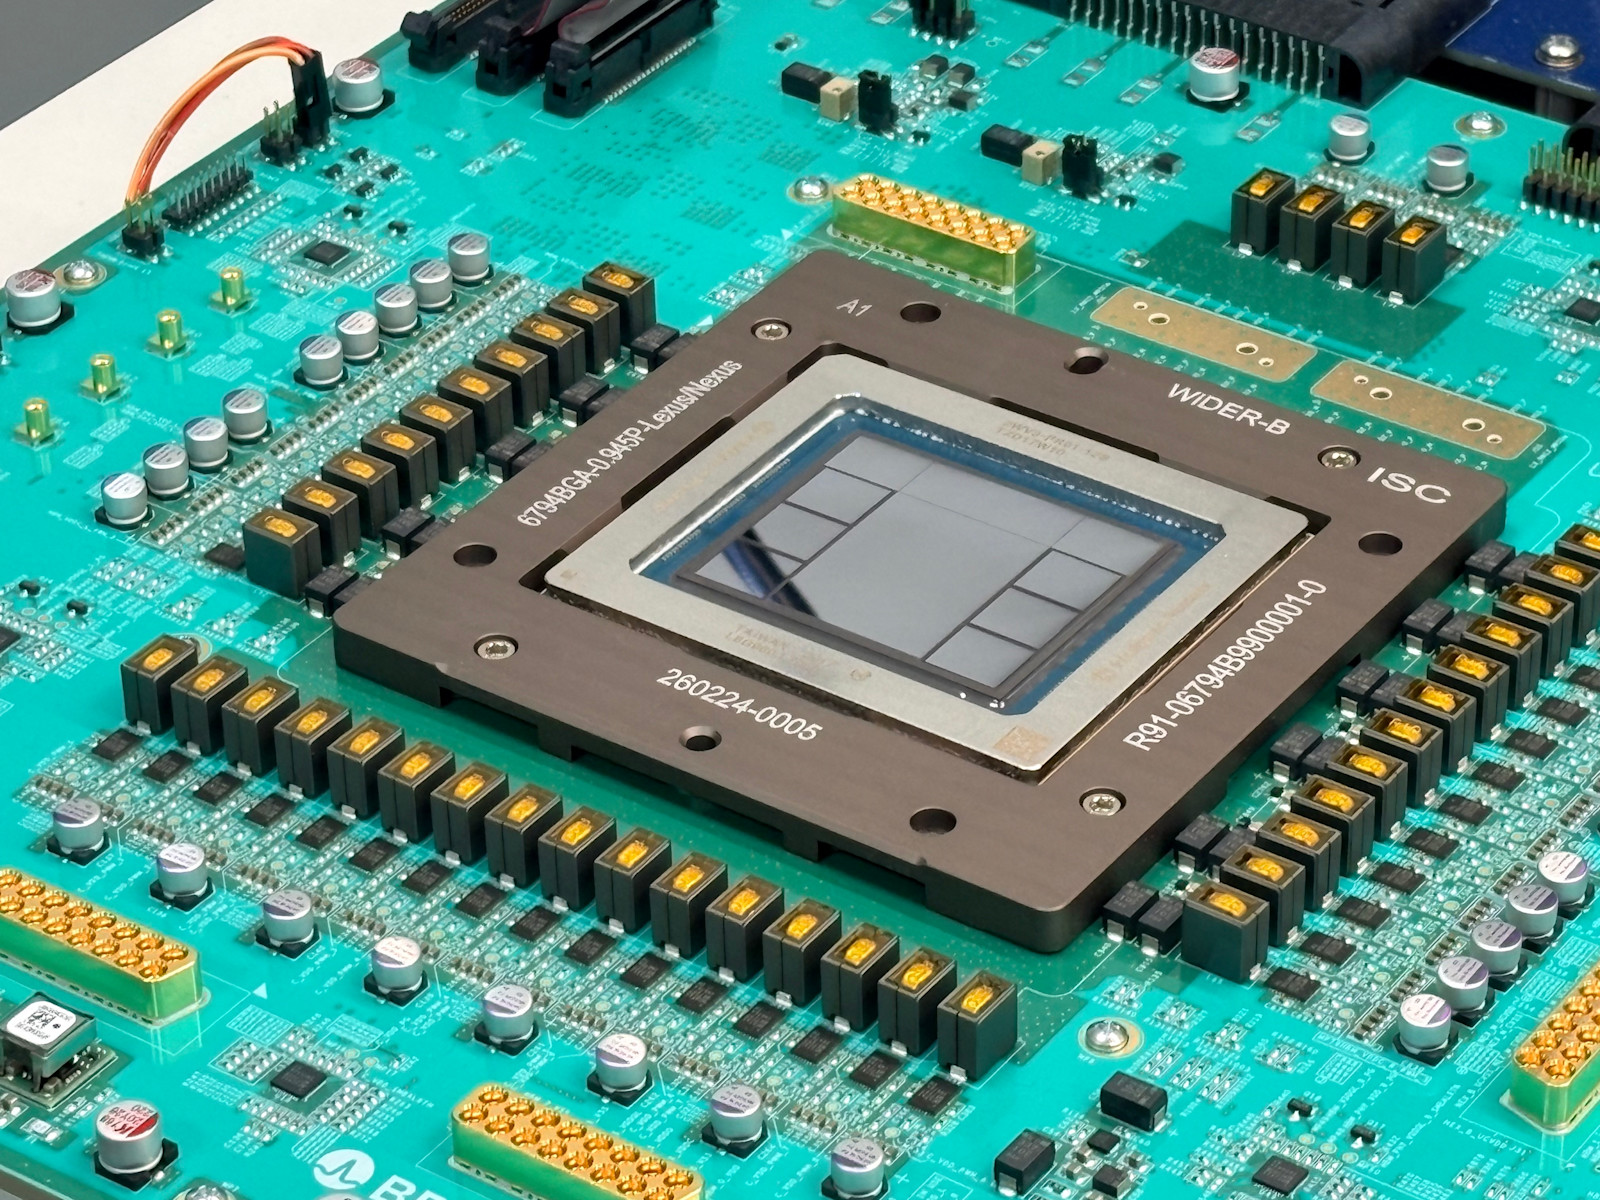
전력당 최대 1.9배, 오픈AI 첫 자체 칩 할라피뇨가 블랙웰을 앞섰습니다
오픈AI가 8월 25일 첫 자체 추론 칩 할라피뇨의 실측을 공개했습니다. 정격 700W로 GB200·GB300보다 전력당 처리량이 1.5~1.9배 많았고 HBM4 6개를 둘렀습니다. 멀티턴 벤치마크는 아직 돌리지 않았습니다.
모델 하나만 돌지만 초당 1만 7,000토큰, AMD가 Taalas를 인수했습니다
AMD가 8월 6일 모델 가중치를 칩 회로에 새기는 Taalas를 인수한다고 발표했습니다. HC1은 Llama 3.1 8B를 초당 1만 6,960토큰으로 돌리고 100만 토큰당 0.75센트라고 회사는 밝혔지만, 칩 한 장이 모델 하나만 돌립니다.
문샷이 같은 밤에 모델과 커널과 통신 라이브러리를 통째로 풀었습니다
7월 27일 문샷AI가 Kimi K3 가중치 파일 96개(1.56TB)와 기술 보고서, FlashKDA·MoonEP·AgentENV를 같은 날 MIT로 공개했습니다. 발표 때 주장이던 숫자가 파일에서 확인됐고, MoonEP 지원 목록에는 중국산 가속기 진우 PPU가 올라 있습니다.

함께 나오는 용어5
- 추론학습이 끝난 모델을 실제로 돌려 답을 만드는 단계입니다. 비용·속도·지연 시간 이야기는 대부분 여기서 나옵니다.
- 에이전트한 번 답하고 멈추지 않고, 스스로 계획하고 도구를 부르고 결과를 확인하며 여러 단계를 이어가는 AI입니다. 브라우저·터미널·앱을 대신 조작하는 것이 대표 예입니다.
- 토큰모델이 텍스트 등을 나누어 처리하는 단위입니다. 단어 전체, 단어의 일부, 문자나 기호가 토큰으로 나뉠 수 있으며, 같은 문장도 토크나이저와 언어에 따라 개수가 달라집니다. 글자 수와 고정된 비율로 대응하지 않습니다. 입력·출력 토큰 수는 컨텍스트 한도와 API 과금의 기준으로 쓰입니다.
- 어텐션입력의 어느 부분을 얼마나 참고할지 정하는 트랜스포머의 계산 구조입니다. 길이가 늘수록 비용이 빠르게 커져서, 긴 컨텍스트 처리 비용의 대부분이 여기서 나옵니다.
- 처리량일정 시간에 처리하거나 전달한 작업·데이터의 양입니다. 초당 요청 수, 토큰 수, 비트 수처럼 대상과 단위를 함께 표시합니다. 와트당 처리량은 전력까지 나눈 별도의 효율 지표입니다. 많이 처리했다는 사실만으로 결과의 품질이나 장애 뒤에도 남는 유효한 진척이 보장되지는 않습니다.

어려운 말은 풀어서, 매주 한 통
매일 아침 AI 소식도 함께 와요. 언제든 그만 받을 수 있어요.